三个子代理,三份一模一样的系统提示词:Hermes 让它们共用一份缓存
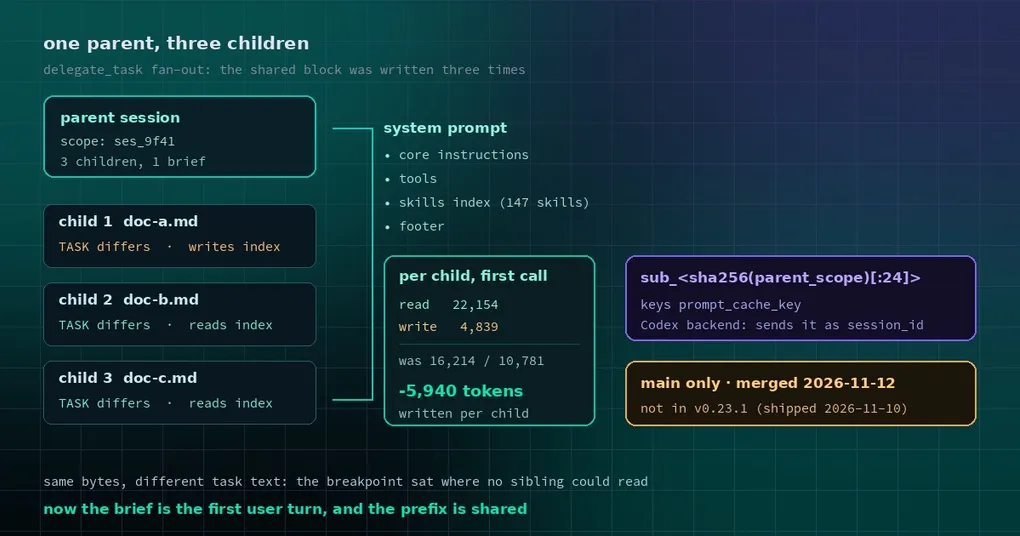
早上打开用量面板,你发现昨天的花费是平时的两倍多。任务量没变,只是那天你让 Hermes 同时派了三个子代理去调研三份文档。三个子代理的任务确实不同,可它们的系统提示词里有很大一块完全相同:核心指令、技能索引、工具定义。而账单上,这三份东西被分别写了一遍。
这不是你的配置问题,是缓存断点放的位置问题。2026 年 11 月 12 日合并的两个 PR(#153385、#153275)把这件事掰正了:兄弟子代理现在共用一份缓存前缀。
先用大白话讲清“提示词缓存”在算什么
主流模型服务商都有一个机制:如果这次请求的前 N 个字节和之前某次请求完全一样,这段可以按“读缓存”计价,价格通常是正常输入价的几分之一;而第一次出现的那段,按“写缓存”计价,略贵于普通输入。
关键约束只有一条:前缀必须逐字节相同。中间多一个空格、多一句话,从那个位置往后全都不算命中。
Hermes 的子代理系统提示词由三段拼成:核心提示词、会话提示词的其余部分(技能索引、页脚说明),以及 delegate_task 在调用 API 时才追加的每任务文本。原来的断点放在核心提示词之后和整段末尾。问题在于:末尾之前那段每任务文本,几乎每个子代理都不一样,于是第二个断点覆盖的字节没有任何兄弟共享,技能索引这块被每个子代理各写了一遍。
改动一:任务文本挪到第一轮用户消息里
这是最根本的一刀。子代理的系统提示词现在只保留兄弟之间完全相同的内容:子代理身份说明、工作区路径、项目约定文件(AGENTS.md / CLAUDE.md)、完成契约。
而任务本身——也就是父代理给的上下文和目标——变成子代理的第一轮用户消息,格式是 CONTEXT: 在前、TASK: 在后:
CONTEXT:
<父代理给的背景材料>

TASK:
<具体任务>为什么是这个顺序?因为同一批子代理经常拿到同一份背景简报,只有目标不同。把背景放前面并注册为“稳定前缀”,它就能单独占一个缓存断点,兄弟之间直接命中。顺带一个细节:这一轮消息在上下文压缩时会被钉住(ContextCompressor.pin_task_turn),否则子代理被 steer 打断、压过一轮之后,它的任务简报会在第二次压缩时被压掉。
改动二:兄弟子代理共用一档缓存作用域
第二个坑更隐蔽。有些后端(比如 OpenAI 系)的自动缓存,只在客户端传来的“缓存作用域”内部匹配;Codex 后端干脆把作用域绑定在请求头 session_id 上。过去每个子代理都用自己的 session id,于是哪怕提示词一字不差,它们也互相看不见。
现在同一个父代理的所有孩子共用一个作用域,值是父作用域再哈希一次:
sub_<sha256(parent_scope)[:24]>
它既作为 prompt_cache_key 参与匹配,在 Codex 后端上也直接顶替了孩子的 session_id 请求头。注意它不是父代理自己的作用域——一棵委派树会新增一个缓存桶,不会挤进父会话的桶里互相干扰。xAI 这类按槽位(slot)分键的路由不使用这个作用域,那里的行为保持不变。
改动三:技能索引的断点往前挪一格
第三个 PR(#153275)解决的是另一头:会话提示词本身。带追加文本的会话,系统提示词现在按三段发送——静态层、会话提示词其余部分、追加文本。
一次请求里能用的缓存断点是有限的(大多数服务商是四个)。第一轮调用只有一个消息要标记,正好省下一个断点,现在这个断点花在“会话提示词的末尾”,也就是技能索引写完的位置。后面每个兄弟子代理读到的就是这一份,不用再写。
数字上(147 个技能的技能库,一个任务文本与兄弟不同的子代理):
| 指标 | 改动前 | 改动后 |
|---|---|---|
| 首轮从缓存读 | 16,214 token | 22,154 token |
| 首轮写入缓存 | 10,781 token | 4,839 token |
| 每个这样的子代理少写 | — | 5,940 token |
真实 delegate_task 子代理的实测(子代理上下文与兄弟不同的首轮调用):
| 路由 / 模型 | 改动前从缓存读 | 改动后从缓存读 |
|---|---|---|
Nous,gpt-5.6-luna |
0 / 7,622 | 7,574 / 7,627 |
Codex 订阅,gpt-5.6-luna |
0 / 7,631 | 7,424 / 7,631 |
Nous,claude-fable-5.2 |
6,354 / 11,904 | 11,761 / 11,909 |
第三行的意思是 Claude 系子代理过去只能共享大约一半提示词,现在几乎整份都能读到缓存——因为系统提示词里再也没有各自不同的任务文本截断前缀了。
你需要做什么:什么都不用配
这次改动没有引入任何新配置键,也没有开关。它是路径优化,不是功能开关:
- 升级到包含这两个 PR 的版本后,
delegate_task的并行 fan-out 自动受益。 - 收益和两件事成正比:技能库越大(技能索引越长)、一次派出的子代理越多(重复前缀被读的次数越多)。
- 系统提示词变短、任务简报进第一轮消息,这件事对所有“API 时追加系统文本”的会话都成立,不只是子代理:CLI 或网关注入的人格设定、API server 的附加指令,走的是同一条路。
- 唯一没动的:直连 Anthropic 且把断点花在 tools 数组上的那套布局。
如果你在算 token 账,可以配合站内另外两篇一起看:上下文 token 优化里讲的压缩策略决定了历史有多少,而多 Profile 共用缓存前缀讲的是另一层作用域问题——那个是网关重启后重复付费,这里是兄弟子代理之间重复写入,两者经常同时出现在一张账单上。
上线状态
两个 PR 都在 2026 年 11 月 12 日合并进 main。v0.23.1 是 11 月 10 日发布的,比合并早了两天,所以这一版里还没有——要么等下一个版本,要么从 main 装。想要确认自己的安装有没有吃到,最直接的办法是派两个任务文本不同的子代理,看首轮请求的缓存读计数是否明显大于写计数。
更新(2026-11-17):这里说的改动已随 v0.23.2 发布(2026-11-16),
hermes update就能拿到。上文「不在 v0.23.1 里」是发布当时的快照。