Três subagents, três system prompts idênticos: agora o Hermes faz eles compartilharem um único cache
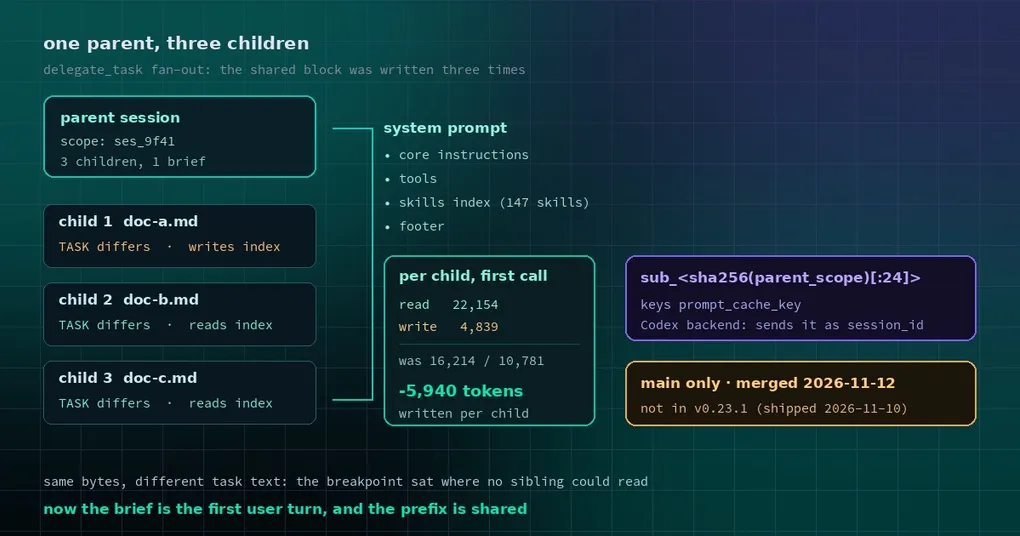
Você abre o dashboard de uso e ontem custou mais que o dobro do normal. A carga era banal: você pediu ao Hermes para distribuir três subagents sobre três documentos. As tarefas eram diferentes, mas boa parte do system prompt de cada filho era idêntica byte a byte — as instruções centrais, o skills index, as definições de ferramentas. Na fatura, esse bloco compartilhado foi escrito três vezes.
Nada estava mal configurado. Os breakpoints de cache estavam simplesmente nos lugares errados. Dois PRs mergeados em 12 de novembro (#153385 e #153275) corrigiram isso: subagents irmãos agora compartilham um único prefixo de cache.
Para que o prompt cache está realmente te cobrando
A maioria dos provedores de modelo faz a mesma coisa. Se os primeiros N bytes desta requisição baterem exatamente com uma requisição anterior, esse trecho é cobrado como leitura de cache — uma fração do preço normal de input. Na primeira vez que aparece, é cobrado como escrita de cache, um pouco acima do input puro.
Uma restrição decide tudo: o prefixo precisa bater byte a byte. Insira uma frase no meio e nada depois desse ponto conta como hit.
O Hermes montava o system prompt de um filho a partir de três peças, nesta ordem: o texto central, o resto do prompt da sessão (skills index, footer) e o texto por tarefa que o delegate_task anexa no momento da API. Dois breakpoints ficavam nele — um depois do texto central, outro bem no fim. O problema: o texto por tarefa difere em quase todo filho, então o segundo breakpoint cobria bytes que nenhum irmão compartilhava. Cada filho lia as ferramentas e o texto central do cache e então reescrevia o skills index, que era idêntico para todos eles.
Mudança um: a tarefa vai para o primeiro turno de usuário do filho
Esta é a correção estrutural. O system prompt de um filho agora carrega só o que os irmãos realmente compartilham: a linha de subagent, o path do workspace, os arquivos de contexto do projeto (AGENTS.md / CLAUDE.md) e as instruções de conclusão.
A tarefa em si — o contexto que o pai fornece mais o objetivo — passa a ser o primeiro turno de usuário do filho, com o contexto primeiro:
CONTEXT:
<background material from the parent>

TASK:
<the specific job>
A ordem é intencional. Um pai frequentemente entrega o mesmo briefing a vários filhos e só varia o objetivo, então colocar o contexto primeiro e registrá-lo como prefixo estável da mensagem dá a ele um breakpoint de cache próprio — a parte que todo irmão acerta. Mais um detalhe importa: esse primeiro turno agora fica fixado durante a compactação (ContextCompressor.pin_task_turn). Antes, o compressor parava de proteger os turnos iniciais depois da primeira passada, então um filho que recebesse steering podia perder seu briefing na segunda.
Mudança dois: um cache scope por filhos de um mesmo pai
A segunda falha era mais sutil. Em modelos da família OpenAI, o cache automático só casa dentro do cache scope que o cliente envia; no backend Codex o scope é literalmente o header session_id da requisição. Cada filho enviava seu próprio session id, então mesmo prompts idênticos byte a byte não compartilhavam nada.
Agora todo filho de um mesmo pai compartilha um scope derivado do pai:
sub_<sha256(parent_scope)[:24]>
Ele alimenta o prompt_cache_key e, no backend Codex, substitui o header session_id do próprio filho. Ele deliberadamente não é o scope do pai: uma árvore de delegação adiciona um bucket de cache em vez de entrar no do pai. Rotas com chave por slot (xAI) o ignoram e se comportam como antes.
Mudança três: mover o breakpoint do skills index uma posição para trás
A terceira peça (#153275) corrige a outra ponta — o prompt da sessão em si. Uma sessão com texto anexado agora envia seu system prompt em três partes: tier estático, resto do prompt da sessão, texto anexado.
Uma requisição só tem tantos breakpoints (quatro na maioria dos provedores). Uma primeira chamada tem apenas uma mensagem para marcar, então sobra um — e esse que sobra agora é gasto no fim do prompt da sessão, exatamente onde o skills index termina. Todo irmão posterior lê essa cópia em vez de escrevê-la.
Os números, numa biblioteca de 147 skills, para um filho cujo texto de tarefa difere do irmão:
| Métrica | Antes | Depois |
|---|---|---|
| Leitura de cache na primeira chamada | 16.214 tokens | 22.154 tokens |
| Escrita de cache na primeira chamada | 10.781 tokens | 4.839 tokens |
| Economia por filho assim | — | 5.940 tokens escritos |
Filhos reais de delegate_task, primeira chamada, contexto diferente do irmão:
| Rota, modelo | Antes: leitura do prompt | Depois: leitura do prompt |
|---|---|---|
Nous, gpt-5.6-luna |
0 de 7.622 | 7.574 de 7.627 |
Assinatura Codex, gpt-5.6-luna |
0 de 7.631 | 7.424 de 7.631 |
Nous, claude-fable-5.2 |
6.354 de 11.904 | 11.761 de 11.909 |
A última linha é a interessante: filhos Claude compartilhavam mais ou menos metade do prompt. Agora compartilham quase tudo, porque nenhum texto por tarefa fica no system prompt cortando o prefixo.
O que você precisa fazer: absolutamente nada
Nenhuma chave de config nova, nenhuma flag. É uma otimização de path, não um toggle de feature:
- Atualize para além desses dois PRs e o fan-out paralelo de
delegate_taskse beneficia automaticamente. - O ganho escala com duas coisas: o tamanho da sua biblioteca de skills (índice mais longo) e quantos filhos você dispara de uma vez (mais leituras do mesmo prefixo).
- Mover o briefing para o primeiro turno de usuário vale para toda sessão que adiciona texto no momento da API, não só subagents: uma personality de CLI ou de gateway, instruções de API-server — mesmo path.
- Intocado: o layout direto-Anthropic que gasta um breakpoint no array de ferramentas.
Se você conta tokens, leia isto junto com dois posts relacionados: otimização de tokens de contexto cobre quanto histórico sobrevive à compactação, enquanto compartilhamento de cache entre perfis é o outro problema de scope — pagar duas vezes depois de um restart de gateway, em vez de irmãos reescrevendo o mesmo bloco. Ambos aparecem na mesma fatura.
Status de release
Os dois PRs entraram em main em 12 de novembro de 2026. A v0.23.1 saiu em 10 de novembro — dois dias antes — então ela não está nesse release. Ou espere o próximo ou instale a partir de main. Para checar se a sua instalação tem isso, dispare dois filhos com textos de tarefa diferentes e olhe as contagens de leitura versus escrita de cache na primeira chamada.
Atualização (17/11/2026): essas mudanças saíram na v0.23.2 (16 de novembro): um
hermes updateas traz. O « não está na v0.23.1 » acima é um retrato da data de publicação.
Se você já roda orquestração remota de subagents, combine isto com orquestração de subagents ao vivo e wake em falha de subagent para que economizar dinheiro e não perder resultados sejam tratados juntos.