Seu agente auxiliar foi recusado à meia-noite e o chat pai esperou até você voltar
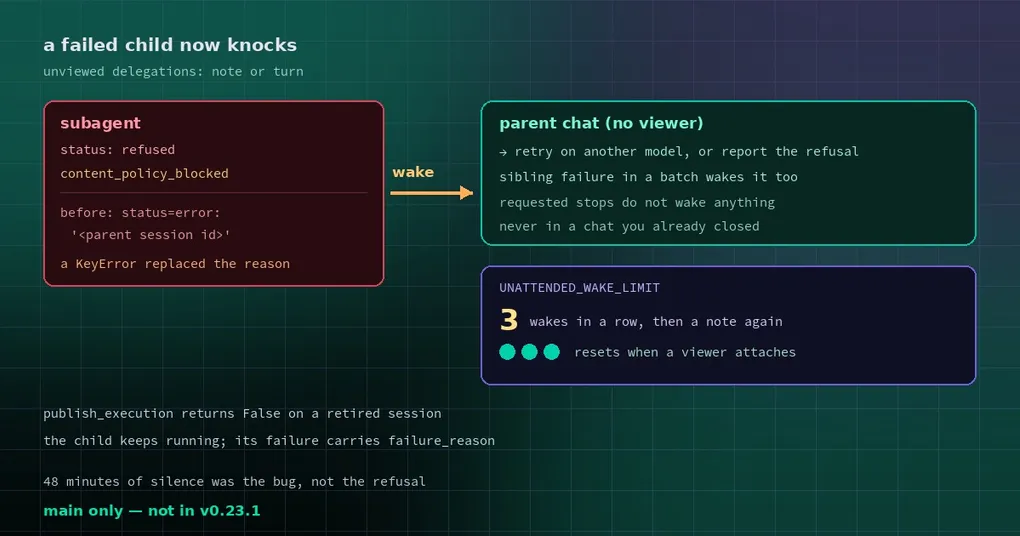
São 23h. Você entrega uma tarefa bagunçada a um subagent em background — roda os testes, corrige o relatório, resume o que encontrou — e fecha o terminal.
Um minuto depois da meia-noite, o filtro de segurança do modelo recusa a requisição: “This content was flagged for possible cybersecurity risk.” O chat pai não ouve nada. Sem erro, sem aviso, sem próximo turno. Seu plano continua exatamente onde estava, e continua lá quando você volta na manhã seguinte, depois de 48 minutos de espera.
Pior: quando você vai olhar, o motivo não é nem o real. O pai recebeu status=error: '<parent session id>' — um session ID no lugar onde deveria estar o motivo da falha.
Dois bugs empilhados
Isso exigiu dois defeitos independentes. Qualquer um dos dois, sozinho, teria sido sobrevivível.
Um: a recusa real foi trocada por um KeyError. O filho herda o print sink do turno do pai (tools/delegate_tool.py copia _print_fn). Quando a sessão viva do pai já tinha sido aposentada, SessionAuthority.publish_execution indexava self.sessions[session_id] antes da sua generation fence. O próximo print de status do filho então levantava KeyError('<parent session id>'), e isso matava o filho. O pai recebeu esse session ID como motivo da falha, em vez de content_policy_blocked.
Dois: a falha nunca acordava o pai. Sem nenhum viewer conectado, a conclusão de um filho é gravada no histórico da sessão como uma nota, e a admissão se resolve sem chamada ao modelo. Para “um resultado que você pode ler depois”, é a decisão certa — economiza uma chamada ao modelo e evita que um agent converse consigo mesmo às 3 da manhã. Para “um filho que falhou e pelo qual o pai está esperando”, é exatamente o contrário: o pai deveria ganhar um turno para tentar de novo em outro modelo, ou para te avisar que foi recusado.
O fix: bater na porta, no máximo três vezes
Duas mudanças, uma por bug.
publish_execution em uma sessão aposentada devolve False em vez de levantar exceção. Essa já é a resposta que a generation fence dá a um callback atrasado de um sink que sobreviveu ao seu claim; agora o índice também está protegido. O filho segue rodando, a falha dele carrega o failure_reason classificado, e a exceção em si vai para o log com traceback.
Um resultado de delegation que falhou roda como turno do pai mesmo sem viewer. A decisão mora em delegation_wakes_parent() (tools/process_registry_notifications.py):
def delegation_wakes_parent(evt: dict) -> bool:
    """True for an async delegation's FINAL result with a failed child (any status other than done or a
    requested stop). Its unviewed local parent runs it as a turn rather than a note ..."""
    if evt.get("type") != "async_delegation" or evt.get("task_failure_notice"):
        return False
    if evt.get("_sibling_failed"):
        return True
    if evt.get("role") == "cron_run":
        return False
    ...
    return any(
        (r.get("status") or ("failed" if r.get("error") else "completed")) not in (*_DONE, *stopped)
        for r in results)
Alguns detalhes pesam:
- Só o resultado final conta (
type == "async_delegation", não otask_failure_noticeantecipado). O aviso de diagnóstico por tarefa nunca acorda nada, então um batch não fica interrompendo o pai. - Um stop solicitado —
interrupted,cancelled— não é falha. Se você ou o usuário parou, o pai não tem nada a recuperar. - Em um batch coalescido, um irmão que falhou acorda o pai tanto quanto um primário que falhou (
_sibling_failed); sem isso, uma tarefa pequena morrendo deixa o pai esperando. - O role
cron_runfica de fora: uma execução de cron disparada manualmente produz texto finalizado, tratado como nota, igual a uma agendada.
A terceira peça é um freio. Um pai acordado que redispara na mesma falha imediatamente (billing, um limite de uso) acordaria a si mesmo para sempre, então gateway/session_completion_notes.py define:
UNATTENDED_WAKE_LIMIT = 3Depois de três wakes a falha volta a ser nota, até um viewer se conectar ou o usuário mandar algo (o que zera o contador). Há mais um limite: nada de wake em um chat que o viewer já fechou (exit ou /new, via refused_for_session), porque um re-dispatch ali seria recusado em background e acabaria rodando dentro do turno do wake.
O que muda na prática
| Situação | Antes | Agora |
|---|---|---|
| Background subagent dá certo, ninguém olhando | Nota silenciosa, lida na sua próxima mensagem | Sem mudança |
| Background subagent falha (recusa, timeout, erro), ninguém olhando | Nota silenciosa, o pai não diz nada | O pai roda um turno: tenta de novo ou reporta o motivo |
| Você está olhando | Turno normal | Sem mudança |
Você já deu /new ou saiu daquele chat |
— | Sem wake (o trabalho cairia na conversa errada) |
| Mesma falha se repetindo | — | No máximo três wakes, depois uma nota |
O resultado prático: um job que quebrou de madrugada agora te deixa um turno dizendo “tentei, falhou, o motivo é este, e eu já tentei de novo em outro modelo” em vez de um beco sem saída silencioso.
O padrão por trás desse bug
Vale dizer à parte, porque não é específico de subagents: caminhos de falha em workflows assíncronos perdem informação muito mais fácil do que caminhos de sucesso. O sucesso alguém lê, então um bug ali é notado na hora. A falha fica sem leitura, então o bug se esconde — até o dia em que você por acaso está esperando exatamente aquele resultado.
Três perguntas para fazer à sua própria automação:
- Uma falha em background tem um destinatário explícito, ou só um lugar onde ela é gravada para depois?
- O motivo da falha pode ser sobrescrito por uma exceção de efeito colateral na saída? (Aqui um
KeyErrorsubstituiucontent_policy_blocked.) - A autorrecuperação tem um teto? Self-healing ilimitado vira incidente de billing durante uma indisponibilidade persistente.
Status e o que fazer enquanto isso
O PR #149568 foi merged em 2026-11-10 às 15:48 UTC; a tag v0.23.1 para em um commit de 11-10 00:24 UTC. Então o fix está só na main — instalações a partir do código que acompanham a main têm, v0.23.1 e anteriores não.
Atualização (17/11/2026): essas mudanças saíram na v0.23.2 (16 de novembro): um
hermes updateas traz. O « não está na v0.23.1 » acima é um retrato da data de publicação.
Até o próximo release, a mitigação prática é: não deixe uma delegation crítica totalmente sem supervisão. Ou torne a espera explícita (um cron job pequeno que volta e pergunta alguns minutos depois), ou instrua o subagent no prompt de que ele deve sempre responder com uma linha, mesmo em caso de falha — transforme silêncio em texto.
Para ir mais fundo nessa camada: orquestração de subagents ao vivo cobre a superfície de controle list/steer/stop do delegate_task, tratamento e recuperação de erros explica a classificação de erros e a escada de retry do Hermes, e aprovações sem supervisão cobre o outro travamento clássico do “não tem ninguém aqui”.