Votre agent auxiliaire a été refusé à minuit ; le chat parent a attendu votre retour
Il est 23 h. Vous confiez une tâche ingrate à un subagent en arrière-plan — lancer les tests, corriger le rapport, résumer ce qu’il a trouvé — puis vous fermez le terminal.
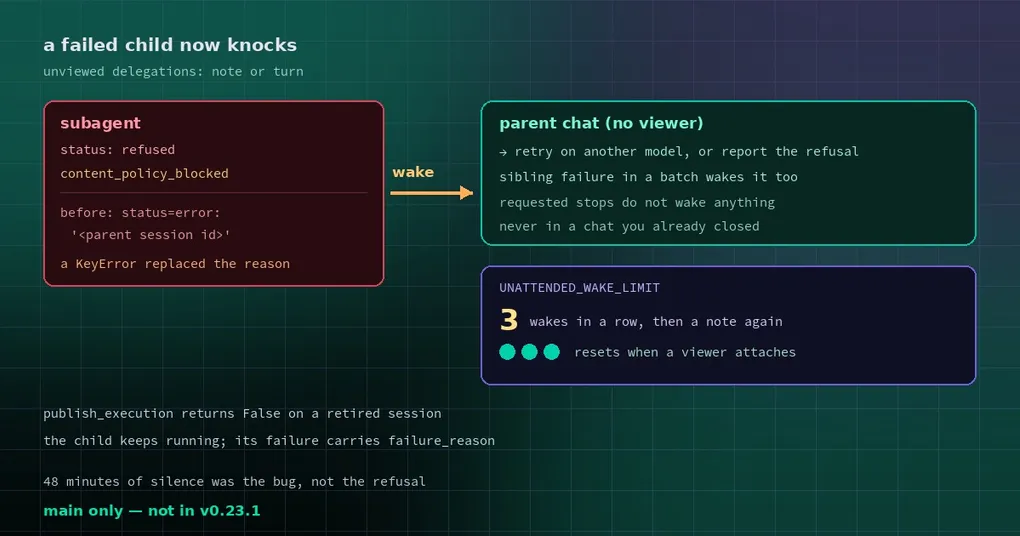
Une minute après minuit, le filtre de sécurité du modèle refuse la requête : « This content was flagged for possible cybersecurity risk. » Le chat parent n’entend rien. Pas d’erreur, pas d’avis, pas de tour suivant. Votre plan reste exactement là où il était, et il y est toujours le lendemain matin, après 48 minutes d’attente.
Pire encore : quand vous finissez par regarder, la raison affichée n’est même pas la bonne. Le parent a reçu status=error: '<parent session id>' — un identifiant de session là où devrait se trouver une cause d’échec.
Deux bugs empilés l’un sur l’autre
Il a fallu deux défauts indépendants. Chacun, pris isolément, aurait été survivable.
Un : le vrai refus a été remplacé par un KeyError. L’enfant hérite du print sink du tour parent (tools/delegate_tool.py copie _print_fn). Or, une fois la session live du parent retirée, SessionAuthority.publish_execution indexait self.sessions[session_id] avant sa barrière de génération. Le print de statut suivant de l’enfant a donc levé KeyError('<parent session id>'), ce qui a tué l’enfant. Le parent a reçu cet identifiant de session comme motif d’échec, à la place de content_policy_blocked.
Deux : l’échec n’a jamais réveillé le parent. Sans spectateur attaché, l’achèvement d’un enfant est écrit dans l’historique de session sous forme de note, et l’admission se règle sans appel au modèle. Pour un « résultat que vous lirez plus tard », c’est le bon choix : cela économise un appel modèle et empêche un agent de se parler à lui-même à 3 h du matin. Pour « un enfant en échec que le parent attend », c’est exactement l’inverse : le parent devrait disposer d’un tour pour réessayer sur un autre modèle, ou pour vous prévenir du refus.
Le correctif : frapper à la porte, trois fois au maximum
Deux changements, un par bug.
publish_execution sur une session retirée renvoie False au lieu de lever une exception. C’est déjà la réponse que la barrière de génération offre à un callback tardif venu d’un sink qui a survécu à sa claim ; désormais l’index est protégé lui aussi. L’enfant continue de tourner, son échec porte le failure_reason classifié, et l’exception elle-même est journalisée avec une traceback.
Un résultat de délégation en échec s’exécute comme tour du parent même sans spectateur. La décision se trouve dans delegation_wakes_parent() (tools/process_registry_notifications.py) :
def delegation_wakes_parent(evt: dict) -> bool:
    """True for an async delegation's FINAL result with a failed child (any status other than done or a
    requested stop). Its unviewed local parent runs it as a turn rather than a note ..."""
    if evt.get("type") != "async_delegation" or evt.get("task_failure_notice"):
        return False
    if evt.get("_sibling_failed"):
        return True
    if evt.get("role") == "cron_run":
        return False
    ...
    return any(
        (r.get("status") or ("failed" if r.get("error") else "completed")) not in (*_DONE, *stopped)
        for r in results)
Quelques détails pèsent lourd :
- Seul le résultat final compte (
type == "async_delegation", pas l’avis précocetask_failure_notice). L’avis de diagnostic par tâche ne réveille jamais rien, pour qu’un lot n’interrompe pas son parent sans arrêt. - Un arrêt demandé —
interrupted,cancelled— n’est pas un échec. Si vous ou l’utilisateur l’avez stoppé, le parent n’a rien à récupérer. - Dans un lot coalescé, un voisin en échec réveille le parent au même titre qu’un primaire en échec (
_sibling_failed) ; sinon, une petite tâche qui meurt laisserait le parent en attente. - Le rôle
cron_runest exclu : une exécution cron déclenchée à la main produit un texte fini, traité comme une note, exactement comme une exécution planifiée.
La troisième pièce est un frein. Un parent réveillé qui relance aussitôt vers le même échec (facturation, limite d’usage) se réveillerait indéfiniment, donc gateway/session_completion_notes.py définit :
UNATTENDED_WAKE_LIMIT = 3Au-delà de trois réveils, l’échec redevient une note, jusqu’à ce qu’un spectateur s’attache ou que l’utilisateur envoie quelque chose (ce qui remet le compteur à zéro). Il existe une dernière limite : pas de réveil dans un chat que son spectateur a déjà fermé (sortie ou /new, via refused_for_session), car une relance y serait refusée en arrière-plan et finirait par s’exécuter à l’intérieur du tour de réveil.
Ce qui change concrètement
| Situation | Avant | Maintenant |
|---|---|---|
| Le subagent en arrière-plan réussit, personne ne regarde | Note silencieuse, lue à votre prochain message | Inchangé |
| Le subagent en arrière-plan échoue (refus, timeout, erreur), personne ne regarde | Note silencieuse, le parent ne dit rien | Le parent exécute un tour : réessai ou rapport de la cause |
| Vous regardez | Tour normal | Inchangé |
Vous avez déjà fait /new ou fermé ce chat |
— | Aucun réveil (le travail atterrirait dans la mauvaise conversation) |
| Le même échec se répète | — | Trois réveils au maximum, puis une note |
Résultat pratique : une tâche qui a cassé pendant la nuit vous laisse désormais un tour du type « il a essayé, il a échoué, voici pourquoi, et j’ai déjà relancé sur un autre modèle » au lieu d’un cul-de-sac silencieux.
Le schéma derrière ce bug
Cela mérite d’être dit à part, car ce n’est pas propre aux subagents : les chemins d’échec des workflows asynchrones perdent l’information bien plus facilement que les chemins de succès. Le succès est lu par quelqu’un, donc un bug y est repéré immédiatement. L’échec n’est pas lu, alors le bug se cache — jusqu’au jour où vous attendez précisément ce résultat.
Trois questions à poser à votre propre automatisation :
- Un échec en arrière-plan a-t-il un destinataire explicite, ou seulement un endroit où il est écrit pour plus tard ?
- La cause de l’échec peut-elle être écrasée par une exception d’effet de bord sur le chemin de sortie ? (Ici, un
KeyErrora remplacécontent_policy_blocked.) - L’auto-récupération a-t-elle un plafond ? Une auto-guérison illimitée se transforme en incident de facturation pendant une panne persistante.
État des lieux et que faire en attendant
La PR #149568 a été fusionnée le 2026-11-10 à 15:48 UTC ; le tag v0.23.1 s’arrête à un commit du 11-10 00:24 UTC. Le correctif n’existe donc que sur main — les installations depuis les sources qui suivent main l’ont, la v0.23.1 et les versions antérieures non.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.
Jusqu’à la prochaine release, l’atténuation pratique consiste à ne pas laisser une délégation critique totalement sans surveillance. Soit vous rendez l’attente explicite (un petit job cron qui revient poser la question quelques minutes plus tard), soit vous imposez au subagent dans son prompt de toujours répondre en une ligne, même en cas d’échec — transformez le silence en texte.
Pour creuser cette couche : l’orchestration de subagents en direct détaille la surface de contrôle list/steer/stop de delegate_task, la gestion et la récupération des erreurs explique la classification des erreurs et l’échelle de retry d’Hermes, et les approbations sans surveillance couvre l’autre blocage classique du « personne n’est là ».