Tu agente auxiliar fue rechazado a medianoche y el chat padre esperó hasta que volviste
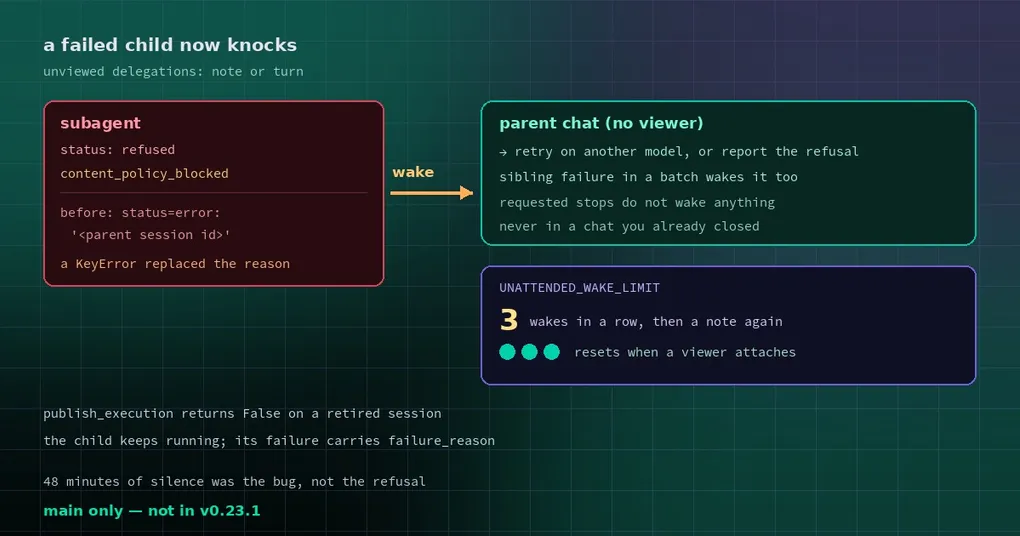
Son las 11 de la noche. Le pasas un trabajo desordenado a un subagent en segundo plano —corre los tests, arregla el informe, resume lo que encontró— y cierras la terminal.
Un minuto después de medianoche, el filtro de seguridad del modelo rechaza la petición: «This content was flagged for possible cybersecurity risk.» El chat padre no se entera de nada. Ni error, ni aviso, ni siguiente turno. Tu plan sigue exactamente donde estaba, y sigue ahí cuando vuelves a la mañana siguiente, después de haber esperado 48 minutos.
Peor todavía: cuando por fin miras, el motivo ni siquiera es el real. El padre recibió status=error: '<parent session id>', un ID de sesión justo donde debería ir la razón del fallo.
Dos bugs apilados uno encima del otro
Hicieron falta dos defectos independientes. Cualquiera de los dos por separado habría sido sobrevivible.
Uno: el rechazo real fue sustituido por un KeyError. El hijo hereda el print sink del turno del padre (tools/delegate_tool.py copia _print_fn). Una vez retirada la sesión viva del padre, SessionAuthority.publish_execution indexaba self.sessions[session_id] antes de su generation fence. El siguiente print de estado del hijo lanzaba por tanto KeyError('<parent session id>'), lo que mataba al hijo. El padre recibió ese ID de sesión como motivo de fallo en lugar de content_policy_blocked.
Dos: el fallo nunca despertó al padre. Sin ningún viewer enganchado, la finalización de un hijo se escribe en el historial de la sesión como nota, y la admisión se resuelve sin llamar al modelo. Para «un resultado que puedes leer más tarde», es la decisión correcta: ahorra una llamada al modelo y evita que un agente se hable a sí mismo a las 3 de la mañana. Para «un hijo que ha fallado y cuyo padre está esperando», es exactamente lo contrario: el padre debería tener un turno para reintentar con otro modelo o para contarte que lo rechazaron.
El arreglo: llamar a la puerta, como mucho tres veces
Dos cambios, uno por bug.
publish_execution sobre una sesión retirada devuelve False en lugar de lanzar. Esa es ya la respuesta que el generation fence da a un callback tardío de un sink que sobrevivió a su claim; ahora el índice también queda protegido. El hijo sigue corriendo, su fallo lleva el failure_reason clasificado, y la excepción en sí se registra con traceback.
Un resultado de delegation fallido se ejecuta como turno del padre aunque no haya ningún viewer. La decisión vive en delegation_wakes_parent() (tools/process_registry_notifications.py):
def delegation_wakes_parent(evt: dict) -> bool:
    """True for an async delegation's FINAL result with a failed child (any status other than done or a
    requested stop). Its unviewed local parent runs it as a turn rather than a note ..."""
    if evt.get("type") != "async_delegation" or evt.get("task_failure_notice"):
        return False
    if evt.get("_sibling_failed"):
        return True
    if evt.get("role") == "cron_run":
        return False
    ...
    return any(
        (r.get("status") or ("failed" if r.get("error") else "completed")) not in (*_DONE, *stopped)
        for r in results)
Unos cuantos detalles pesan:
- Solo cuenta el resultado final (
type == "async_delegation", no eltask_failure_noticetemprano). El aviso de diagnóstico por tarea nunca despierta nada, así que un lote no se pasa la vida interrumpiendo a su padre. - Una parada pedida —
interrupted,cancelled— no es un fallo. Si la paraste tú o el usuario, el padre no tiene nada que recuperar. - En un lote coalescido, un hermano fallido despierta al padre igual que lo hace un primario fallido (
_sibling_failed); si no, una tarea pequeña que muere deja al padre esperando. - El rol
cron_runqueda excluido: una ejecución de cron lanzada a mano produce texto terminado, que se trata como nota igual que la de una programada.
La tercera pieza es un freno. Un padre despertado que se relanza de inmediato hacia el mismo fallo (facturación, un límite de uso) se despertaría a sí mismo para siempre, así que gateway/session_completion_notes.py define:
UNATTENDED_WAKE_LIMIT = 3Pasados tres despertares, el fallo vuelve a ser una nota, hasta que se enganche un viewer o el usuario envíe algo (lo que reinicia el contador). Hay una frontera más: no hay despertar en un chat que su viewer ya cerró (salida o /new, vía refused_for_session), porque un relanzamiento ahí se rechazaría por falta de background y terminaría corriendo dentro del propio turno de despertar.
Qué cambia en la práctica
| Situación | Antes | Ahora |
|---|---|---|
| El subagent en segundo plano termina bien y no hay nadie mirando | Nota silenciosa, la lees en tu siguiente mensaje | Sin cambios |
| El subagent en segundo plano falla (rechazo, timeout, error) y no hay nadie mirando | Nota silenciosa, el padre no dice nada | El padre ejecuta un turno: reintenta o cuenta el motivo |
| Estás mirando | Turno normal | Sin cambios |
Ya hiciste /new o saliste de ese chat |
— | No hay despertar (el trabajo acabaría en la conversación equivocada) |
| El mismo fallo se repite | — | Como máximo tres despertares y luego una nota |
El resultado práctico: un trabajo que se rompió de madrugada ahora te deja un turno que dice «lo intentó, falló, esta es la razón y ya reintenté con otro modelo» en lugar de un callejón sin salida en silencio.
El patrón que hay detrás de este bug
Merece la pena decirlo aparte, porque no es específico de los subagents: las rutas de fallo en flujos asíncronos pierden información mucho más fácilmente que las rutas de éxito. El éxito lo lee alguien, así que un bug ahí se nota enseguida. El fallo no lo lee nadie, así que el bug se esconde: hasta el día en que justamente estás esperando ese resultado.
Tres preguntas que hacerle a tu propia automatización:
- ¿Un fallo en segundo plano tiene un destinatario explícito, o solo un sitio donde se escribe para más tarde?
- ¿El motivo del fallo puede quedar sobrescrito por una excepción de efecto secundario a la salida? (Aquí un
KeyErrorsustituyó acontent_policy_blocked.) - ¿La auto-recuperación tiene un tope? Un self-healing sin límite se convierte en un incidente de facturación durante una caída persistente.
Estado y qué hacer mientras tanto
El PR #149568 se mergeó el 2026-11-10 a las 15:48 UTC; el tag v0.23.1 se queda en un commit del 11-10 a las 00:24 UTC. Así que el arreglo está solo en main: las instalaciones desde código que siguen main lo tienen, v0.23.1 y anteriores no.
Actualización (17/11/2026): estos cambios salieron en la v0.23.2 (16 de noviembre):
hermes updatelos trae. Lo de «no está en la v0.23.1» es una foto del momento de la publicación.
Hasta la próxima release, la mitigación práctica es: no dejes una delegation crítica completamente sin supervisión. O haces explícita la espera (un pequeño cron job que vuelva a preguntar unos minutos después), o le indicas al subagent en su prompt que debe responder siempre con una línea, incluso cuando falla: convierte el silencio en texto.
Para profundizar en esta capa: orquestación de subagents en vivo cubre la superficie de control list/steer/stop de delegate_task, manejo de errores y recuperación explica la clasificación de errores y la escalera de reintentos de Hermes, y aprobaciones sin supervisión cubre el otro atasco habitual de «aquí no hay nadie».