子代理凌晨被拒了,主会话一直等到你下班才吭声
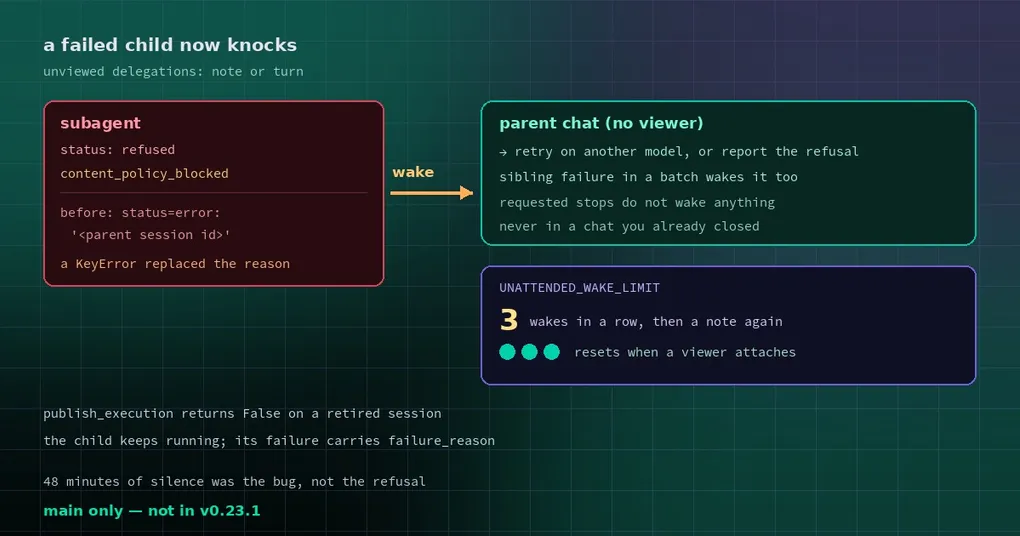
晚上十一点,你把一件麻烦活儿丢给后台子代理:跑测试、修报告、把结果汇总回来。它开始干活,你关掉终端去睡觉。
凌晨十二点零几分,子代理被模型侧的安全策略拒了——一句“This content was flagged for possible cybersecurity risk”。父会话那边却安安静静。没有报错、没有提示、没有下一轮。你的计划就停在那里,一直停到第二天早上你重新坐回桌前,才发现它在“等”你,已经等了 48 分钟。
更气人的是,就算你去看,看到的也不是真实原因:父会话收到的是一个 status=error: '<parent session id>'——一个会话 ID 被当成了失败原因。
两个 bug 叠在一起
这件事由两个独立的缺陷造成,缺一个都不会这么难查。
第一个:拒绝的真实原因被 KeyError 顶掉了。 子代理会继承父轮次的输出回调(tools/delegate_tool.py 里复制 _print_fn)。一旦父会话的那一轮已经结束、会话被回收,SessionAuthority.publish_execution 会先去索引 self.sessions[session_id],然后才检查 generation fence。于是子代理下一次打印状态时抛出 KeyError('<parent session id>'),这个异常把子代理直接干掉了。父会话拿到的失败原因不是 content_policy_blocked,而是那个会话 ID 字符串。
第二个:失败根本没有唤醒父会话。 没有 viewer 挂着的时候,子代理的完成结果会作为一条备注写进会话历史,然后这笔 admission 被直接结算掉,不发起模型调用。对“结果你可以回头再读”的场景,这是对的——省下一次模型调用,避免半夜自己吵自己。但对“父会话正在等的那个子代理失败了”的场景,这是错的:父会话该有机会去重试、换个模型、或者告诉你被拒了。
修法:让失败自己敲门,但最多三次
修复分两处,各自对应一个 bug。
publish_execution 在已回收的会话上返回 False,而不是抛异常。 这本来就是 generation fence 对“迟到的回调”给出的答案,现在索引之前也守住了。子代理继续跑,它的失败带着分类好的 failure_reason 传回去,异常本身也带上 traceback 记进日志。
失败的委派结果在没有 viewer 时也作为父会话的一轮来跑。 判定逻辑在新函数 delegation_wakes_parent()(tools/process_registry_notifications.py):
def delegation_wakes_parent(evt: dict) -> bool:
    """True for an async delegation's FINAL result with a failed child (any status other than done or a
    requested stop). Its unviewed local parent runs it as a turn rather than a note ..."""
    if evt.get("type") != "async_delegation" or evt.get("task_failure_notice"):
        return False
    if evt.get("_sibling_failed"):
        return True
    if evt.get("role") == "cron_run":
        return False
    ...
    return any(
        (r.get("status") or ("failed" if r.get("error") else "completed")) not in (*_DONE, *stopped)
        for r in results)
几个细节值得注意:
- 只看最终结果(
type == "async_delegation"且不是早期的task_failure_notice)。中途那条“某个子任务失败了”的诊断通知不会唤醒任何东西,避免一个批次里反复惊动父会话。 - 被主动停掉的(
interrupted、cancelled)不算失败——你和用户要求停的,不需要父会话去“抢救”。 - 合并批次里,一个兄弟失败和主任务失败同等对待(
_sibling_failed)——否则一批里挂了一个小任务,父会话照样干等。 cron_run角色排除在外:手动触发的 cron 运行产出的是“完成文本”,跟定时运行一样当备注处理。
第三件事是刹车。一个被唤醒的父会话如果立刻重新派发、又撞上同一个失败(账单、用量上限),它会自己把自己唤醒到天荒地老。所以有个上限,gateway/session_completion_notes.py:
UNATTENDED_WAKE_LIMIT = 3超过三次,失败重新变成备注,直到有人挂上来看、或者用户发来新消息(unattended_wakes 归零)。另外有一条边界:在你已经关掉的会话里不唤醒(退出或 /new,refused_for_session),因为那里的重新派发会被拒,反而把活儿塞进唤醒轮次里跑。
你能观察到的变化
对日常使用,行为差异只在这几种情况里能看出来:
| 场景 | 旧行为 | 现在 |
|---|---|---|
| 后台子代理成功,你人不在 | 静默记一条备注,下次你说话时看到 | 不变 |
| 后台子代理失败(被拒、超时、报错),你人不在 | 静默记一条备注,父会话不吭声 | 父会话跑一轮,能重试或告诉你原因 |
| 你在看 | 正常一轮 | 不变 |
你已 /new 或退出该会话 |
— | 不唤醒(避免把活儿塞进新会话) |
| 同一失败连续发生 | — | 最多唤醒三次,之后回到备注 |
结果就是:半夜挂掉的活儿,第二天你打开会话能看到“它试过、失败了、原因是什么,并且我已经换了模型重试过一轮”,而不是一个沉默的断点。
这类 bug 的共性
值得单独说一句,因为它不止出现在子代理上:异步工作流的失败路径,往往比成功路径更容易丢信息。 成功路径有人读结果,所以 bug 会立刻被发现;失败路径没人读,bug 就长期潜伏,直到某天你正好在等那个结果。
判断自己的自动化是否踩过同类坑,问三个问题:
- 后台任务的失败,有没有一个明确的接收者?(还是“写进某处,等人来看”)
- 失败原因的传递链路上,有没有可能被一个副作用异常覆盖?(本例里是
KeyError顶掉content_policy_blocked) - 自动恢复有没有上限?(没有上限的自愈,在持续性故障下会变成账单事故)
状态与升级建议
PR #149568 于 2026-11-10 15:48 UTC 合并,v0.23.1 的 tag 是 11-10 00:24 UTC 的提交,所以这个修复目前只在 main:跟着 main 的源码安装已经生效,v0.23.1 及更早版本没有。
更新(2026-11-17):这里说的改动已随 v0.23.2 发布(2026-11-16),
hermes update就能拿到。上文「不在 v0.23.1 里」是发布当时的快照。
在等到下一个发版之前,实用的缓解办法是:别让关键的委派“无人值守”。要么在派发前把父会话的等待显式化(比如自己起一个定时任务几分钟后回来问一句),要么在子代理的提示词里要求它“失败也必须回答一句话”——把沉默变成文本。
想继续了解这一层,实时子代理编排那篇 讲的是 delegate_task 的 list/steer/stop 控制面,错误处理与恢复那篇 讲 Hermes 的错误分类和重试阶梯,无人值守审批那篇 处理的是另一个“人不在场”的常见卡点。