Dein Helfer-Agent wurde um Mitternacht abgelehnt – der Parent-Chat wartete bis zu deiner Rückkehr
Es ist 23 Uhr. Du gibst einen unordentlichen Job an einen Hintergrund-Subagenten – Tests laufen lassen, den Report reparieren, zusammenfassen, was er gefunden hat – und schließt das Terminal.
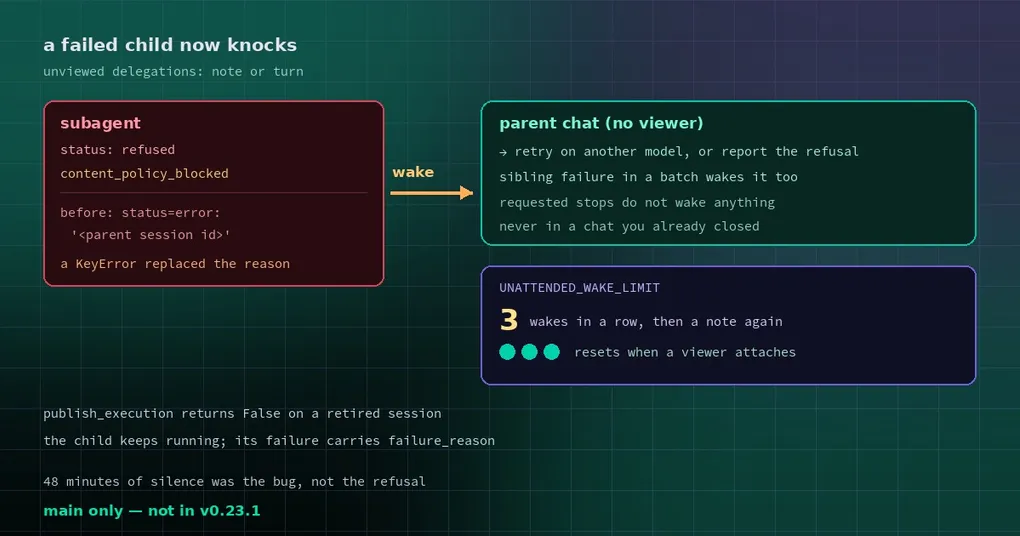
Eine Minute nach Mitternacht lehnt der Safety-Filter des Modells die Anfrage ab: „This content was flagged for possible cybersecurity risk.“ Der Parent-Chat hört nichts. Kein Fehler, kein Hinweis, kein nächster Turn. Dein Plan steht genau da, wo er stand, und er steht immer noch da, als du am nächsten Morgen zurückkommst – 48 Minuten lang gewartet.
Schlimmer noch: Wenn du nachsiehst, ist der Grund nicht einmal der echte. Der Parent bekam status=error: '<parent session id>' – eine Session-ID an der Stelle, an der ein Fehlergrund stehen müsste.
Zwei Bugs, die übereinander liegen
Dafür brauchte es zwei unabhängige Defekte. Jeder für sich wäre überlebbar gewesen.
Erstens: die echte Ablehnung wurde durch einen KeyError ersetzt. Das Kind erbt den Print-Sink des Parent-Turns (tools/delegate_tool.py kopiert _print_fn). Sobald die Live-Session des Parents in den Ruhestand geschickt war, indizierte SessionAuthority.publish_execution self.sessions[session_id] vor seinem Generation-Fence. Der nächste Status-Print des Kindes warf deshalb KeyError('<parent session id>'), was das Kind beendete. Der Parent erhielt diese Session-ID als Fehlergrund statt content_policy_blocked.
Zweitens: der Fehlschlag hat den Parent nie geweckt. Ohne angeschlossenen Viewer wird der Abschluss eines Kindes als Notiz in die Session-History geschrieben, und die Admission wird ohne Modell-Call verbucht. Für „ein Ergebnis, das du später lesen kannst“ ist das die richtige Entscheidung – sie spart einen Modell-Call und verhindert, dass ein Agent um 3 Uhr morgens mit sich selbst redet. Für „ein gescheitertes Kind, auf das der Parent wartet“ ist es genau falsch: Der Parent sollte einen Turn bekommen, um es mit einem anderen Modell erneut zu versuchen oder dir zu sagen, dass die Anfrage abgelehnt wurde.
Der Fix: anklopfen, höchstens dreimal
Zwei Änderungen, eine pro Bug.
publish_execution auf einer pensionierten Session gibt False zurück statt zu werfen. Das ist ohnehin die Antwort, die der Generation-Fence einem späten Callback aus einem Sink gibt, der seinen Claim überlebt hat; jetzt ist auch der Index abgesichert. Das Kind läuft weiter, sein Fehlschlag trägt den klassifizierten failure_reason, und die Exception selbst wird mit Traceback geloggt.
Ein gescheitertes Delegation-Ergebnis läuft auch ohne Viewer als Turn des Parents. Die Entscheidung steckt in delegation_wakes_parent() (tools/process_registry_notifications.py):
def delegation_wakes_parent(evt: dict) -> bool:
    """True for an async delegation's FINAL result with a failed child (any status other than done or a
    requested stop). Its unviewed local parent runs it as a turn rather than a note ..."""
    if evt.get("type") != "async_delegation" or evt.get("task_failure_notice"):
        return False
    if evt.get("_sibling_failed"):
        return True
    if evt.get("role") == "cron_run":
        return False
    ...
    return any(
        (r.get("status") or ("failed" if r.get("error") else "completed")) not in (*_DONE, *stopped)
        for r in results)
Ein paar Details tragen Gewicht:
- Nur das finale Ergebnis zählt (
type == "async_delegation", nicht die frühetask_failure_notice). Die Diagnose-Notiz pro Task weckt nie etwas, damit ein Batch seinen Parent nicht dauernd unterbricht. - Ein angeforderter Stopp –
interrupted,cancelled– ist kein Fehlschlag. Wenn du oder der User abgebrochen hat, gibt es für den Parent nichts zu retten. - In einem zusammengefassten Batch weckt ein gescheitertes Sibling den Parent genauso wie ein gescheitertes Primärziel (
_sibling_failed); sonst lässt ein kleiner sterbender Task den Parent einfach warten. - Die Rolle
cron_runist ausgenommen: Ein manuell ausgelöster Cron-Lauf erzeugt fertigen Text, der wie bei einem geplanten Lauf als Notiz behandelt wird.
Das dritte Teil ist eine Bremse. Ein geweckter Parent, der sofort in denselben Fehlschlag neu dispatcht (Billing, ein Usage-Limit), würde sich ewig selbst wecken, deshalb setzt gateway/session_completion_notes.py:
UNATTENDED_WAKE_LIMIT = 3Nach drei Weckrufen wird der Fehlschlag wieder zur Notiz, bis ein Viewer sich anschließt oder der User etwas sendet (was den Zähler zurücksetzt). Es gibt noch eine Grenze: kein Wecken in einem Chat, den sein Viewer bereits geschlossen hat (Exit oder /new, über refused_for_session), weil ein Re-Dispatch dort im Hintergrund verweigert würde und dann innerhalb des Weck-Turns liefe.
Was sich in der Praxis ändert
| Situation | Vorher | Jetzt |
|---|---|---|
| Hintergrund-Subagent erfolgreich, niemand schaut zu | Stille Notiz, gelesen bei deiner nächsten Nachricht | Unverändert |
| Hintergrund-Subagent scheitert (Ablehnung, Timeout, Fehler), niemand schaut zu | Stille Notiz, der Parent sagt nichts | Parent führt einen Turn aus: neuer Versuch oder Grund melden |
| Du schaust zu | Normaler Turn | Unverändert |
Du hast den Chat schon mit /new verlassen oder geschlossen |
— | Kein Wecken (die Arbeit würde im falschen Gespräch landen) |
| Derselbe Fehler wiederholt sich | — | Höchstens drei Weckrufe, dann eine Notiz |
Das praktische Ergebnis: Ein Job, der über Nacht kaputtging, hinterlässt dir jetzt einen Turn mit „es hat versucht, es ist gescheitert, hier ist der Grund, und ich habe es schon mit einem anderen Modell erneut versucht“ statt einer stillen Sackgasse.
Das Muster hinter diesem Bug
Das lohnt sich separat zu sagen, weil es nicht subagent-spezifisch ist: Fehlerpfade in asynchronen Workflows verlieren viel leichter Informationen als Erfolgspfade. Den Erfolg liest jemand, also fällt ein Bug dort sofort auf. Den Fehlschlag liest niemand, also versteckt sich der Bug – bis zu dem einen Tag, an dem du zufällig genau auf dieses Ergebnis wartest.
Drei Fragen, die du deiner eigenen Automatisierung stellen solltest:
- Hat ein Hintergrund-Fehlschlag einen expliziten Empfänger – oder nur einen Ort, an den er für später geschrieben wird?
- Kann der Fehlergrund unterwegs von einer Side-Effect-Exception überschrieben werden? (Hier hat ein
KeyErrordascontent_policy_blockedersetzt.) - Hat die Auto-Recovery eine Obergrenze? Unbegrenzte Selbstheilung wird bei einem länger andauernden Ausfall zum Billing-Vorfall.
Status und was du bis dahin tun kannst
PR #149568 wurde am 2026-11-10 um 15:48 UTC gemergt; der Tag v0.23.1 endet bei einem Commit vom 11-10 00:24 UTC. Der Fix ist also nur auf main – Source-Installationen, die main tracken, haben ihn, v0.23.1 und älter nicht.
Update (17.11.2026): Diese Änderungen sind mit v0.23.2 (16. November) erschienen – ein
hermes updatebringt sie. Die Formulierung „nicht in v0.23.1“ oben ist eine Momentaufnahme vom Veröffentlichungstag.
Bis zum nächsten Release lautet die praktische Abhilfe: Lass eine kritische Delegation nicht völlig unbeaufsichtigt. Mach das Warten entweder explizit (ein kleiner Cron-Job, der ein paar Minuten später zurückkommt und nachfragt), oder schreib dem Subagenten in seinen Prompt, dass er immer mit einer Zeile antworten muss, auch im Fehlerfall – verwandle Stille in Text.
Wenn du tiefer in diese Schicht willst: Live-Subagent-Orchestrierung beschreibt die Steuerfläche delegate_task mit list/steer/stop, Fehlerbehandlung und Recovery erklärt Hermes’ Fehlerklassifikation und die Retry-Leiter, und unbeaufsichtigte Freigaben behandelt den anderen häufigen Hänger vom Typ „niemand ist da“.