Trois subagents, trois system prompts identiques : Hermes les fait désormais partager un seul cache
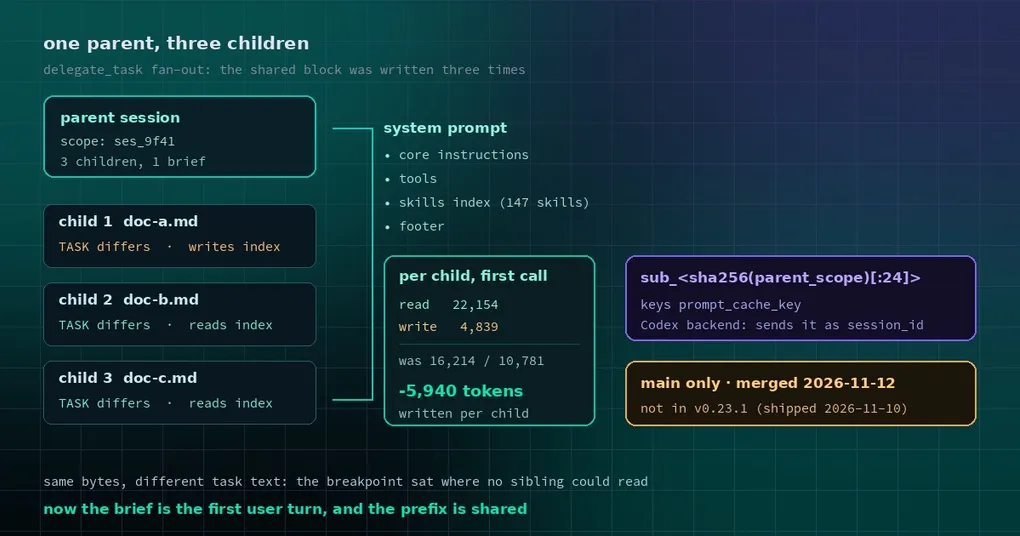
Vous ouvrez le tableau de bord d’usage et la journée d’hier a coûté plus du double de l’habitude. La charge de travail était banale : vous avez demandé à Hermes de répartir trois subagents sur trois documents. Les tâches étaient différentes, mais une grande partie du system prompt de chaque enfant était identique octet pour octet — les instructions de base, le skills index, les définitions d’outils. Sur la facture, ce bloc partagé était écrit trois fois.
Rien n’était mal configuré. Les breakpoints de cache étaient simplement mal placés. Deux PR fusionnées le 12 novembre (#153385 et #153275) corrigent cela : les subagents frères partagent désormais un même préfixe de cache.
Ce que le prompt caching vous facture vraiment
La plupart des fournisseurs de modèles font la même chose. Si les N premiers octets de cette requête correspondent exactement à une requête précédente, ce segment est facturé comme une lecture de cache — une fraction du prix d’entrée normal. La première fois qu’il apparaît, il est facturé comme une écriture de cache, légèrement au-dessus du prix d’entrée brut.
Une seule contrainte décide de tout : le préfixe doit correspondre octet pour octet. Insérez une phrase au milieu et tout ce qui suit ne compte plus comme un hit.
Hermes construisait le system prompt d’un enfant en trois morceaux, dans l’ordre : le texte de base, le reste du prompt de session (skills index, footer), et le texte propre à la tâche que delegate_task ajoute au moment de l’appel API. Deux breakpoints y prenaient place — un après le texte de base, un tout à la fin. Le piège : le texte propre à la tâche diffère pour presque chaque enfant, donc le second breakpoint couvrait des octets qu’aucun frère ne partageait. Chaque enfant lisait les outils et le texte de base depuis le cache, puis réécrivait le skills index, identique pour tous.
Changement un : la tâche passe dans le premier tour utilisateur de l’enfant
C’est la correction structurelle. Le system prompt d’un enfant ne porte plus que ce que les frères partagent réellement : la ligne subagent, le path du workspace, les fichiers de contexte projet (AGENTS.md / CLAUDE.md) et les instructions de complétion.
La tâche elle-même — le contexte fourni par le parent plus l’objectif — devient le premier tour utilisateur de l’enfant, le contexte d’abord :
CONTEXT:
<background material from the parent>

TASK:
<the specific job>
L’ordre est volontaire. Un parent confie souvent le même brief à plusieurs enfants et ne fait varier que l’objectif ; placer le contexte en premier et l’enregistrer comme préfixe stable du message lui donne son propre breakpoint de cache — la partie que tous les frères touchent. Un détail compte encore : ce premier tour est désormais épinglé à travers la compaction (ContextCompressor.pin_task_turn). Avant, le compresseur cessait de protéger les premiers tours après sa première passe, si bien qu’un enfant piloté pouvait perdre son brief à la seconde.
Changement deux : un seul scope de cache pour les enfants d’un même parent
Le second raté était plus subtil. Sur les modèles de la famille OpenAI, le caching automatique ne matche qu’à l’intérieur du scope de cache envoyé par le client ; sur le backend Codex, ce scope est littéralement l’en-tête de requête session_id. Chaque enfant envoyait son propre session id, donc même des prompts identiques octet pour octet ne partageaient rien.
Désormais, tous les enfants d’un même parent partagent un scope dérivé de celui du parent :
sub_<sha256(parent_scope)[:24]>
Il sert de clé à prompt_cache_key et, sur le backend Codex, remplace l’en-tête session_id de l’enfant. Ce n’est délibérément pas le scope du parent : un arbre de délégation ajoute un bucket de cache au lieu de rejoindre celui de son parent. Les routes à clé de slot (xAI) l’ignorent et se comportent comme avant.
Changement trois : le breakpoint du skills index avancé d’un cran
Le troisième volet (#153275) corrige l’autre extrémité — le prompt de session lui-même. Une session avec du texte ajouté envoie maintenant son system prompt en trois parties : palier statique, reste du prompt de session, texte ajouté.
Une requête n’a qu’un nombre limité de breakpoints (quatre chez la plupart des fournisseurs). Un premier appel n’a qu’un seul message à marquer, donc un seul breakpoint de libre — et ce breakpoint est désormais dépensé à la fin du prompt de session, exactement là où se termine le skills index. Chaque frère suivant lit cette copie au lieu de l’écrire.
Les chiffres, sur une bibliothèque de 147 skills, pour un enfant dont le texte de tâche diffère de celui de son frère :
| Métrique | Avant | Après |
|---|---|---|
| Lecture de cache au premier appel | 16,214 tokens | 22,154 tokens |
| Écriture de cache au premier appel | 10,781 tokens | 4,839 tokens |
| Économisé par enfant de ce type | — | 5,940 tokens écrits |
De vrais enfants delegate_task, au premier appel, avec un contexte différent de celui d’un frère :
| Route, modèle | Avant : lecture du prompt | Après : lecture du prompt |
|---|---|---|
Nous, gpt-5.6-luna |
0 sur 7,622 | 7,574 sur 7,627 |
Abonnement Codex, gpt-5.6-luna |
0 sur 7,631 | 7,424 sur 7,631 |
Nous, claude-fable-5.2 |
6,354 sur 11,904 | 11,761 sur 11,909 |
Cette dernière ligne est la plus intéressante : les enfants Claude ne partageaient autrefois qu’environ la moitié de leur prompt. Aujourd’hui ils en partagent presque tout, parce qu’aucun texte propre à la tâche ne vient couper le préfixe dans le system prompt.
Ce que vous avez à faire : rien du tout
Aucune nouvelle clé de config, aucun flag. C’est une optimisation de path, pas un feature toggle :
- Mettez à niveau au-delà de ces deux PR et le fan-out
delegate_taskparallèle en profite automatiquement. - Le gain dépend de deux choses : la taille de votre bibliothèque de skills (index plus long) et le nombre d’enfants lancés en même temps (plus de lectures du même préfixe).
- Le déplacement du brief dans le premier tour utilisateur s’applique à toute session qui ajoute du texte au moment de l’appel API, pas seulement aux subagents : une personnalité CLI ou gateway, des instructions d’API-server — même path.
- Inchangé : la disposition directe Anthropic, qui dépense un breakpoint sur le tableau d’outils.
Si vous comptez les tokens, lisez ceci avec deux articles liés : l’optimisation des tokens de contexte explique quelle part de l’historique survit à la compression, tandis que le partage de cache entre profils traite l’autre problème de scope — payer deux fois après un redémarrage de gateway, plutôt que des frères réécrivant le même bloc. Les deux apparaissent sur la même facture.
Statut de la release
Les deux PR ont été fusionnées dans main le 12 novembre 2026. v0.23.1 est sortie le 10 novembre — deux jours plus tôt — donc elle ne contient pas ce correctif. Attendez la prochaine ou installez depuis main. Pour savoir si votre installation l’a, lancez deux enfants avec des textes de tâche différents et comparez les compteurs de lecture et d’écriture de cache au premier appel.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.
Si vous faites déjà de l’orchestration de subagents distants, complétez avec l’orchestration de subagents en direct et le réveil sur échec de subagent, pour traiter ensemble l’économie de tokens et la non-perte de résultats.