Tres subagentes, tres system prompts idénticos: ahora Hermes les hace compartir una sola cache
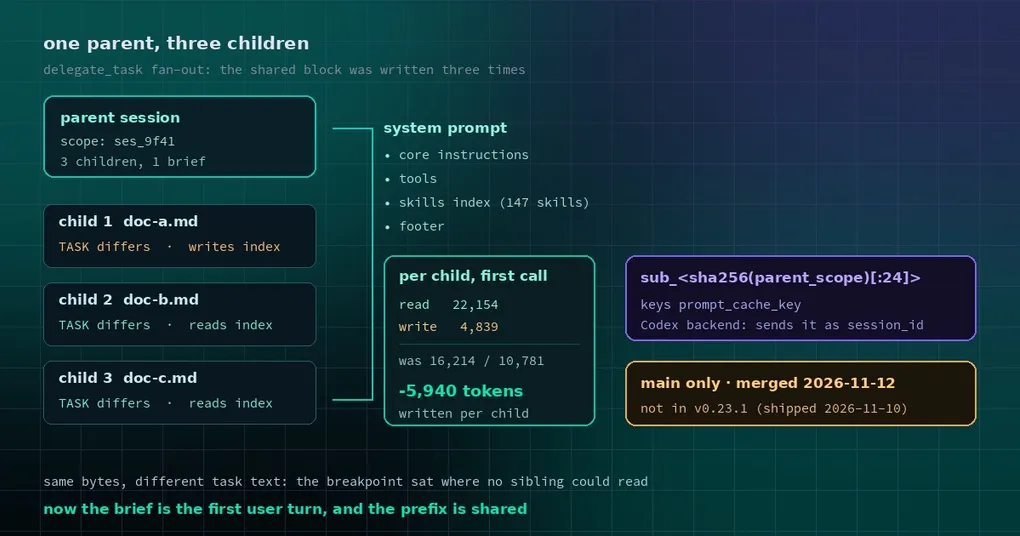
Abres el panel de uso y ayer costó más del doble de lo habitual. La carga de trabajo era normal: pediste a Hermes que repartiera tres subagentes entre tres documentos. Las tareas eran distintas, pero buena parte del system prompt de cada hijo era idéntica byte a byte: las instrucciones base, el skills index, las definiciones de herramientas. En la factura, ese bloque compartido se escribió tres veces.
Nada estaba mal configurado. Los cache breakpoints simplemente estaban en el sitio equivocado. Dos PRs fusionados el 12 de noviembre (#153385 y #153275) lo arreglaron: los subagentes hermanos ahora comparten un mismo prefijo de cache.
Por qué te está cobrando realmente el prompt caching
La mayoría de los proveedores de modelos hacen lo mismo. Si los primeros N bytes de esta petición coinciden exactamente con una petición anterior, ese tramo se factura como una lectura de cache: una fracción del precio normal de entrada. La primera vez que aparece se factura como escritura de cache, algo por encima de la entrada normal.
Una restricción lo decide todo: el prefijo tiene que coincidir byte a byte. Mete una frase en medio y nada de lo que venga después cuenta como acierto.
Hermes construía el system prompt de un hijo con tres piezas, en orden: el texto base, el resto del prompt de sesión (skills index, pie) y el texto específico de la tarea que delegate_task añade en el momento de la llamada a la API. Había dos breakpoints: uno tras el texto base y otro al final del todo. El problema: el texto de la tarea cambia en casi todos los hijos, así que el segundo breakpoint cubría bytes que ningún hermano compartía. Cada hijo leía las herramientas y el texto base de la cache y luego reescribía el skills index, que era idéntico para todos ellos.
Cambio uno: la tarea pasa al primer turno de usuario del hijo
Este es el arreglo estructural. El system prompt de un hijo ahora solo lleva lo que los hermanos comparten de verdad: la línea de subagente, el workspace path, los archivos de contexto del proyecto (AGENTS.md / CLAUDE.md) y las instrucciones de finalización.
La tarea en sí — el contexto que aporta el padre más el objetivo — pasa a ser el primer turno de usuario del hijo, con el contexto primero:
CONTEXT:
<background material from the parent>

TASK:
<the specific job>
El orden es deliberado. A menudo un padre entrega el mismo briefing a varios hijos y solo varía el objetivo, así que poner el contexto primero y registrarlo como prefijo estable del mensaje le da su propio cache breakpoint: la parte que todos los hermanos aciertan. Un detalle más importa: ese primer turno ahora queda fijado durante la compactación (ContextCompressor.pin_task_turn). Antes, el compresor dejaba de proteger los primeros turnos tras su primera pasada, así que un hijo reconducido podía perder su briefing en la segunda.
Cambio dos: un solo cache scope por los hijos de un mismo padre
El segundo fallo era más sutil. En los modelos de la familia OpenAI, el caching automático solo coincide dentro del cache scope que envía el cliente; en el backend Codex el scope es literalmente la cabecera session_id de la petición. Cada hijo enviaba su propio session id, así que incluso prompts idénticos byte a byte no compartían nada.
Ahora todos los hijos de un mismo padre comparten un scope derivado del del padre:
sub_<sha256(parent_scope)[:24]>
Se usa como clave de prompt_cache_key y, en el backend Codex, sustituye la cabecera session_id propia del hijo. Deliberadamente no es el scope del padre: un árbol de delegación añade un bucket de cache en lugar de unirse al de su padre. Las rutas con clave por slot (xAI) lo ignoran y se comportan como antes.
Cambio tres: adelantar un slot el breakpoint del skills index
La tercera pieza (#153275) arregla el otro extremo: el prompt de sesión en sí. Una sesión con texto añadido ahora envía su system prompt en tres partes: nivel estático, resto del prompt de sesión, texto añadido.
Una petición solo tiene un número limitado de breakpoints (cuatro en la mayoría de proveedores). Una primera llamada solo tiene un mensaje que marcar, así que le sobra uno, y ese hueco ahora se gasta al final del prompt de sesión, justo donde termina el skills index. Todos los hermanos posteriores leen esa copia en vez de escribirla.
Las cifras, en una biblioteca de 147 skills, para un hijo cuyo texto de tarea difiere del de su hermano:
| Métrica | Antes | Después |
|---|---|---|
| Lectura de cache en la primera llamada | 16.214 tokens | 22.154 tokens |
| Escritura de cache en la primera llamada | 10.781 tokens | 4.839 tokens |
| Ahorro por cada hijo así | — | 5.940 tokens escritos |
Hijos reales de delegate_task, primera llamada, con un contexto distinto al de un hermano:
| Ruta, modelo | Antes: lectura del prompt | Después: lectura del prompt |
|---|---|---|
Nous, gpt-5.6-luna |
0 de 7.622 | 7.574 de 7.627 |
Codex subscription, gpt-5.6-luna |
0 de 7.631 | 7.424 de 7.631 |
Nous, claude-fable-5.2 |
6.354 de 11.904 | 11.761 de 11.909 |
Esa última fila es la interesante: los hijos Claude solían compartir más o menos la mitad de su prompt. Ahora comparten casi todo, porque ningún texto por tarea se sienta en el system prompt cortando el prefijo.
Qué tienes que hacer: absolutamente nada
Ninguna clave de configuración nueva, ningún flag. Es una optimización de ruta, no un interruptor de funcionalidad:
- Actualiza más allá de estos dos PRs y el fan-out paralelo de
delegate_taskse beneficia automáticamente. - La ganancia escala con dos cosas: lo grande que sea tu biblioteca de skills (índice más largo) y cuántos hijos lances a la vez (más lecturas del mismo prefijo).
- Mover el briefing al primer turno de usuario aplica a toda sesión que añade texto en el momento de la llamada a la API, no solo a los subagentes: una personalidad de CLI o de gateway, instrucciones de API-server, el mismo camino.
- Sin tocar: el layout directo-Anthropic que gasta un breakpoint en el array de herramientas.
Si llevas la cuenta de los tokens, lee esto junto a dos posts relacionados: optimización de tokens de contexto cubre cuánta historia sobrevive a la compresión, mientras que compartir cache entre perfiles es el otro problema de scope: pagar dos veces tras reiniciar el gateway, en lugar de hermanos reescribiendo el mismo bloque. Los dos acaban en la misma factura.
Estado del release
Los dos PRs se fusionaron en main el 12 de noviembre de 2026. La v0.23.1 salió el 10 de noviembre, dos días antes, así que no está en esa release. O esperas a la siguiente o instalas desde main. Para comprobar si tu instalación lo tiene, lanza dos hijos con texto de tarea distinto y mira los contadores de lectura y escritura de cache de la primera llamada.
Actualización (17/11/2026): estos cambios salieron en la v0.23.2 (16 de noviembre):
hermes updatelos trae. Lo de «no está en la v0.23.1» es una foto del momento de la publicación.
Si ya ejecutas orquestación remota de subagentes, combina esto con orquestación de subagentes en vivo y despertar de subagentes fallidos, para que ahorrar dinero y no perder resultados se resuelvan juntos.