Dein Prompt-Cache läuft still ab. Hermes zeigt dir jetzt, wann
Freitagabend lässt du eine lange Refactoring-Session offen. Jeder Turn an diesem Nachmittag war günstig: derselbe System-Prompt mit 40.000 Tokens und der Datei-Kontext gingen einmal hoch, und der Provider berechnete nur einen Bruchteil des Preises dafür, dass du sie noch einmal schickst. Montagmorgen setzt du die Session fort, schickst eine kleine Rückfrage – und die Rechnung für diesen einen Turn sieht aus wie ein ganz frisches Gespräch. An deinem Setup hat sich nichts geändert. Du hast nur keine Ahnung, ob der Cache über das Wochenende abgelaufen ist, ob der Modellwechsel vom Freitag ihn zurückgesetzt hat, oder ob eine Kontext-Compaction still das Prefix umgeschrieben hat, das der Cache noch festhielt.
Genau um diese Ungewissheit geht es hier. Kein neuer Cache, kein neues Provider-Feature – eine Uhr, die festhält, was tatsächlich mit deinem Prompt-Cache passiert ist, und eine einzige Zeile in /context, die dir sagt, wie lange du noch darauf zählen kannst.
Prompt-Caching ist ein Rabatt mit Deadline
Die Idee ist einfach. Provider erlauben dir, einen Teil einer Anfrage als wiederverwendbar zu markieren. Sie behalten das verarbeitete Prefix eine Weile auf ihrer Seite, und wenn die nächste Anfrage mit demselben Prefix beginnt, berechnen sie den gecachten Teil zu einem deutlich niedrigeren Satz, statt ihn erneut zu verarbeiten. In einer langen Agent-Session mit großem System-Prompt, stabilen Tool-Schemas und einem wachsenden Transkript ist dieser Rabatt der größte Posten deiner Rechnung.
Der Haken ist das „eine Weile“. Jeder Provider formuliert es anders:
- Anthropic-Caches laufen standardmäßig nach fünf Minuten ab und lassen sich mit einer Ein-Stunden-Stufe anfordern. Ein Cache-Read startet die Uhr neu.
- Die neueren Modelle von OpenAI nehmen eine explizite
prompt_cache_options.ttl– standardmäßig 30 Minuten, auf Anfrage 12 Stunden. Ein Read hält das 30-Minuten-Minimum, startet aber kein 12-Stunden-Fenster neu. - Ältere OpenAI-Routen und implizite Caches haben überhaupt kein veröffentlichtes Minimum. Sie können Einträge länger behalten als angefordert; niemand verspricht einen exakten Ablauf.
Fällt dir auf, was dir keiner davon gibt? Einen Ablauf-Zeitstempel. Du bekommst eine Mindest-Aufbewahrung. „Fünf Minuten“ heißt „mindestens fünf Minuten“, nicht „weg bei fünf Minuten und einer Sekunde“. Jeder Code, der das als Ablaufdatum behandelt, rät – und Hermes hat früher an jeder Stelle, der es wichtig war, unabhängig geraten.
Was tatsächlich schiefging
Hinter derselben vagen Vorstellung von „der Cache ist vermutlich warm“ steckten zwei verschiedene Probleme.
Das erste waren doppelte Schätzungen. Verschiedene Teile des Agenten leiteten jeweils eigene TTLs ab. Wenn zwei davon sich widersprechen, gewinnt versehentlich die günstigere Variante: du triffst eine Entscheidung in der Annahme von Wärme, die ein anderer Codeteil als kalt bezeichnet hätte.
Das zweite war schlimmer und kostete echtes Geld. Auf dem Nous Portal forderte Hermes die Ein-Stunden-Cache-Stufe an. Das Portal behält den Cache etwa fünf Minuten und wirft ihn dann weg. Hermes zahlte also den höheren Cache-Write-Satz für einen Ein-Stunden-Eintrag, und der Eintrag war verschwunden, bevor der nächste Turn kam. Auf der Leitung stand „1h“, die Realität war „5m“.
PR #156101 behebt beides, indem das Cache-Fenster zu einem festgehaltenen Fakt wird statt zu einer neu berechneten Schätzung.
Eine Uhr, pro Versuch festgehalten
Das neue Modul ist agent/prompt_cache_clock.py. Für jeden erfolgreichen Modell-Versuch, der den Cache berührt hat, hält es ein Event fest:
- die vollständige Route (Provider, normalisierte Base-URL, Modell),
- die Stufe, die tatsächlich auf der Leitung gesendet wurde – gelesen aus dem Payload, nicht aus der Config: Anthropics
cache_control-ttl, OpenAIsprompt_cache_options.ttl, das ältereprompt_cache_retention, - den Sendezeitpunkt,
- die Read- und Write-Token-Zahlen,
- die Stufe oder Stufen, die der Response bewiesen hat (Anthropics ephemeral-Zähler für 5m/1h, OpenAIs ttl_30m/ttl_12h-Zähler),
- und die daraus folgende Abdeckung: eine Deadline pro Stufe, die das gecachte Prefix hält.
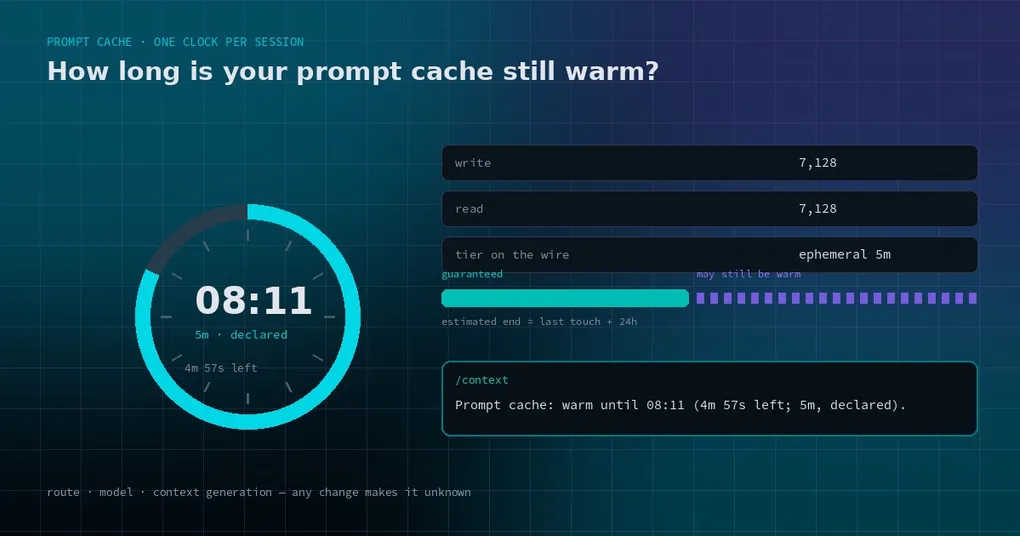
Der letzte Punkt ist der nützliche. Die Uhr speichert nicht „TTL = 300 Sekunden“. Sie speichert „dieses gecachte Prefix ist bis 08:11 abgedeckt, weil um 08:06 eine 5-Minuten-Stufe geschrieben und vom Response bestätigt wurde“. Eine Deadline kann man mit der aktuellen Zeit vergleichen; eine TTL muss man jedes Mal neu ableiten, und jede Neuableitung ist eine Gelegenheit, falsch zu liegen.
Weil das Event an die Session-ID, die vollständige Route und die durable Context-Generation der Session gebunden ist, kann die Uhr auch ehrlich unknown sagen. Wechselst du das Modell, fällst du auf einen anderen Provider zurück, oder läuft eine Compaction, die Rows archiviert – dann beschreibt die alte Deadline nicht mehr den Prompt, den du gerade senden willst. Hermes setzt das Fenster in dem Fall auf unknown, statt so zu tun als ob.
Die Refresh-Regeln unterscheiden sich je Provider, also sind sie Daten
Eine Cache-Deadline ist nicht „Schreibzeit plus TTL“. Sie hängt davon ab, was ein Read mit dem Fenster macht, und da sind sich die Provider uneinig:
| Routen-Klasse | Bei einem Cache-Read | Deadline-Regel |
|---|---|---|
| Anthropic (nativ, OpenRouter Claude, Anthropic-Wire-Gateways) | startet die Stufe neu | Lesezeit + Stufe |
| OpenAI GPT-5.6 und neuer, 30-m-Stufe | frischt das Minimum auf | max(bestehend, Read + 30 m) |
| OpenAI GPT-5.6 und neuer, 12-h-Stufe | startet sie nicht neu | Schreibzeit + 12 h, fix |
| Alles andere | keine veröffentlichte Garantie | keine garantierte Deadline, nur geschätztes Ende |
Deshalb hält das Modul ein Dict mit Handlern pro Route statt einer einzigen Formel. Die Anthropic-Regel und die OpenAI-Regel sind wirklich unterschiedliches Verhalten, und eine einzige Regel „TTL auf letzte Aktivität addieren“ wäre für mindestens eine davon falsch. Auf der 12-Stunden-Route wäre sie gründlich falsch: ein langes Gespräch würde für immer warm aussehen, weil jeder Read die Deadline nach hinten schiebt.
Zwei Enden eines Fensters, denn ein Minimum ist kein Ablaufdatum
Hier kommt die Design-Entscheidung, die die Zeile in /context ehrlich macht. Jedes Fenster hat zwei Enden:
guaranteed_until— die früheste Abdeckungs-Deadline. Hat ein Response sowohl eine 5-Minuten- als auch eine Ein-Stunden-Stufe geschrieben, ist das Prefix nur fünf Minuten garantiert, also ist das die Zahl.Nonebedeutet: keine Garantie.estimated_until— der Punkt, nach dem der Eintrag sicher weg ist. Für Anthropic-Stufen ist er exakt, weil die Stufe exakt ist. Für OpenAI ist es der letzte Kontakt plus 24 Stunden, weil OpenAI sagt, Einträge könnten länger behalten werden als das angeforderte Minimum, und Cache-State höchstens einen Tag hält. Für den altenin_memory-Modus sind es bis zu einer Stunde.
Zwischen beiden lautet die ehrliche Antwort „may still be warm“. Das ist eine echte Antwort, kein Ausweichen: sie sagt dir, dass ein Miss möglich und ein Hit möglich ist, und sie hindert dich daran, mit einer Garantie zu planen, die es nicht gibt. Die Konsumenten fragen cache_certainly_warm oder cache_certainly_cold, und alles Unbekannte ist keins von beidem.
Was /context jetzt ausgibt
Vier Formen, alle eine Zeile:
Prompt cache: warm until 08:11 (4m 57s left; 5m, declared).
Prompt cache: may still be warm until 08:36 (29m 57s left; 30m, proven).
Prompt cache: expired 12m ago (5m, proven).
Prompt cache: unknown — the route changed since this cache was written.
Das Label am Ende ist ein Confidence-Level, und es ist wichtig:
- proven — die Antwort selbst hat die Stufe genannt, die sie behalten hat. Das ist die stärkste Evidenz, die es gibt.
- declared — Hermes hat diese Stufe auf einer Route gesendet, die bekanntermaßen respektiert wird, und nichts hat sie invalidiert.
- assumed — keine veröffentlichte Garantie; behandle es als Schätzung.
- unknown — der Cache hat sich bewegt (Routenwechsel, Fallback, Compaction, Session-Rotation), keine veröffentlichte Retention, oder das gespeicherte Event war nicht lesbar.
Ein Detail noch: das Lesen der Uhr ist advisory. Schlägt der SQLite-Read fehl oder ist die Owner-RPC eines Workers nicht erreichbar, wird das Fenster unknown mit einem Grund. Es wirft nie in den Turn hinein, der deine Antwort produziert hat. Ein Cost-Reporting-Feature sollte kein Gespräch kaputt machen können.
Die Zahlen aus dem Live-Lauf
Der Autor des PRs hat dasselbe Zwei-Turn-Szenario auf drei Routen laufen lassen – Turn eins schreibt den Cache, Turn zwei setzt das Gespräch in einem neuen Prozess mit --resume fort, damit der gespeicherte Beweis einen Neustart überlebt:
| Route | Vorher | Nachher |
|---|---|---|
Nous Portal via custom, cache_ttl: 1h |
auf der Leitung stand ttl: 1h, keine Cache-Zeile in /context |
auf der Leitung steht ephemeral (5 m); 7.128 Tokens geschrieben; warm until 08:11 (4m 57s left; 5m, declared) |
OpenAI gpt-5.6-luna, Responses, Default 30 m |
keine Cache-Zeile, Write-Token-Details verworfen | 6.662 geschrieben; warm until 08:36 (29m 57s left; 30m, proven), geschätztes Ende +24 h |
OpenAI gpt-5.6-luna, ttl: 12h via extra_body |
n/a | 6.664 geschrieben; warm until 20:06 (11h 59m left; 12h, proven); der fortgesetzte Read ließ die Deadline unverändert |
Die geschätzten Beträge aus Hermes’ eigener Preisliste: etwa 0,029 $ für den Nous-Lauf und 0,009 $ für den 30-Minuten-OpenAI-Lauf. Der 12-Stunden-Lauf ging über eine custom-Route, die Hermes nicht bepreist, deshalb steht dort 0,00 $. Die Beträge sind klein, weil die Prompts nur etwa 6.700 Tokens haben – entscheidend ist die Form des Unterschieds, nicht die Cents.
So nutzt du es heute
Du musst nichts konfigurieren, um die /context-Zeile zu bekommen; sie erscheint, sobald ein Turn den Cache auf einer Route gelesen oder geschrieben hat, die Hermes klassifizieren kann. Zwei Stellschrauben sind es wert, sie zu kennen:
1. Hör auf, eine Stufe anzufordern, die der Provider nicht behält. Wenn du einen Ein-Stunden-Cache auf einer Route festgenagelt hast, die Einträge nach fünf Minuten fallen lässt, sendet Hermes jetzt das, was die Route tatsächlich respektiert. Auf dem Nous Portal ist das die 5-Minuten-Stufe.
2. Frag eine längere Stufe an, wo sie wirklich unterstützt wird. Die neueren OpenAI-Modelle nehmen eine längere TTL über prompt_cache_options. Setze sie pro Custom-Provider:
custom_providers:
  - name: openai-long-cache
    base_url: https://api.openai.com/v1
    api_key_env: OPENAI_API_KEY
    model: gpt-5.6-luna
    extra_body:
      prompt_cache_options:
        ttl: 12h
Danach prüfst du /context nach dem ersten Turn. Steht dort 12h, proven, hast du ein echtes 12-Stunden-Fenster. Steht dort unknown, hat die Route die Stufe nicht bestätigt – dann behandle sie weiter als Schätzung.
Was es noch nicht macht
Bleib präzise beim Scope. Diese Änderung zeichnet auf und berichtet; sie handelt noch nicht aufgrund des Fensters. Der Docstring des Moduls nennt die vorgesehenen künftigen Konsumenten: Keep-Alive-Pings vor guaranteed_until, Cold-Cache-Pruning und Idle-Compaction, die ein Prefix nicht wegwirft, das du gleich wiederverwenden willst. Nichts davon ist hier dabei.
Außerdem ist das Ganze nur auf main, nicht in v0.23.1 (getaggt am 9. November 2026). Wenn du ein Stable-Release fährst, hat /context noch keine Cache-Zeile. Und drei Routen wurden nicht live durchgespielt, weil die Keys nicht verfügbar waren: OpenRouter Claude mit der Ein-Stunden-Stufe, der native Anthropic-Beweis für ephemeral_1h und gemischte 5-m/1-h-Writes. Sie sind durch Unit-Tests abgedeckt, was schwächere Evidenz ist als ein Live-Lauf – behandle genau diese Aussagen entsprechend.
Update (17.11.2026): Diese Änderungen sind mit v0.23.2 (16. November) erschienen – ein
hermes updatebringt sie. Die Formulierung „nicht in v0.23.1“ oben ist eine Momentaufnahme vom Veröffentlichungstag.
Eine kurze Checkliste, um den Cache warm zu halten
Die Uhr macht vor allem ein bestehendes Kostenproblem sichtbar. Sobald du die Zeile sehen kannst, folgen die Gewohnheiten:
- Wechsle das Modell nicht mitten in der Aufgabe, wenn dir Cache-Ökonomie wichtig ist. Ein Modellwechsel ändert die Route, und das Fenster wird per Design
unknown. - Behalte Compactions im Blick. Eine Compaction archiviert Rows, ändert die Context-Generation und invalidiert das aufgezeichnete Fenster – selbst wenn das neue Prefix zufällig ähnlich aussieht.
- Halte den Kopf des Prompts stabil. System-Prompt, Tool-Schemas und früher Datei-Kontext sind das, was gecacht wird. Tools umzusortieren oder den System-Prompt bei Turn 30 zu bearbeiten wirft den Rabatt für alles danach weg.
- Lies das Confidence-Label, nicht nur die Zeit.
provenist Evidenz,declaredist Absicht,assumedist eine Schätzung. Wenn du einen langen autonomen Lauf um einassumed-Fenster herum planst, bekommst du die Überraschungsrechnung.
Wenn du „der Cache ist vermutlich noch warm“ bisher als Fakt behandelt hast, ist das das erste Mal, dass Hermes dir sagen kann, ob es stimmt. Für die Token-Seite desselben Problems zeigen unsere früheren Beiträge zum Prompt-Caching bei Sibling-Subagents und zum Claude-Window-Metering, was sonst noch an der Rechnung dreht; die Konfigurationsreferenz zeigt, wo diese Keys liegen.