Votre prompt cache expire sans prévenir. Hermes vous dit désormais quand
Vendredi soir, vous laissez ouverte une longue session de refactoring. Chaque tour de l’après-midi a coûté peu : le même system prompt de 40 000 tokens et le même contexte de fichiers sont passés une fois, et le provider n’a facturé qu’une fraction du prix pour les renvoyer ensuite. Lundi matin, vous reprenez la session, envoyez une petite relance, et la facture de ce seul tour ressemble à celle d’une conversation neuve. Rien n’a changé dans votre configuration. Vous ignorez simplement si le cache a expiré pendant le week-end, si le changement de modèle essayé vendredi l’a réinitialisé, ou si une compaction de contexte a discrètement réécrit le préfixe que le cache détenait.
Cette incertitude est le sujet du changement décrit ici. Pas un nouveau cache, pas une nouvelle fonctionnalité de provider : une horloge qui enregistre ce qui est réellement arrivé à votre prompt cache, et une seule ligne dans /context qui vous dit combien de temps vous pouvez encore compter dessus.
Le prompt caching est une réduction avec une date limite
Le principe est simple. Les providers vous permettent de marquer une partie d’une requête comme réutilisable. Ils conservent le préfixe déjà traité de leur côté pendant un moment, et quand la requête suivante commence par le même préfixe, ils facturent la partie en cache à un tarif bien plus bas au lieu de la retraiter. Sur une longue session d’agent avec un gros system prompt, des schémas d’outils stables et une transcription qui grandit, cette réduction représente l’essentiel de votre facture.
Le piège, c’est le « pendant un moment ». Chaque provider le formule à sa manière :
- Anthropic : les caches sont de cinq minutes par défaut et peuvent être demandés avec un palier d’une heure. Une lecture de cache relance le compteur.
- Les modèles récents d’OpenAI acceptent un
prompt_cache_options.ttlexplicite — 30 minutes par défaut, 12 heures sur demande. Une lecture maintient le plancher de 30 minutes mais ne relance pas une fenêtre de 12 heures. - Les anciennes routes OpenAI et les caches implicites n’ont aucun minimum publié. Ils peuvent conserver les entrées plus longtemps que demandé ; personne ne promet une expiration exacte.
Remarquez ce qu’aucun d’entre eux ne vous donne : un timestamp d’expiration. Ils donnent une durée de conservation minimale. « Cinq minutes » signifie « au moins cinq minutes », pas « disparu à cinq minutes et une seconde ». Tout code qui la traite comme une expiration devine, et Hermes faisait ce genre de supposition indépendamment dans chaque endroit concerné.
Ce qui n’allait pas, concrètement
Deux problèmes distincts se cachaient derrière la même idée floue de « le cache est probablement chaud ».
Le premier était la duplication des suppositions. Différentes parties de l’agent calculaient un TTL de leur côté. Quand deux d’entre elles divergent, la moins chère gagne par accident : vous prenez une décision en supposant une chaleur qu’un autre bout de code aurait qualifiée de froide.
Le second était pire, et il coûtait de l’argent réel. Sur Nous Portal, Hermes demandait le palier de cache d’une heure. Le Portal conserve le cache environ cinq minutes puis le jette. Hermes payait donc le tarif d’écriture en cache plus élevé pour une entrée d’une heure, et l’entrée avait disparu avant le tour suivant. La requête disait « 1h » sur le fil ; la réalité était « 5m ».
La PR #156101 corrige les deux en faisant de la fenêtre de cache un fait enregistré plutôt qu’une supposition recalculée.
Une horloge, notée à chaque tentative
Le nouveau module est agent/prompt_cache_clock.py. Pour chaque tentative de modèle réussie ayant touché le cache, il enregistre un événement :
- la route complète (provider, base URL normalisée, modèle),
- le palier réellement envoyé sur le fil — lu depuis le payload, pas depuis la config :
cache_controlttl d’Anthropic,prompt_cache_options.ttld’OpenAI, l’ancienprompt_cache_retention, - l’heure d’envoi,
- les compteurs de tokens en lecture et en écriture,
- le ou les paliers que la réponse a prouvés (compteurs ephemeral 5m/1h d’Anthropic, compteurs ttl_30m/ttl_12h d’OpenAI),
- et la couverture qui en résulte : une deadline par palier que le préfixe en cache détient.
Cette dernière partie est la plus utile. L’horloge ne stocke pas « TTL = 300 secondes ». Elle stocke « ce préfixe en cache est couvert jusqu’à 08:11, parce qu’un palier de 5 minutes a été écrit à 08:06 et que la réponse l’a confirmé ». Une deadline est quelque chose que l’on peut comparer à l’heure courante ; un TTL est quelque chose qu’il faut recalculer, et chaque recalcul est une occasion de se tromper.
Comme l’événement est lié à l’id de session, à la route complète et à la génération de contexte durable de la session, il peut aussi répondre unknown honnêtement. Changez de modèle, basculez sur un fallback vers un autre provider, ou lancez une compaction qui archive des lignes, et l’ancienne deadline ne décrit plus le prompt que vous êtes sur le point d’envoyer. Hermes ramène alors la fenêtre à unknown au lieu de faire semblant.
Les règles de rafraîchissement diffèrent selon le provider, donc ce sont des données
Une deadline de cache n’est pas « heure d’écriture plus TTL ». Elle dépend de l’effet d’une lecture sur la fenêtre, et les providers ne sont pas d’accord :
| Classe de route | Lors d’une lecture de cache | Règle de deadline |
|---|---|---|
| Anthropic (natif, OpenRouter Claude, gateways Anthropic-wire) | relance le palier | heure de lecture + palier |
| OpenAI GPT-5.6 et plus récents, palier 30 m | rafraîchit le plancher | max(existant, lecture + 30 m) |
| OpenAI GPT-5.6 et plus récents, palier 12 h | ne le relance pas | heure d’écriture + 12 h, fixe |
| Tout le reste | aucune garantie publiée | pas de deadline garantie, fin estimée uniquement |
C’est pourquoi le module garde un dict de handlers par route plutôt qu’une formule unique. La règle Anthropic et la règle OpenAI sont réellement des comportements différents, et une règle unique du type « ajouter le TTL à la dernière activité » serait fausse pour au moins l’une des deux. Sur la route 12 heures, elle serait franchement fausse : une longue conversation paraîtrait chaude indéfiniment, parce que chaque lecture repousserait la deadline.
Deux extrémités pour une seule fenêtre, car un minimum n’est pas une expiration
Voici la décision de conception qui rend honnête la ligne de /context. Chaque fenêtre a deux extrémités :
guaranteed_until— la deadline de couverture la plus précoce. Si une réponse a écrit à la fois un palier de 5 minutes et un palier d’une heure, le préfixe n’est garanti que cinq minutes ; c’est donc ce chiffre qui compte.Nonesignifie aucune garantie du tout.estimated_until— le point après lequel l’entrée a certainement disparu. Pour les paliers Anthropic il est exact, puisque le palier est exact. Pour OpenAI c’est le dernier contact plus 24 heures, car OpenAI indique que les entrées peuvent être conservées plus longtemps que le minimum demandé et garde l’état du cache pendant un jour au maximum. Pour l’ancien modein_memory, cela monte jusqu’à une heure.
Entre les deux, la réponse honnête est « peut-être encore chaud ». C’est une vraie réponse, pas une échappatoire : elle vous dit qu’un miss est possible et qu’un hit est possible, et elle vous empêche de planifier autour d’une garantie qui n’existe pas. Les consommateurs interrogent cache_certainly_warm ou cache_certainly_cold, et tout ce qui est inconnu n’est ni l’un ni l’autre.
Ce que /context affiche maintenant
Quatre formes, toutes sur une seule ligne :
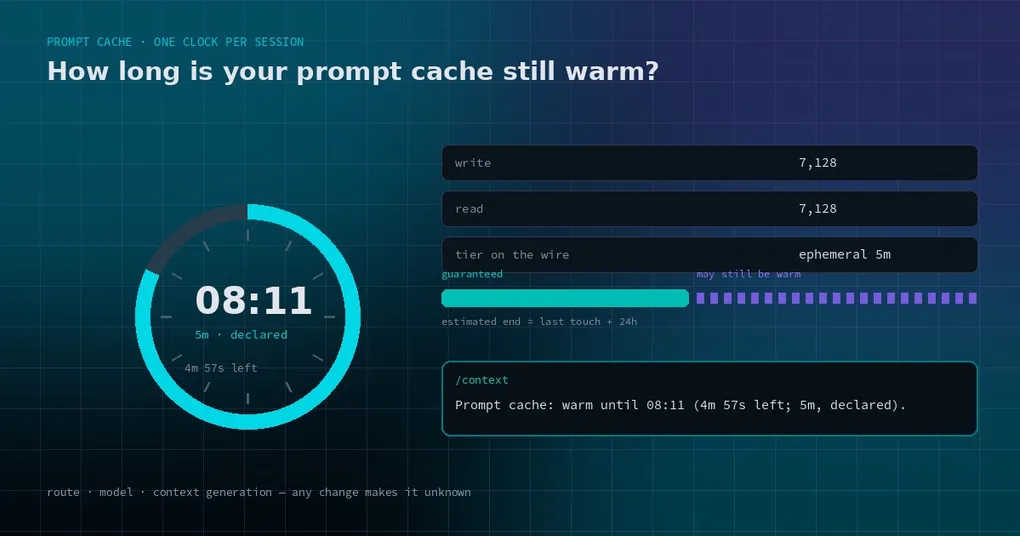
Prompt cache: warm until 08:11 (4m 57s left; 5m, declared).
Prompt cache: may still be warm until 08:36 (29m 57s left; 30m, proven).
Prompt cache: expired 12m ago (5m, proven).
Prompt cache: unknown — the route changed since this cache was written.
Le label final est un niveau de confiance, et il compte :
- proven — la réponse elle-même a nommé le palier qu’elle conservait. C’est la preuve la plus forte disponible.
- declared — Hermes a envoyé ce palier sur une route connue pour l’honorer, et rien ne l’a invalidé depuis.
- assumed — aucune garantie publiée ; à traiter comme une supposition.
- unknown — le cache a bougé (changement de route, fallback, compaction, rotation de session), aucune rétention n’est publiée, ou l’événement stocké n’a pas pu être lu.
Un dernier détail utile : la lecture de l’horloge est purement indicative. Si la lecture SQLite échoue, ou si le RPC owner d’un worker est indisponible, la fenêtre devient unknown avec une raison. Elle ne fait jamais remonter d’exception dans le tour qui a produit votre réponse. Une fonctionnalité de reporting de coûts ne devrait pas pouvoir casser une conversation.
Les chiffres du run réel
L’auteur de la PR a exécuté le même scénario à deux tours sur trois routes — le premier tour écrit le cache, le second reprend la conversation dans un nouveau process avec --resume, de sorte que la preuve enregistrée doit survivre à un redémarrage :
| Route | Avant | Après |
|---|---|---|
Nous Portal via custom, cache_ttl: 1h |
le fil annonçait ttl: 1h, aucune ligne de cache dans /context |
le fil annonce ephemeral (5 m) ; 7 128 tokens écrits ; warm until 08:11 (4m 57s left; 5m, declared) |
OpenAI gpt-5.6-luna, Responses, 30 m par défaut |
aucune ligne de cache, détails des write tokens perdus | 6 662 écrits ; warm until 08:36 (29m 57s left; 30m, proven), fin estimée +24 h |
OpenAI gpt-5.6-luna, ttl: 12h via extra_body |
s.o. | 6 664 écrits ; warm until 20:06 (11h 59m left; 12h, proven) ; la lecture après reprise a laissé la deadline inchangée |
Estimations facturées d’après la tarification propre à Hermes : environ 0,029 $ pour le run Nous et 0,009 $ pour le run OpenAI de 30 minutes. Le run de 12 heures est passé par une route custom que Hermes ne tarife pas, d’où 0,00 $. Ces montants sont faibles parce que les prompts font environ 6,7k tokens — ce qui compte, c’est la forme de l’écart, pas les centimes.
Comment l’utiliser dès aujourd’hui
Vous n’avez rien à configurer pour obtenir la ligne /context ; elle apparaît dès qu’un tour a lu ou écrit le cache sur une route que Hermes sait classer. Deux réglages valent la peine d’être connus :
1. Arrêtez de demander un palier que le provider ne conserve pas. Si vous avez épinglé un cache d’une heure sur une route qui jette les entrées au bout de cinq minutes, Hermes envoie désormais ce que la route honore réellement. Sur Nous Portal, c’est le palier de 5 minutes.
2. Demandez un palier plus long là où il est réellement pris en charge. Les modèles récents d’OpenAI acceptent un TTL plus long via prompt_cache_options. Réglez-le par custom provider :
custom_providers:
  - name: openai-long-cache
    base_url: https://api.openai.com/v1
    api_key_env: OPENAI_API_KEY
    model: gpt-5.6-luna
    extra_body:
      prompt_cache_options:
        ttl: 12h
Vérifiez ensuite /context après le premier tour. Si la ligne dit 12h, proven, vous avez une vraie fenêtre de 12 heures. Si elle dit unknown, la route n’a pas confirmé le palier — revenez à le traiter comme une supposition.
Ce que cela ne fait pas encore
Soyons précis sur le périmètre. Ce changement enregistre et rapporte ; il n’agit pas encore sur la fenêtre. La docstring du module nomme les consommateurs envisagés : des pings de keep-alive avant guaranteed_until, l’élagage des caches froids, et une compaction à l’inactivité qui évite de jeter un préfixe sur le point d’être réutilisé. Rien de tout cela n’est livré ici.
C’est aussi sur main uniquement, et pas dans la v0.23.1 (tagguée le 9 novembre 2026). Si vous utilisez une release stable, /context n’a pas encore de ligne de cache. Et trois routes n’ont pas été exercées en live faute de clés disponibles : OpenRouter Claude avec le palier d’une heure, la preuve ephemeral_1h d’Anthropic natif, et les écritures mixtes 5 m/1 h. Elles sont couvertes par des tests unitaires, ce qui reste une preuve plus faible qu’un run réel : traitez ces affirmations précises en conséquence.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.
Une courte checklist pour garder le cache chaud
L’horloge rend surtout visible un problème de coût déjà présent. Une fois la ligne sous les yeux, les bonnes habitudes suivent :
- Ne changez pas de modèle en cours de tâche si l’économie du cache vous importe. Un changement de modèle change la route, et la fenêtre devient
unknownpar conception. - Surveillez les compactions. Une compaction archive des lignes, change la génération de contexte et invalide la fenêtre enregistrée — même si le nouveau préfixe ressemble par hasard à l’ancien.
- Gardez la tête du prompt stable. Le system prompt, les schémas d’outils et le contexte de fichiers initial sont ce qui est mis en cache. Réordonner les outils ou modifier le system prompt au trentième tour jette la réduction pour tout ce qui suit.
- Lisez le label de confiance, pas seulement l’heure.
provenest une preuve ;declaredest une intention ;assumedest une supposition. Planifier un long run autonome autour d’une fenêtreassumed, c’est la garantie d’une facture surprise.
Si vous traitiez « le cache est probablement encore chaud » comme un fait, c’est la première fois que Hermes peut vous dire si c’est vrai. Pour la vue côté tokens du même problème, nos articles sur le prompt caching des subagents frères et sur le comptage des fenêtres Claude détaillent les autres facteurs qui font bouger la facture ; la référence de configuration indique où vivent ces clés.