Tu prompt cache caduca en silencio. Hermes ahora te dice cuándo
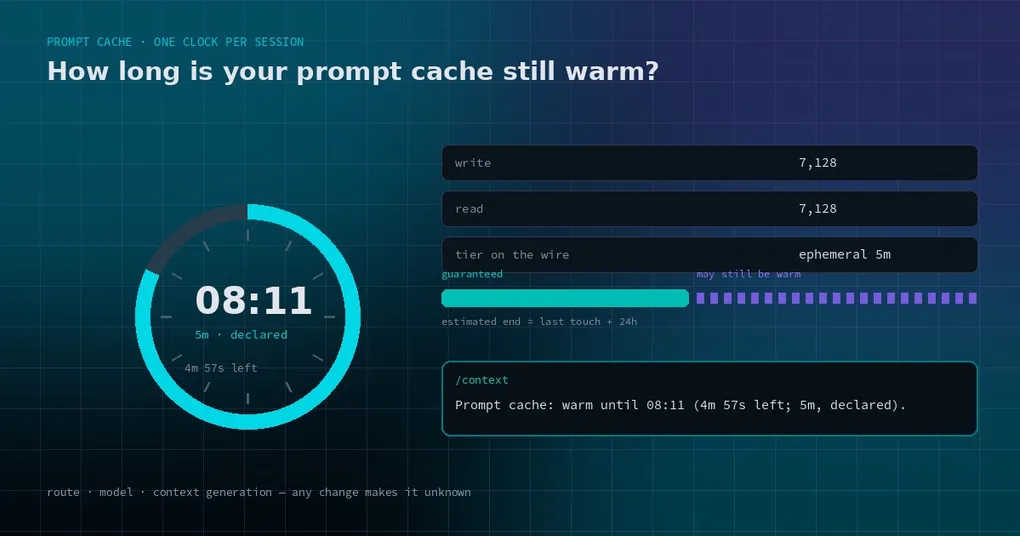
Viernes por la noche dejas abierta una sesión larga de refactoring. Cada turno de esa tarde salió barato: el mismo system prompt de 40.000 tokens y el mismo contexto de archivos se enviaron una vez, y el proveedor cobró una fracción del precio por volver a mandarlos. El lunes por la mañana retomas la sesión, mandas un follow-up pequeño y la factura de ese único turno parece la de una conversación recién empezada. No cambiaste nada de tu setup. Simplemente no tienes ni idea de si el cache expiró durante el fin de semana, de si el cambio de modelo que probaste el viernes lo reinició, o de si un compaction de contexto reescribió en silencio el prefijo que el cache tenía guardado.
De esa incertidumbre va este cambio. No es un cache nuevo ni una feature nueva del proveedor: es un reloj que registra lo que de verdad le pasó a tu prompt cache, y una sola línea en /context que te dice cuánto tiempo más puedes contar con él.
El prompt caching es un descuento con deadline
La idea es simple. Los proveedores te dejan marcar parte de una request como reutilizable. Guardan el prefijo ya procesado de su lado durante un rato y, cuando la siguiente request empieza con ese mismo prefijo, te cobran la parte cacheada a una tarifa mucho más baja en lugar de procesarla otra vez. En una sesión larga de agente con un system prompt grande, tool schemas estables y una transcripción que no deja de crecer, ese descuento es la mayor parte de tu factura.
El problema es eso de “durante un rato”. Cada proveedor lo formula a su manera:
- Los caches de Anthropic son de cinco minutos por defecto y se puede pedir un tier de una hora. Una lectura de cache reinicia el reloj.
- Los modelos más nuevos de OpenAI aceptan un
prompt_cache_options.ttlexplícito: 30 minutos por defecto, 12 horas si lo pides. Una lectura mantiene el piso de 30 minutos, pero no reinicia una ventana de 12 horas. - Las rutas antiguas de OpenAI y los caches implícitos no publican ningún mínimo. Pueden conservar entradas más tiempo del pedido; nadie promete un vencimiento exacto.
Fíjate en lo que ninguno te da: un timestamp de vencimiento. Lo que te dan es una retención mínima. “Cinco minutos” significa “al menos cinco minutos”, no “desaparece a los cinco minutos y un segundo”. Cualquier código que lo trate como un vencimiento está adivinando, y Hermes hacía esa suposición por separado en cada sitio al que le importaba.
Qué estaba realmente mal
Dos problemas distintos se escondían detrás de la misma idea vaga de “el cache probablemente está caliente”.
El primero eran las estimaciones duplicadas. Distintas partes del agente derivaban un TTL por su cuenta. Cuando dos de ellas no coinciden, gana la más barata por accidente: tomas una decisión asumiendo un calor que otra pieza del código habría llamado frío.
El segundo era peor, y costaba dinero real. En Nous Portal, Hermes pedía el tier de cache de una hora. El Portal guarda el cache unos cinco minutos y lo tira. Así que Hermes pagaba la tarifa alta de escritura de cache por una entrada de una hora, y la entrada ya no existía antes del turno siguiente. La request decía “1h” en el wire; la realidad era “5m”.
El PR #156101 arregla las dos cosas convirtiendo la ventana del cache en un hecho registrado en lugar de una estimación recalculada.
Un solo reloj, anotado en cada intento
El módulo nuevo es agent/prompt_cache_clock.py. Para cada intento de modelo exitoso que tocó el cache, registra un evento:
- la ruta completa (proveedor, base URL normalizada, modelo),
- el tier realmente enviado en el wire, leído del payload y no de la config: el ttl de
cache_controlde Anthropic, elprompt_cache_options.ttlde OpenAI, el antiguoprompt_cache_retention, - la hora de envío,
- los conteos de tokens de lectura y escritura,
- el tier o tiers que probó la respuesta (los contadores ephemeral 5m/1h de Anthropic, los contadores ttl_30m/ttl_12h de OpenAI),
- y la cobertura resultante: un deadline por tier que mantiene el prefijo cacheado.
Esa última parte es la útil. El reloj no guarda “TTL = 300 segundos”. Guarda “este prefijo cacheado está cubierto hasta las 08:11, porque se escribió un tier de 5 minutos a las 08:06 y la respuesta lo confirmó”. Un deadline es algo que puedes comparar con la hora actual; un TTL es algo que tienes que volver a derivar, y cada nueva derivación es una ocasión de equivocarte.
Como el evento está atado al id de sesión, a la ruta completa y a la generación de contexto durable de la sesión, también puede decir unknown con honestidad. Cambia de modelo, haz fallback a otro proveedor o ejecuta un compaction que archive filas, y el deadline viejo ya no describe el prompt que estás a punto de enviar. Hermes baja la ventana a unknown en lugar de fingir.
Las reglas de refresco cambian según el proveedor, así que son datos
Un deadline de cache no es “hora de escritura más TTL”. Depende de qué le hace una lectura a la ventana, y los proveedores no se ponen de acuerdo:
| Clase de ruta | En una lectura de cache | Regla del deadline |
|---|---|---|
| Anthropic (nativo, OpenRouter Claude, gateways Anthropic-wire) | reinicia el tier | hora de lectura + tier |
| OpenAI GPT-5.6 y posteriores, tier de 30 m | refresca el piso | max(existing, read + 30 m) |
| OpenAI GPT-5.6 y posteriores, tier de 12 h | no lo reinicia | hora de escritura + 12 h, fijo |
| Todo lo demás | sin garantía publicada | sin deadline garantizado, solo fin estimado |
Por eso el módulo mantiene un diccionario de handlers por ruta en vez de una sola fórmula. La regla de Anthropic y la de OpenAI son comportamientos genuinamente distintos, y una única regla de “sumar el TTL a la última actividad” estaría mal en al menos una de ellas. En la ruta de 12 horas estaría muy mal: una conversación larga parecería caliente para siempre porque cada lectura empujaría el deadline hacia adelante.
Dos extremos de una misma ventana, porque un mínimo no es un vencimiento
Aquí está la decisión de diseño que hace honesta la línea de /context. Toda ventana tiene dos extremos:
guaranteed_until: el deadline de cobertura más temprano. Si una respuesta escribió tanto un tier de 5 minutos como uno de una hora, el prefijo solo está garantizado cinco minutos, así que ese es el número.Nonesignifica que no hay ninguna garantía.estimated_until: el punto a partir del cual la entrada ya seguro que no está. Para los tiers de Anthropic es exacto, porque el tier es exacto. Para OpenAI es el último toque más 24 horas, porque OpenAI dice que las entradas pueden retenerse más que el mínimo pedido y guarda estado de cache durante un día como máximo. Para el antiguo modoin_memoryes hasta una hora.
Entre los dos, la respuesta honesta es “puede que siga caliente”. Es una respuesta real, no una excusa: te dice que un miss es posible y que un hit también lo es, y te impide planificar alrededor de una garantía que no existe. Los consumidores preguntan cache_certainly_warm o cache_certainly_cold, y todo lo desconocido no es ninguna de las dos.
Qué imprime ahora /context
Cuatro formas, todas en una línea:
Prompt cache: warm until 08:11 (4m 57s left; 5m, declared).
Prompt cache: may still be warm until 08:36 (29m 57s left; 30m, proven).
Prompt cache: expired 12m ago (5m, proven).
Prompt cache: unknown — the route changed since this cache was written.
La etiqueta del final es un nivel de confianza, y importa:
- proven: la propia respuesta nombró el tier que conservó. Es la mejor evidencia disponible.
- declared: Hermes envió ese tier en una ruta que se sabe que lo respeta, y nada lo ha invalidado.
- assumed: no hay garantía publicada; trátalo como una suposición.
- unknown: el cache se movió (cambio de ruta, fallback, compaction, rotación de sesión), no hay retención publicada, o el evento guardado no se pudo leer.
Un detalle más que conviene saber: leer el reloj es advisory. Si falla la lectura de SQLite, o el RPC del owner de un worker no está disponible, la ventana pasa a unknown con un motivo. Nunca lanza una excepción hacia el turno que produjo tu respuesta. Una feature de reporte de costes no debería poder romper una conversación.
Los números de la ejecución real
El autor del PR ejecutó el mismo escenario de dos turnos en tres rutas: el turno uno escribe el cache, el turno dos retoma la conversación en un proceso nuevo con --resume, así que la prueba guardada tiene que sobrevivir a un reinicio:
| Ruta | Antes | Después |
|---|---|---|
Nous Portal vía custom, cache_ttl: 1h |
el wire decía ttl: 1h, sin línea de cache en /context |
el wire dice ephemeral (5 m); 7.128 tokens escritos; warm until 08:11 (4m 57s left; 5m, declared) |
OpenAI gpt-5.6-luna, Responses, 30 m por defecto |
sin línea de cache, detalles de write-tokens descartados | 6.662 escritos; warm until 08:36 (29m 57s left; 30m, proven), fin estimado +24 h |
OpenAI gpt-5.6-luna, ttl: 12h vía extra_body |
n/a | 6.664 escritos; warm until 20:06 (11h 59m left; 12h, proven); la lectura retomada dejó el deadline sin cambios |
Estimaciones facturadas según el pricing propio de Hermes: unos 0,029 $ para la ejecución de Nous y 0,009 $ para la de OpenAI de 30 minutos. La de 12 horas fue por una ruta custom que Hermes no sabe tarifar, así que muestra 0,00 $. Son cifras pequeñas porque los prompts rondan los 6,7k tokens; lo que importa es la forma de la diferencia, no los céntimos.
Cómo usarlo hoy
No tienes que configurar nada para conseguir la línea en /context; aparece en cuanto un turno ha leído o escrito el cache en una ruta que Hermes sabe clasificar. Hay dos ajustes que vale la pena conocer:
1. Deja de pedir un tier que el proveedor no conserva. Si fijaste un cache de una hora en una ruta que tira las entradas a los cinco minutos, Hermes ahora envía lo que la ruta respeta de verdad. En Nous Portal ese es el tier de 5 minutos.
2. Pide un tier más largo donde de verdad esté soportado. Los modelos nuevos de OpenAI aceptan un TTL más largo vía prompt_cache_options. Se configura por proveedor custom:
custom_providers:
  - name: openai-long-cache
    base_url: https://api.openai.com/v1
    api_key_env: OPENAI_API_KEY
    model: gpt-5.6-luna
    extra_body:
      prompt_cache_options:
        ttl: 12h
Luego mira /context después del primer turno. Si la línea dice 12h, proven, tienes una ventana real de 12 horas. Si dice unknown, la ruta no confirmó el tier: vuelve a tratarlo como una suposición.
Qué no hace todavía
Conviene ser preciso con el alcance. Este cambio registra y reporta; todavía no actúa sobre la ventana. El docstring del módulo nombra los consumidores previstos: pings de keep-alive antes de guaranteed_until, purga de caches fríos y compaction en idle que evite tirar un prefijo que estás a punto de reutilizar. Nada de eso llega aquí.
Además está solo en main, no en v0.23.1 (etiquetado el 9 de noviembre de 2026). Si usas una release estable, /context todavía no tiene línea de cache. Y hay tres rutas que no se probaron en vivo porque las claves no estaban disponibles: OpenRouter Claude con el tier de una hora, la prueba ephemeral_1h de Anthropic nativo y las escrituras mixtas de 5 m/1 h. Están cubiertas por tests unitarios, que es evidencia más débil que una ejecución real, así que toma esas afirmaciones concretas con la cautela que merecen.
Actualización (17/11/2026): estos cambios salieron en la v0.23.2 (16 de noviembre):
hermes updatelos trae. Lo de «no está en la v0.23.1» es una foto del momento de la publicación.
Una checklist breve para mantener el cache caliente
El reloj, sobre todo, hace visible un problema de costes que ya existía. Una vez que ves la línea, los hábitos salen solos:
- No cambies de modelo a mitad de tarea si te importa la economía del cache. Un cambio de modelo cambia la ruta, y la ventana pasa a
unknownpor diseño. - Vigila los compactions. Un compaction archiva filas, cambia la generación de contexto e invalida la ventana registrada, aunque el nuevo prefijo se parezca.
- Mantén estable la cabecera del prompt. El system prompt, los tool schemas y el contexto de archivos inicial son lo que se cachea. Reordenar tools o editar el system prompt en el turno 30 tira el descuento de todo lo que viene después.
- Lee la etiqueta de confianza, no solo la hora.
provenes evidencia;declaredes intención;assumedes una suposición. Planificar una ejecución autónoma larga alrededor de una ventanaassumedes exactamente cómo te llega una factura sorpresa.
Si has estado tratando “el cache probablemente sigue caliente” como un hecho, esta es la primera vez que Hermes puede decirte si lo está. Para la vista del mismo problema desde el lado de los tokens, nuestros posts anteriores sobre prompt caching en subagentes hermanos y medición de la ventana de Claude cubren qué más mueve la factura; la referencia de configuración cubre dónde viven estas claves.