Seu Bot Respondeu Duas Vezes — o Modelo Rodou Duas Vezes?
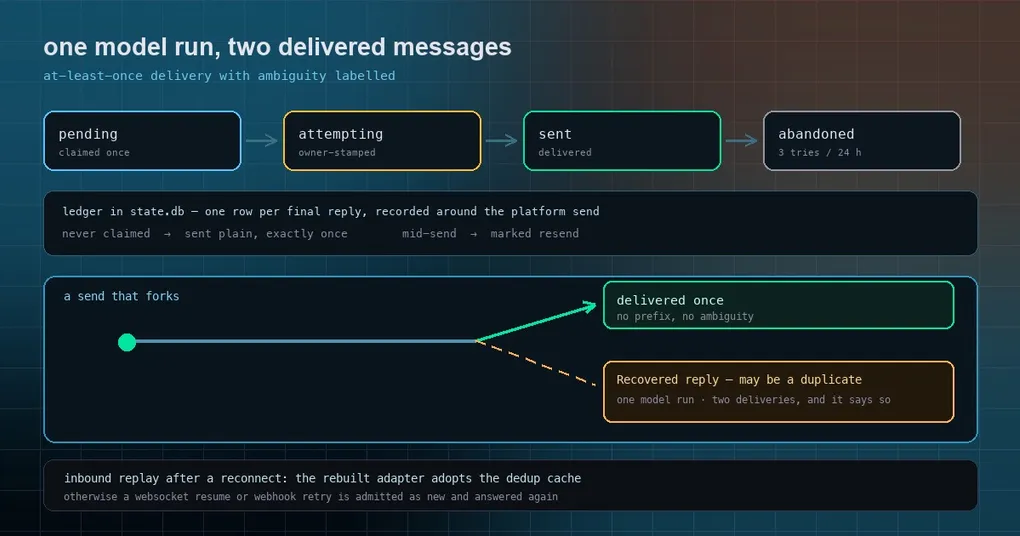
Você pergunta algo ao seu bot em um grupo, recebe uma resposta e então — dez minutos depois, logo após reiniciar o gateway — a mesma resposta chega de novo. Seu primeiro pensamento é sobre dinheiro: o modelo rodou duas vezes e eu paguei duas vezes? Seu segundo pensamento é sobre confiança: se ele responde duas vezes agora, o que mais ele está repetindo?
As duas perguntas têm respostas concretas, e o mecanismo por trás delas é uma das partes mais cuidadosamente projetadas do gateway. Dois bugs nele foram corrigidos esta semana (#120444 e #120450), então é um bom momento para entender o que você está olhando.
O delivery ledger, em palavras simples
Em torno de cada envio a uma plataforma, o Hermes registra a resposta final em um delivery ledger durável que vive no state.db. Se o gateway crasha ou reinicia entre produzir uma resposta e a plataforma confirmar o recebimento, a próxima inicialização tem três opções: perder a resposta, rodar o turno inteiro de novo (caro e possivelmente errado), ou reenviar o que armazenou. Ele reenvia.
A semântica é deliberadamente honesta em vez de esperta — at-least-once, com a ambiguidade rotulada em vez de adivinhada:
- Uma resposta cujo envio nunca começou é reenviada como está, sem nada adicionado. Essa é segura para enviar exatamente uma vez.
- Uma resposta que estava em envio quando o gateway morreu — a plataforma pode ou não tê-la recebido — é reenviada com um prefixo visível
♻️ Recovered reply — … may be a duplicate. - Um envio recusado por flood control (rate limits do Telegram, por exemplo) é retentado automaticamente depois que a penalidade registrada expira, sem precisar reconectar nem reiniciar, e o prefixo de recuperação avisa que pedaços anteriores podem já ter chegado. O ledger não consegue inferir entrega parcial a partir do tamanho da mensagem, então ele diz isso.
- Qualquer outro envio final rejeitado — um 5xx da plataforma, um erro não classificado — é retentado depois de um backoff crescente de 30 segundos e, em seguida, dois minutos. A última tentativa prevista no orçamento é deixada para a próxima inicialização do gateway, então uma indisponibilidade que dure mais que o timer nunca deixa a resposta presa. Um chat permanentemente inalcançável (bot bloqueado, grupo deletado) não é retentado de forma alguma.
O reenvio é limitado: três tentativas e 24 horas de frescor, após o que a linha é abandonada. Linhas entregues são podadas depois de sete dias. As retentativas mantêm o profile, o chat e o thread originais do bot, e um gateway multiplexado mantém as respostas de cada profile servido na casa de onde foi iniciado.
O que o marcador te diz
Esta é a conclusão prática: uma duplicata rotulada significa que o modelo não rodou duas vezes. O gateway reconheceu que um envio já estava em andamento e escolheu reenviar a resposta armazenada, em vez de rodar o turno de novo. A resposta que você está vendo duas vezes é uma execução de modelo, entregue duas vezes, com um prefixo que admite isso.
Então, quando você receber uma resposta dupla, procure o prefixo ♻️ Recovered reply antes de culpar a fatura do seu provider. Se ele estiver lá, a contabilidade honesta é uma mensagem duplicada, não um gasto duplicado. Se ele não estiver lá e as duas respostas estiverem separadas por um reinício, você estava batendo no bug abaixo.
Bug um: um crash no meio de um reenvio enviava uma segunda cópia sem marcação
O ledger marca as linhas conforme as reivindica. Um gateway morto enquanto sua varredura de boot reenviava uma resposta armazenada costumava deixar uma linha que a próxima inicialização podia reivindicar de novo e enviar sem o prefixo de recuperação — o pior resultado, porque a duplicata ficava sem rótulo e, portanto, indistinguível de uma segunda execução real.
O corrigido move toda linha reivindicada para attempting dentro do mesmo compare-and-swap de owner-stamp que a reivindica. Antes, só as linhas de flood recebiam esse tratamento. A decisão de needs_marker ainda lê o estado pré-claim da linha, então uma linha que nunca foi reivindicada continua saindo limpa e exatamente uma vez — o comportamento prometido pelo primeiro item acima é preservado, não trocado. Uma linha pending remanescente com attempts maior que zero, que uma build mais antiga já havia reivindicado e possivelmente enviado, agora também é marcada.
Havia uma corrida irmã no mesmo mecanismo: uma linha failed reivindicada no boot permanecia failed e pertencia ao processo vivo enquanto seu envio de boot estava em andamento. A varredura de reconexão do runtime — que pega linhas failed — podia então reivindicá-la e enviá-la uma segunda vez. Agora a linha permanece attempting durante todo o envio, então o claim de boot é exclusivo.
Bug dois: um adapter reconectado esquecia o que já tinha visto
A segunda duplicata não tinha nada a ver com entrega de saída. Quando a conexão com uma plataforma de mensagens cai, o watcher de reconexão do gateway substitui o adapter com falha por uma nova instância. A deduplicação de entrada — o MessageDeduplicator que descarta um ID de mensagem de entrada que já viu — vivia na instância do adapter. Um adapter novinho, portanto, começava com um cache vazio.
Isso importa porque as plataformas reproduzem mensagens. Um resume de websocket, um retry de webhook ou um lote de poll não reconhecido podem entregar a mesma mensagem de entrada de novo logo após a reconexão. Com um cache vazio, o gateway a admitia como nova, rodava um turno e respondia uma segunda vez.
O corrigido semeia os caches de dedup do adapter reconstruído a partir da instância que ele substitui, adotando os IDs ainda vivos nos seus horários originais de visualização. A parte sutil é “vivos”: a entrada do cache mantém seu timestamp original em vez de ser atualizada, então a janela de dedup não se estende silenciosamente só porque o adapter foi reconstruído. É um corrigido pequeno e completo para toda uma família de relatos de “por que ele respondeu duas vezes”.
O que fazer a respeito
- Leia o marcador primeiro. Um prefixo
♻️ Recovered replysignifica uma execução de modelo e duas entregas. Em termos de orçamento, você está bem; a resposta é duplicada, não o gasto. - Duplicatas sem marcação após um reinício ou uma reconexão são o que esses dois corrigidos resolvem. Puxar a
main— ou esperar a próxima release com tag, já que as duas entraram depois da v0.21.4 — é o remédio. - Se você prefere perder uma resposta a duplicar uma,
gateway.delivery_ledger: falsedesliga o ledger e restaura o comportamento antigo: respostas em andamento se perdem em um crash. É uma troca real, não um interruptor gratuito — para um bot onde uma duplicata é inaceitável e uma resposta perdida é aceitável, é a escolha certa; para um bot de suporte, provavelmente não. - Nada mais para configurar. Não há janela de dedup para ajustar nem contagem de retry para definir; os limites acima são o design.
O quadro mais amplo de como as respostas chegam a uma plataforma está no nosso guia de cadência de entrega de mensagens (batching e comportamento de backlog), com entrega de anexos de mídia para arquivos e imagens e batching de notificações em background para como trabalho agendado reporta de volta. Se você roda um gateway que reinicia inesperadamente, o guia do loop watchdog explica o caminho de recuperação pelo qual um gateway em reinício passa.