Afogado em avisos de «Job Finished»? O Hermes agora agrupa conclusões de segundo plano já prontas em um único turno
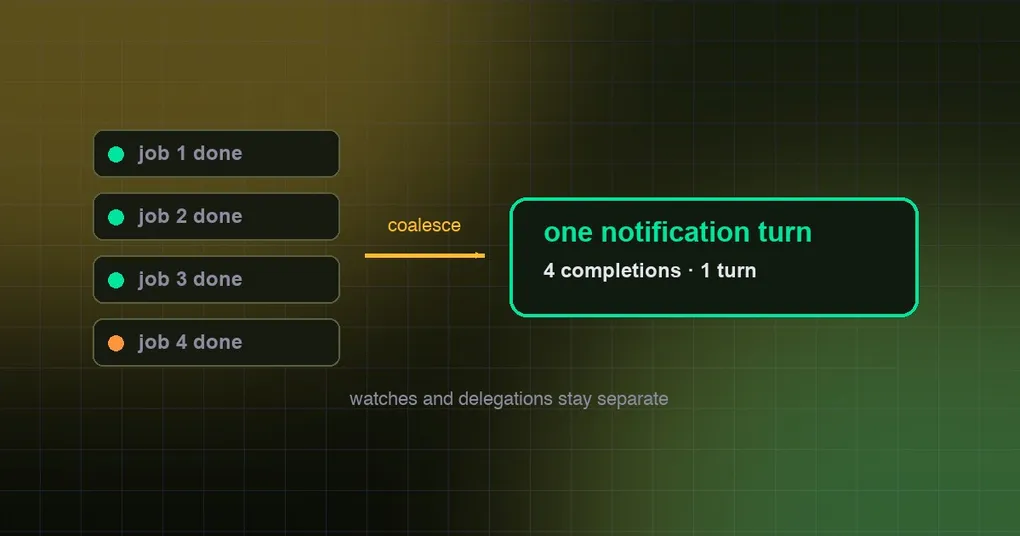
Você inicia três jobs de uma vez: um rodando a suíte de testes, um puxando dependências, um gerando assets em segundo plano. Você vai a uma reunião. Quando volta, a tela é uma parede de «job finished» — e cada um disparou seu próprio turno de modelo, quando tudo o que você queria era «acabaram todos, pode continuar».
O problema nunca foram as notificações em si; era que cada notificação contava como o início de uma conversa separada. Uma mudança recente aperta isso: conclusões de segundo plano que já estão prontas agora são agrupadas em um único turno de notificação nas superfícies interativas.
O novo comportamento: conclusões prontas viram um único turno
A regra é curta. As superfícies de conversa agrupam conclusões consecutivas de processos em segundo plano que já estão prontas para uma conversa em um único turno de notificação. As falhas ficam no lote junto com a saída bem-sucedida — más notícias não são separadas. E uma conclusão isolada mantém seu texto original em vez de ser embrulhada em um envelope de lote.
Uma clarificação, porque é fácil ler errado: isto não é batching com atraso. O sistema não segura um que terminou cedo para que mais possam se juntar a ele. Ele só combina o que já está pronto naquele momento, e explicitamente não promete combinar jobs que terminam em momentos diferentes. Então você não verá um teste que terminou há muito tempo preso a uma notificação em vez de acordar o agent.
O que não é agrupado
O agrupamento cobre eventos de conclusão de processo em segundo plano. Duas coisas ficam deliberadamente de fora:
- Resultados de watch (assinaturas de mudanças na saída) e resultados de delegação assíncrona continuam como notificações separadas, entregues na ordem original.
- O gateway de mensagens — o bot que responde para você no Telegram, Slack e afins — mantém seu próprio agrupamento de janela curta por rota. Essa mudança não substitui aquele mecanismo nem altera os envios dos adapters.
O uso por script também não é afetado: consumidores não interativos, como uma requisição de API, um cliente ACP ou uma chamada única de CLI, não ganham nenhum novo laço autônomo de notificação.
Processos consumidos não notificam mais
Esta é a parte mais prática da mudança e a mais fácil de passar despercebida.
A identidade do processo continua disponível até o dispatch. Então, se você já pegou o resultado de um processo em segundo plano explicitamente — lendo seu log via process_manage, esperando por ele ou o matando — a CLI não acrescentará depois um aviso de conclusão, mesmo que aquele processo tenha saído do registro e esteja parado na fila de entrada. Um lote que foi inteiramente consumido não inicia turno nenhum.
Em outras palavras: ir olhar o resultado você mesmo é tratado como dizer ao Hermes «eu já sei deste».
Quem cuida disso
O mesmo comportamento vive em módulos diferentes por superfície. Conhecer a organização economiza tempo quando algo parece errado:
| Superfície | Módulo | O que faz |
|---|---|---|
| CLI clássica | hermes_cli/cli_process_notifications.py |
Cuida do drain ocioso/pós-turno, da posse ciente de compressão e do desembrulho final da entrada |
| TUI e Desktop | tui_gateway/session_notifications.py |
Agrupa o snapshot pronto do poller depois de checar a posse; cada processo ainda emite seu próprio status de UI; sessões ocupadas recolocam eventos estruturados na fila em vez de strings de lote renderizadas |
| TUI pós-turno | tui_gateway/prompt_turn.py |
Mesmo caminho de roteamento e renderização; clientes de chat do desktop e do dashboard compartilham este backend |
O renderizador compartilhado é ProcessNotificationBatch em tools/process_registry_notifications.py. Duas restrições de design vale lembrar:
- Nem o lote nem seu status de entrega são persistidos no system prompt. O ruído nunca entra no contexto do modelo — que é exatamente a metade disso que economiza tokens.
- Eventos endereçados precisam de um dono comprovável. Outra sessão viva não pode adotá-los. A entrega de delegação continua por seu próprio livro-razão durável de claim/complete: uma vez por delegação, em vez de uma vez por lote de processo.
Verificando você mesmo
Há uma sonda no repositório que você pode rodar localmente:
python3 evals/completion_backlog_probe.py /path/to/repo /tmp/out.jsonEla inicia filhos reais de shell em diretórios temporários, lê seus eventos de conclusão reais e dirige a CLI de produção, o poller da TUI e as rotas de notificação pós-turno (um sink de turno HTTP em loopback faz o papel de de fato enviar um prompt). Ela registra dispatches reais, mas não exercita inferência de modelo.
Atenção ao que ela mede: admissão de turno na fronteira da notificação, não economia de tokens. As duas coisas estão relacionadas, mas não são a mesma — menos lotes significa menos turnos e contexto mais curto, mas a sonda não calculará os caracteres que você economizou.
A versão curta
O valor aqui não é um recurso brilhante; é o ruído chegando em uma forma previsível. Conclusões prontas viram um turno, falhas ficam, resultados consumidos não voltam, watches e subagents mantêm sua própria ordem, e os lotes nunca chegam ao system prompt. Se você costuma disparar vários jobs em segundo plano, a diferença depois de atualizar é simples: um resumo está esperando, e você segue em frente.
O trabalho em segundo plano geralmente começa com jobs agendados — veja a referência do hermes cron. Se o próprio agendador está se comportando mal, cron doctor é a leitura mais próxima. E para saber como subagents são controlados e entregues em tempo real, veja orquestração de subagent ao vivo.