¿Ahogado entre avisos de «Job Finished»? Hermes ahora agrupa las completions de segundo plano ya listas en un solo turno
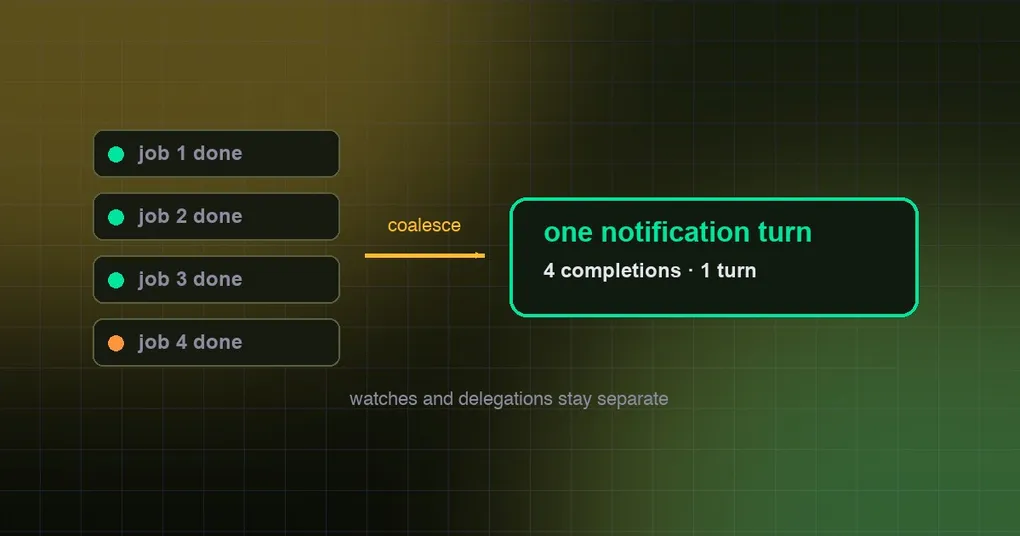
Arrancas tres jobs a la vez: uno corriendo la suite de tests, otro bajando dependencias, otro generando assets en segundo plano. Te vas a una reunión. Cuando vuelves, la pantalla es un muro de «job finished» — y cada uno arrancó su propio turno del modelo, cuando lo único que querías era «ya terminaron todos, sigue».
El problema nunca fueron las notificaciones en sí; era que cada notificación contaba como el inicio de una conversación aparte. Un cambio reciente lo ajusta: las completions de segundo plano que ya están listas ahora se agrupan en un solo turno de notificación en las superficies interactivas.
El comportamiento nuevo: las completions listas se convierten en un solo turno
La regla es corta. Las superficies de conversación agrupan en un único turno de notificación las completions consecutivas de procesos en segundo plano que ya están listas para una conversación. Los fallos se quedan en el lote junto a la salida correcta — las malas noticias no se separan. Y una completion individual conserva su texto original en lugar de quedar envuelta en un sobre de lote.
Una aclaración, porque es fácil malinterpretarlo: esto no es batching con retraso. El sistema no frena a quien termina antes para que se le unan más. Solo combina lo que ya está listo en ese momento, y no promete en ningún caso combinar jobs que terminan en momentos distintos. Así que no verás un test que terminó hace rato esperando en una notificación en lugar de despertar al agente.
Qué no se agrupa
El batching cubre los eventos de finalización de proceso en segundo plano. Dos cosas quedan deliberadamente fuera:
- Los resultados de watch (suscripciones a cambios de salida) y los resultados de delegación asíncrona siguen siendo notificaciones separadas, entregadas en su orden original.
- El messaging gateway — el bot que te responde en Telegram, Slack y compañía — mantiene su propio batching de ventana corta indexado por ruta. Este cambio no reemplaza ese mecanismo ni altera los envíos de los adaptadores.
El uso por script tampoco se ve afectado: los consumidores no interactivos, como una petición API, un cliente ACP o una llamada puntual por CLI, no ganan ningún bucle de notificación autónomo nuevo.
Los procesos consumidos ya no notifican
Esta es la parte más práctica del cambio y la más fácil de pasar por alto.
La identidad del proceso sigue disponible hasta el dispatch. Así que si ya tomaste explícitamente el resultado de un proceso en segundo plano — leyendo su log con process_manage, esperándolo o matándolo — la CLI no añadirá después un aviso de finalización, incluso si ese proceso ya salió del registro y está en la cola de entrada. Un lote totalmente consumido no arranca ningún turno.
En otras palabras: ir a mirar el resultado tú mismo se interpreta como decirle a Hermes «ya sé de este».
Quién se encarga de esto
El mismo comportamiento vive en módulos distintos según la superficie. Conocer el reparto ahorra tiempo cuando algo no cuadra:
| Superficie | Módulo | Qué hace |
|---|---|---|
| CLI clásica | hermes_cli/cli_process_notifications.py |
Se encarga del drenaje en idle y post-turn, de la propiedad consciente de la compresión y del desenvuelto final de la entrada |
| TUI y Desktop | tui_gateway/session_notifications.py |
Agrupa el snapshot de listos del poller tras comprobar la propiedad; cada proceso sigue emitiendo su propio estado en la UI; las sesiones ocupadas reencolan eventos estructurados en lugar de cadenas de lote ya renderizadas |
| TUI post-turn | tui_gateway/prompt_turn.py |
La misma ruta de enrutado y renderizado; los clientes de chat de desktop y dashboard comparten este backend |
El renderer compartido es ProcessNotificationBatch en tools/process_registry_notifications.py. Conviene recordar dos restricciones de diseño:
- Ni el lote ni su estado de entrega se persisten en el system prompt. El ruido nunca entra en el contexto del modelo — que es justo la mitad de esto que ahorra tokens.
- Los eventos dirigidos necesitan un dueño demostrable. Otra sesión viva no puede adoptarlos. La entrega de delegaciones sigue su propio ledger duradero de claim/complete: una vez por delegación en lugar de una vez por lote de procesos.
Cómo verificarlo tú mismo
Hay una sonda en el repositorio que puedes ejecutar en local:
python3 evals/completion_backlog_probe.py /path/to/repo /tmp/out.jsonArranca procesos shell hijos reales en directorios temporales, lee sus eventos de finalización reales y ejercita la CLI de producción, el poller de la TUI y las rutas de notificación post-turn (un turn sink HTTP en loopback hace de sustituto de enviar realmente un prompt). Registra dispatches reales, pero no ejercita la inferencia del modelo.
Ojo con lo que mide: la admisión de turnos en el límite de notificación, no el ahorro de tokens. Ambas cosas están relacionadas pero no son lo mismo — menos lotes significa menos turnos y un contexto más corto, pero la sonda no calculará los caracteres que ahorraste.
La versión corta
El valor aquí no es una feature vistosa; es que el ruido aterrice con una forma predecible. Las completions listas se convierten en un turno, los fallos se quedan, los resultados consumidos no vuelven, los watches y los subagentes mantienen su propio orden, y los lotes nunca llegan al system prompt. Si sueles lanzar varios jobs en segundo plano, la diferencia tras actualizar es simple: tienes un resumen esperando y sigues adelante.
El trabajo en segundo plano suele empezar por jobs programados — mira la referencia de hermes cron. Si el propio scheduler se porta mal, cron doctor es la lectura más cercana. Y para saber cómo se controlan y se entregan los subagentes en tiempo real, mira orquestación de subagentes en vivo.