Cinco segundos para responder um recado de uma palavra: três esperas silenciosas escondidas na entrega de mensagens do Hermes
Você faz uma pergunta curta para o seu assistente no WhatsApp — “onde ficam os logs?” — e ele responde uma palavra: ~/.hermes/logs. Você esperou cinco segundos por isso. Na mesma máquina, a mesma conversa no Telegram volta na hora. Existe uma versão pior também: você fecha o notebook e leva para casa, manda três tarefas do celular no caminho, e na manhã seguinte nada aconteceu. Suas mensagens continuam paradas no Telegram; o log do Hermes está completamente vazio.
Nenhuma das duas é uma “falha” no sentido estrito. Uma é só lenta; a outra é uma mensagem descartada em silêncio. Três mudanças mescladas em 19-20 de setembro (#117104, #116134, #116168) tratam exatamente dessa classe de problema: os que não têm mensagem de erro.
Por que uma resposta curta tinha de esperar cinco segundos inteiros
Os adapters de mensageria fazem buffer de texto: uma rajada de fragmentos que chega num instante é combinada em uma requisição só, para que uma colagem rápida em pedaços não dispare sete invocações separadas do agente. A pegadinha estava nos padrões e em como o atraso era calculado.
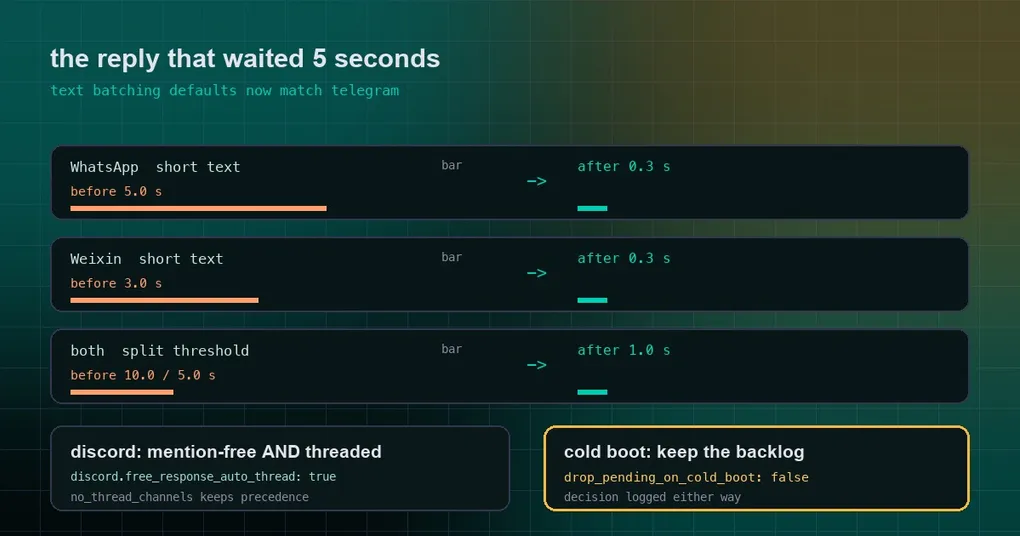
O adapter do WhatsApp usava text_batch_delay_seconds igual a 5,0 s por padrão e o do Weixin 3,0 s; e base.py::_text_batch_delay_for retorna esse atraso fixo para todo fragmento abaixo do limite de split. Uma resposta de duas palavras, portanto, pagava os cinco segundos inteiros, porque a janela de debounce não tem nada que a encerre antes. O custo dessa espera é inteiramente do usuário.
O PR #117104 alinha os dois adapters com a cadência do Telegram:
| Adapter | Atraso para texto curto (antes) | Atraso para texto curto (agora) | Atraso de split (antes → agora) |
|---|---|---|---|
| 5,0 s | 0,3 s | 10,0 s → 1,0 s | |
| Weixin | 3,0 s | 0,3 s | 5,0 s → 1,0 s |
Valores configurados agora também têm teto: o atraso é limitado a 2,0 s e o atraso de split a 4,0 s (igual à implementação do Telegram), e o atraso de split nunca pode ser menor que o próprio atraso. Um ponto para você julgar sozinho: se você configurou de propósito algo como 7 segundos, agora isso é limitado a 2,0.
gateway:
  platforms:
    whatsapp:
      extra:
        text_batch_delay_seconds: 0.5        # teto 2.0, piso 0
        text_batch_split_delay_seconds: 1.5  # teto 4.0, nunca abaixo do atraso acima
Definir o atraso como 0 ainda desativa o batching, despachando cada mensagem imediatamente.
Um cold boot não joga mais fora o que chegou enquanto você estava offline
A segunda é mais sorrateira. O connect() do adapter do Telegram passava drop_pending_updates=not is_reconnect — então qualquer processo novo mandava o Telegram descartar toda atualização enfileirada durante a queda.
Esse caminho é exatamente o caso comum: um notebook ligando, um reinício de contêiner, hermes gateway restart. Você manda instruções do celular de madrugada com a máquina desligada; o próximo boot as joga fora. Nenhum log, nenhum erro — o comando simplesmente nunca rodou, que é a metade “silenciosa” do relato.
Agora existe uma chave:
gateway:
  platforms:
    telegram:
      extra:
        drop_pending_on_cold_boot: false   # padrão true = comportamento de hoje
Com false, a primeira conexão coleta o backlog que o Telegram reteve (limitado pela janela de cerca de 24 horas dele). E a decisão é registrada nos dois casos (Cold boot: dropping|preserving …), então um comando que nunca rodou passa a ser rastreável.
Duas coisas de propósito não mudam: a escada de recuperação de conflito 409 ainda descarta atualizações pendentes (ela precisa disso, para expulsar a sessão getUpdates concorrente), e reconexões de watcher sempre as preservam. A chave vale para os dois caminhos de inicialização — polling e webhook — já que o comentário inline antigo que dizia que a flag de webhook era um no-op estava errado: o PTB a entrega para delete_webhook / set_webhook, que de fato descartam as atualizações armazenadas no Telegram.
Um canal sem exigência de menção volta a poder criar threads
A terceira é um ou-ou acidental. free_response_channels decide se uma @menção é obrigatória; auto_thread decide se cada conversa ganha a sua própria thread. São preocupações independentes — mas, depois que o padrão inline entrou, a primeira desativava a segunda em silêncio. Um canal podia, portanto, ser livre de menções (com todos os tópicos empilhados numa thread só) ou ter threads (mas exigindo uma menção a cada vez). Canais de comunidade e de suporte no Discord esbarraram nisso primeiro.
Agora existe um opt-in explícito:
# nível raiz do config.yaml (não dentro de platforms:)
discord:
  free_response_auto_thread: true    # padrão false — nada muda a menos que você defina
Isso afeta só o caminho de resposta livre, e a precedência existente continua intacta: no_thread_channels ainda vence por completo, canais vinculados a voz continuam inline, e um auto_thread: false global ainda desativa threading em todo lugar. A variável de ambiente correspondente é DISCORD_FREE_RESPONSE_AUTO_THREAD, e a chave YAML é ligada a ela.
O fio comum: silêncio
Junte as três e o modo de falha é idêntico: nenhuma exceção, nenhum aviso, só “por que não está acontecendo nada?” A resposta de cinco segundos é pura espera; as mensagens offline foram descartadas ativamente; o canal sem thread eram dois padrões independentes se anulando. Nada disso é visível pela UI. Então, ao depurar essa classe de problema, uma ordem que funciona é:
- Confirme que a mensagem sequer chegou ao Hermes — procure o registro de entrada no log do gateway.
- Se chegou mas a resposta é lenta, suspeite do batching: escreva
text_batch_delay_secondsexplicitamente em vez de confiar no padrão. - Se “nada aconteceu” depois de um cold boot, confira
drop_pending_on_cold_boote procure aquela linhaCold boot:.
Isso está disponível hoje?
Resposta honesta de novo: nenhuma release. As três mudanças foram mescladas em 19-20 de setembro de 2026, a release mais nova é a v0.21.3 (tag v2026.9.14), então elas estão só na main — hermes update ainda te dá o comportamento antigo e não vai reconhecer as chaves acima. A documentação (messaging/whatsapp.md, messaging/weixin.md, messaging/telegram.md, messaging/discord.md) foi atualizada junto.
O padrão
As três correções consertam o mesmo hábito: padrões decidindo em nome do usuário, sem deixar rastro. Um padrão de atraso é um número que servia à máquina de outra pessoa; descartar o backlog é obrigatório em alguns deployments e come suas instruções num notebook pessoal; duas chaves têm cada uma um padrão sensato que se anula quando combinado. Os remédios são simples — alinhe um padrão com uma cadência já comprovada e ponha um teto nele, devolva a escolha e registre no log a cada vez, e adicione um opt-in explícito em vez de trocar um padrão.
Se você está montando plataformas de mensageria, o picker inline do Telegram e entrega de mídia a partir de um sandbox combinam bem com este post; para saber como mensagens numa sala multi-bot ganham thread e vez, veja o texto sobre group chat.