Cinco segundos para responder a un mensaje de una palabra: tres esperas silenciosas escondidas en la entrega de mensajes de Hermes
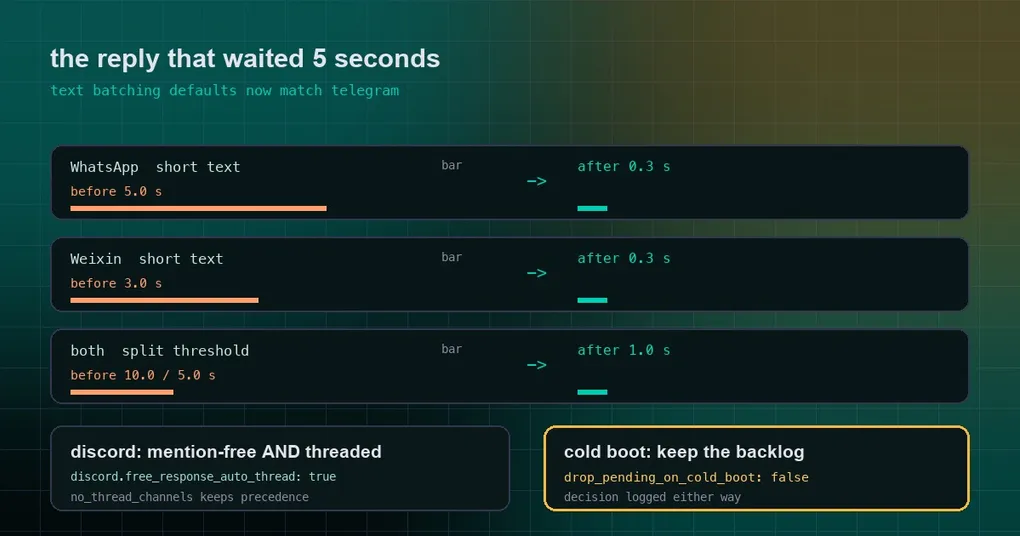
Le haces una pregunta corta a tu asistente por WhatsApp — «¿dónde están los logs?» — y responde con una sola palabra: ~/.hermes/logs. Has esperado cinco segundos por eso. En la misma máquina, ese mismo intercambio por Telegram vuelve al instante. También existe una versión peor: cierras el portátil y te lo llevas a casa, envías tres tareas desde el móvil de camino, y a la mañana siguiente no ha pasado nada. Tus mensajes siguen en Telegram y el log de Hermes está completamente vacío.
Ninguno de los dos es un «fallo» en sentido estricto. Uno simplemente va lento; el otro es un mensaje descartado en silencio. Tres cambios fusionados el 19 y 20 de septiembre (#117104, #116134, #116168) se ocupan exactamente de esta clase de problema: los que no dejan mensaje de error.
Por qué una respuesta corta tenía que esperar cinco segundos enteros
Los adaptadores de mensajería hacen buffering de texto: una ráfaga de fragmentos que llegan en un instante se combina en una sola petición, de modo que un pegado rápido partido en trozos no dispara siete invocaciones distintas del agente. La trampa estaba en los valores por defecto y en cómo se calculaba el retraso.
El adaptador de WhatsApp tenía text_batch_delay_seconds en 5,0 s por defecto y Weixin en 3,0 s; y base.py::_text_batch_delay_for devuelve ese retraso plano para cada fragmento por debajo del umbral de split. Una respuesta de dos palabras pagaba por tanto los cinco segundos completos, porque la ventana de debounce no tiene nada que la cierre antes. El coste de esa espera recae enteramente en el usuario.
El PR #117104 alinea ambos adaptadores con la cadencia de Telegram:
| Adaptador | Retraso para texto corto (antes) | Retraso para texto corto (ahora) | Retraso de split (antes → ahora) |
|---|---|---|---|
| 5,0 s | 0,3 s | 10,0 s → 1,0 s | |
| Weixin | 3,0 s | 0,3 s | 5,0 s → 1,0 s |
Los valores configurados ahora también tienen techo: el retraso se recorta a 2,0 s y el de split a 4,0 s (igual que en la implementación de Telegram), y el retraso de split nunca puede ser inferior al retraso base. Una cosa que debes juzgar tú mismo: si configuraste a propósito algo como 7 segundos, ahora se recorta a 2,0.
gateway:
  platforms:
    whatsapp:
      extra:
        text_batch_delay_seconds: 0.5        # techo 2.0, mínimo 0
        text_batch_split_delay_seconds: 1.5  # techo 4.0, nunca por debajo del retraso de arriba
Poner el retraso a 0 sigue desactivando el batching y despacha cada mensaje de inmediato.
Un arranque en frío ya no tira lo que llegó mientras estabas offline
El segundo es más traicionero. El connect() del adaptador de Telegram pasaba drop_pending_updates=not is_reconnect, así que cualquier proceso nuevo le decía a Telegram que descartara todas las actualizaciones en cola durante la caída.
Ese camino es exactamente el caso habitual: un portátil que se enciende, un contenedor que se reinicia, hermes gateway restart. Envías instrucciones desde el móvil por la noche, con la máquina apagada, y el siguiente arranque las descarta. Sin log, sin error: el comando simplemente nunca se ejecutó, que es la mitad «silenciosa» del informe.
Ahora existe un interruptor:
gateway:
  platforms:
    telegram:
      extra:
        drop_pending_on_cold_boot: false   # por defecto true = el comportamiento actual
Con false, la primera conexión recoge el backlog que Telegram retuvo (limitado por su ventana de unas 24 horas). Y la decisión acaba en el log en ambos casos (Cold boot: dropping|preserving …), así que un comando que nunca se ejecutó pasa a ser rastreable.
Dos cosas no cambian a propósito: la escalera de recuperación del conflicto 409 sigue descartando actualizaciones pendientes (tiene que hacerlo, para expulsar la sesión competidora de getUpdates), y las reconexiones del watcher siempre las conservan. La clave aplica a ambos caminos de arranque — polling y webhook — porque el antiguo comentario en línea que afirmaba que la flag de webhook era un no-op estaba equivocado: PTB se la pasa a delete_webhook / set_webhook, que sí descartan las actualizaciones almacenadas de Telegram.
Un canal sin menciones puede volver a tener hilos
El tercero es un either/or accidental. free_response_channels decide si se exige una @mención; auto_thread decide si cada conversación tiene su propio hilo. Son cuestiones independientes, pero en cuanto aterrizó el valor por defecto en línea, el primero desactivó el segundo en silencio. Un canal podía por tanto quedar libre de menciones (con todos los temas apilados en un solo hilo) o con hilos (pero exigiendo una mención cada vez). Los canales de comunidad y soporte en Discord fueron los primeros en topárselo.
Ahora hay un opt-in explícito:
# nivel superior de config.yaml (no dentro de platforms:)
discord:
  free_response_auto_thread: true    # por defecto false — nada cambia salvo que lo pongas
Solo afecta a la ruta de respuesta libre, y la precedencia existente no se toca: no_thread_channels sigue ganando sin discusión, los canales vinculados a voz se quedan en línea y un auto_thread: false global sigue desactivando los hilos en todas partes. La variable de entorno correspondiente es DISCORD_FREE_RESPONSE_AUTO_THREAD, y la clave de YAML se puentea hacia ella.
El hilo común: el silencio
Junta los tres y el modo de fallo es idéntico: ninguna excepción, ningún aviso, solo «¿por qué no pasa nada?». La respuesta de cinco segundos es una espera pura; los mensajes offline se descartaron activamente; el canal sin hilos era el resultado de dos valores por defecto que se anulaban entre sí. Nada de eso es visible desde la interfaz. Así que, cuando depures esta clase de problema, un orden que funciona es:
- Confirma que el mensaje llegó siquiera a Hermes: busca el registro de entrada en el log del gateway.
- Si llegó pero la respuesta tarda, sospecha del batching: escribe
text_batch_delay_secondsexplícitamente en lugar de fiarte del valor por defecto. - Si «no pasó nada» tras un arranque en frío, revisa
drop_pending_on_cold_booty busca esa líneaCold boot:.
¿Está disponible hoy?
Respuesta sincera otra vez: no hay release. Los tres cambios se fusionaron el 19 y 20 de septiembre de 2026, la release más reciente es la v0.21.3 (tag v2026.9.14), así que están solo en main: hermes update te sigue dando el comportamiento antiguo y no reconocerá las claves de arriba. La documentación (messaging/whatsapp.md, messaging/weixin.md, messaging/telegram.md, messaging/discord.md) se actualizó junto con ellos.
El patrón
Los tres arreglos corrigen la misma costumbre: valores por defecto decidiendo en nombre del usuario, sin dejar rastro. Un retraso por defecto es un número que le venía bien a la máquina de otra persona; descartar el backlog es obligatorio en algunos despliegues y se come tus instrucciones en un portátil personal; y hay dos claves que tienen cada una un valor por defecto sensato pero que se anulan al combinarse. Los remedios son simples: alinear un valor por defecto con una cadencia ya probada y acotarlo, devolver la decisión al usuario y registrarla siempre, y añadir un opt-in explícito en vez de darle la vuelta a un valor por defecto.
Si estás montando plataformas de mensajería, el selector inline de Telegram y la entrega de medios desde un sandbox encajan bien con este artículo; para saber cómo se reparten hilos y turnos los mensajes en una sala con varios bots, mira el artículo sobre el chat de grupo.