Cinq secondes pour répondre en un mot : trois attentes silencieuses cachées dans la livraison de messages Hermes
Vous posez une question courte à votre assistant sur WhatsApp — « où sont les logs ? » — et il répond en un mot : ~/.hermes/logs. Vous avez attendu cinq secondes pour ça. Sur la même machine, le même échange via Telegram revient instantanément. Il existe une version pire : vous fermez le portable et le ramenez à la maison, vous lui envoyez trois tâches depuis votre téléphone en route, et le lendemain matin rien ne s’est passé. Vos messages sont encore dans Telegram ; le log de Hermes est complètement vide.
Ni l’un ni l’autre n’est un « échec » au sens strict. L’un est simplement lent ; l’autre est un message silencieusement jeté. Trois changements fusionnés les 19 et 20 septembre (#117104, #116134, #116168) traitent exactement cette classe de problème : ceux qui n’ont aucun message d’erreur.
Pourquoi une réponse courte devait attendre cinq longues secondes
Les adaptateurs de messagerie tamponnent le texte : une rafale de fragments arrivant en un instant est combinée en une seule requête, pour qu’un collage rapide découpé ne déclenche pas sept invocations d’agent séparées. Le piège était dans les valeurs par défaut et dans le calcul du délai.
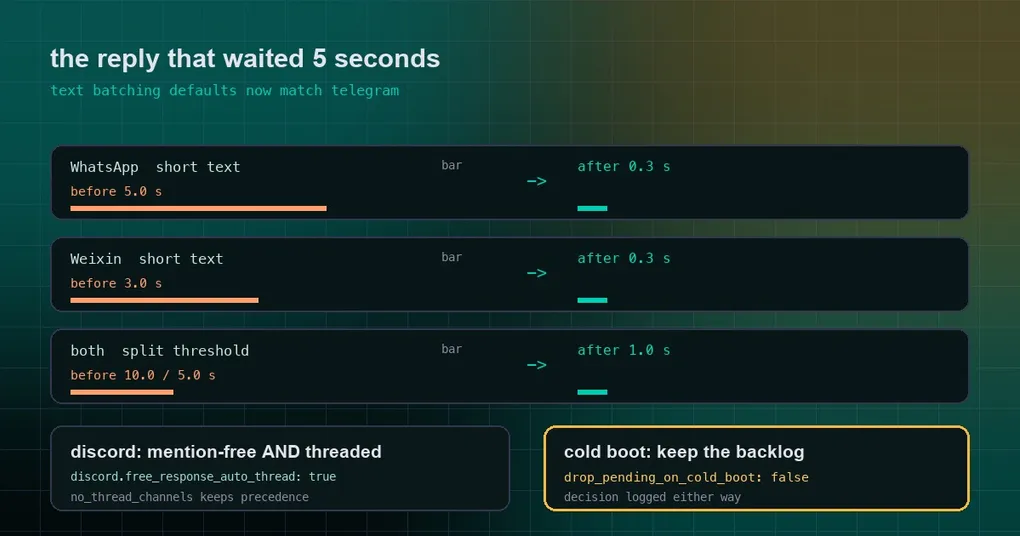
L’adaptateur WhatsApp mettait text_batch_delay_seconds à 5,0 s par défaut et Weixin à 3,0 s ; et base.py::_text_batch_delay_for renvoie ce délai fixe pour chaque fragment sous le seuil de découpage. Une réponse de deux mots payait donc les cinq secondes complètes, parce que la fenêtre de debounce n’a rien qui pourrait la clore plus tôt. Le coût de cette attente est entièrement à la charge de l’utilisateur.
Le PR #117104 aligne les deux adaptateurs sur la cadence de Telegram :
| Adaptateur | Délai texte court (avant) | Délai texte court (maintenant) | Délai de découpage (avant → maintenant) |
|---|---|---|---|
| 5,0 s | 0,3 s | 10,0 s → 1,0 s | |
| Weixin | 3,0 s | 0,3 s | 5,0 s → 1,0 s |
Les valeurs configurées ont désormais des plafonds : le délai est plafonné à 2,0 s et le délai de découpage à 4,0 s (comme dans l’implémentation de Telegram), et le délai de découpage ne peut jamais être inférieur au délai lui-même. Un point à juger par vous-même : si vous avez délibérément configuré quelque chose comme 7 secondes, c’est maintenant plafonné à 2,0.
gateway:
  platforms:
    whatsapp:
      extra:
        text_batch_delay_seconds: 0.5        # plafond 2.0, plancher 0
        text_batch_split_delay_seconds: 1.5  # plafond 4.0, jamais sous le délai ci-dessus
Mettre le délai à 0 désactive toujours le batching, en distribuant chaque message immédiatement.
Un démarrage à froid ne jette plus ce qui est arrivé pendant votre absence
Le deuxième est plus sournois. Le connect() de l’adaptateur Telegram passait drop_pending_updates=not is_reconnect — donc tout processus frais demandait à Telegram d’écarter chaque update mis en file pendant l’interruption.
Ce chemin est exactement le cas courant : un portable qui démarre, un conteneur qui redémarre, hermes gateway restart. Vous envoyez des instructions depuis votre téléphone la nuit pendant que la machine est éteinte ; le démarrage suivant les jette. Aucun log, aucune erreur — la commande ne s’est simplement jamais exécutée, ce qui constitue la moitié « silencieuse » du rapport.
Il y a désormais un interrupteur :
gateway:
  platforms:
    telegram:
      extra:
        drop_pending_on_cold_boot: false   # défaut true = comportement actuel
Avec false, la première connexion récupère le backlog que Telegram a conservé (borné par sa fenêtre d’environ 24 heures). Et la décision est journalisée dans les deux cas (Cold boot: dropping|preserving …), donc une commande jamais exécutée devient traçable.
Deux choses ne changent délibérément pas : l’échelle de récupération sur conflit 409 jette toujours les updates en attente (elle y est obligée, pour évincer la session getUpdates concurrente), et les reconnexions du watcher les préservent toujours. La clé s’applique aux deux chemins de démarrage — polling et webhook — car l’ancien commentaire en ligne affirmant que le flag webhook ne faisait rien était faux : PTB le transmet à delete_webhook / set_webhook, qui eux jettent bien les updates stockés par Telegram.
Un canal sans mention peut de nouveau créer des fils
Le troisième est un « soit l’un soit l’autre » accidentel. free_response_channels décide si une @mention est requise ; auto_thread décide si chaque conversation obtient son propre fil. Ce sont des préoccupations indépendantes — mais une fois la valeur par défaut en ligne arrivée, la première désactivait silencieusement la seconde. Un canal pouvait donc être sans mention (avec tous les sujets empilés dans un seul fil) ou en fils (mais en exigeant une mention à chaque fois). Les canaux communautaires et de support sur Discord ont touché ça les premiers.
Il existe désormais un opt-in explicite :
# au niveau racine de config.yaml (pas sous platforms:)
discord:
  free_response_auto_thread: true    # défaut false — rien ne change tant que vous ne le mettez pas
Cela n’affecte que le chemin de réponse libre, et la précédence existante est intacte : no_thread_channels gagne toujours sans condition, les canaux liés à la voix restent en ligne, et un auto_thread: false global désactive toujours les fils partout. La variable d’environnement correspondante est DISCORD_FREE_RESPONSE_AUTO_THREAD, et la clé YAML y est reliée.
Le fil commun : le silence
Mettez les trois ensemble et le mode de défaillance est identique : aucune exception, aucun avertissement, juste « pourquoi rien ne se passe ? » La réponse en cinq secondes est une attente pure ; les messages hors ligne ont été activement jetés ; le canal sans fil était deux valeurs par défaut indépendantes qui s’annulaient. Rien de tout cela n’est visible depuis l’UI. Donc quand vous déboguez cette classe de problème, un ordre praticable est :
- Confirmez que le message est bien arrivé jusqu’à Hermes — cherchez l’enregistrement entrant dans le log du gateway.
- S’il est arrivé mais que la réponse est lente, soupçonnez le batching : écrivez
text_batch_delay_secondsexplicitement au lieu de compter sur la valeur par défaut. - Si « rien ne s’est passé » après un démarrage à froid, vérifiez
drop_pending_on_cold_bootet cherchez la ligneCold boot:.
Est-ce disponible aujourd’hui ?
Réponse honnête là encore : aucune release. Les trois changements ont été fusionnés les 19-20 septembre 2026, la dernière release est v0.21.3 (tag v2026.9.14), donc ils sont sur main uniquement — hermes update vous donne toujours l’ancien comportement et ne reconnaîtra pas les clés ci-dessus. La doc (messaging/whatsapp.md, messaging/weixin.md, messaging/telegram.md, messaging/discord.md) a été mise à jour en même temps.
Le schéma
Les trois correctifs corrigent la même habitude : des valeurs par défaut qui décident à la place de l’utilisateur, sans laisser de trace. Un délai par défaut est un nombre qui convenait à la machine de quelqu’un d’autre ; jeter le backlog est obligatoire sur certains déploiements et mange vos instructions sur un portable personnel ; deux clés ont chacune une valeur par défaut sensée qui s’annule quand on les combine. Les remèdes sont simples — aligner une valeur par défaut sur une cadence déjà éprouvée et la plafonner, rendre le choix à l’utilisateur et le journaliser chaque fois, et ajouter un opt-in explicite plutôt que de retourner une valeur par défaut.
Si vous câblez des plateformes de messagerie, le sélecteur inline Telegram et la livraison de médias depuis un sandbox complètent bien cet article ; pour comprendre comment les messages d’une salle multi-bots obtiennent leurs fils et leur tour de parole, voir l’article sur le chat de groupe.