Fünf Sekunden für eine Ein-Wort-Antwort: drei stille Wartezeiten in der Nachrichtenzustellung von Hermes
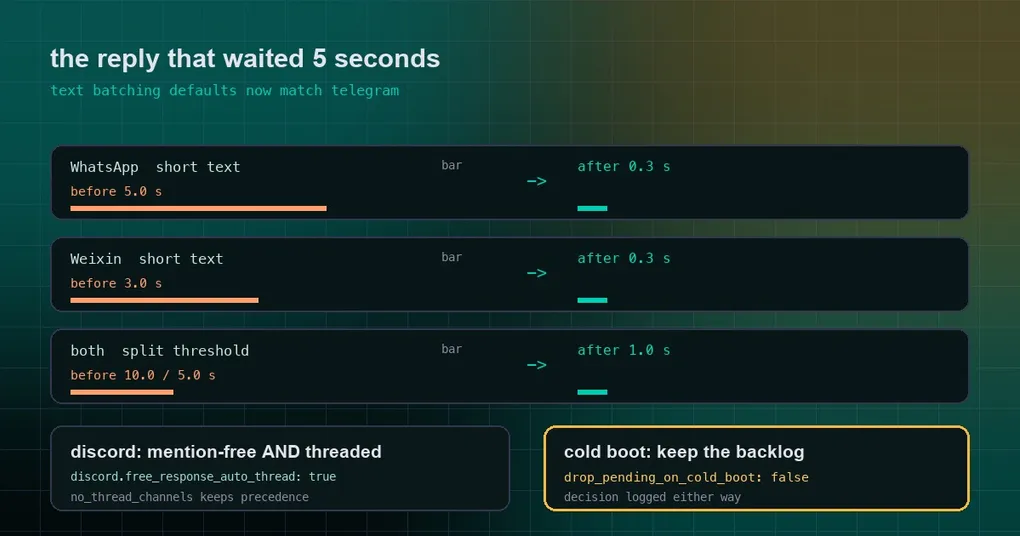
Du stellst deinem Assistenten auf WhatsApp eine kurze Frage — „wo liegen die Logs?“ — und bekommst ein Wort zurück: ~/.hermes/logs. Darauf hast du fünf Sekunden gewartet. Auf derselben Maschine kommt derselbe Austausch über Telegram sofort zurück. Es gibt auch eine schlimmere Variante: Du klappst den Laptop zu und nimmst ihn mit nach Hause, schickst vom Handy unterwegs drei Aufträge, und am nächsten Morgen ist nichts passiert. Deine Nachrichten liegen noch in Telegram, das Log von Hermes ist völlig leer.
Beides ist im strengen Sinn kein „Fehler“. Das eine ist nur langsam, das andere eine Nachricht, die still verworfen wird. Drei am 19.–20. September gemergte Änderungen (#117104, #116134, #116168) behandeln genau diese Problemklasse: die ohne Fehlermeldung.
Warum eine kurze Antwort fünf volle Sekunden warten musste
Messaging-Adapter puffern Text: Ein Schub von Fragmenten, der innerhalb eines Moments eintrifft, wird zu einer Anfrage zusammengefasst, damit ein schnelles Paste-Split nicht sieben separate Agent-Aufrufe auslöst. Der Haken lag in den Defaults und in der Art, wie die Verzögerung berechnet wurde.
Der WhatsApp-Adapter setzte text_batch_delay_seconds per Default auf 5,0 s, Weixin auf 3,0 s; und base.py::_text_batch_delay_for gibt diese pauschale Verzögerung für jedes Fragment unterhalb der Split-Schwelle zurück. Eine Zwei-Wort-Antwort bezahlte also die vollen fünf Sekunden, weil das Debounce-Fenster nichts hat, was es früher beenden würde. Die Kosten dieser Wartezeit trägt komplett der Nutzer.
PR #117104 gleicht beide Adapter an den Telegram-Takt an:
| Adapter | Verzögerung bei kurzem Text (vorher) | Verzögerung bei kurzem Text (jetzt) | Split-Verzögerung (vorher → jetzt) |
|---|---|---|---|
| 5,0 s | 0,3 s | 10,0 s → 1,0 s | |
| Weixin | 3,0 s | 0,3 s | 5,0 s → 1,0 s |
Konfigurierte Werte haben jetzt ebenfalls Obergrenzen: Die Verzögerung wird bei 2,0 s gekappt, die Split-Verzögerung bei 4,0 s (passend zu Telegrams Implementierung), und die Split-Verzögerung darf nie unter der Verzögerung selbst liegen. Eine Sache musst du selbst beurteilen: Wenn du absichtlich etwa 7 Sekunden konfiguriert hattest, wird das jetzt auf 2,0 gekappt.
gateway:
  platforms:
    whatsapp:
      extra:
        text_batch_delay_seconds: 0.5        # Obergrenze 2.0, Untergrenze 0
        text_batch_split_delay_seconds: 1.5  # Obergrenze 4.0, nie unter der Verzögerung oben
Ein Wert von 0 schaltet das Batching weiterhin ab und stellt jede Nachricht sofort zu.
Ein Kaltstart wirft nicht mehr weg, was während deiner Offline-Zeit ankam
Der zweite ist heimtückischer. connect() im Telegram-Adapter übergab drop_pending_updates=not is_reconnect — jeder frische Prozess wies Telegram also an, jedes während der Auszeit eingereihte Update zu verwerfen.
Genau dieser Pfad ist der Normalfall: Ein Laptop, der hochfährt, ein Container-Neustart, hermes gateway restart. Du schickst nachts Anweisungen vom Handy, während die Maschine aus ist; der nächste Boot verwirft sie. Kein Log, kein Fehler — der Befehl lief einfach nie, und das ist die „stille“ Hälfte des Reports.
Es gibt jetzt einen Schalter:
gateway:
  platforms:
    telegram:
      extra:
        drop_pending_on_cold_boot: false   # Default true = heutiges Verhalten
Mit false holt die erste Verbindung den Rückstand ab, den Telegram vorgehalten hat (begrenzt durch dessen Fenster von rund 24 Stunden). Und die Entscheidung wird in beiden Fällen geloggt (Cold boot: dropping|preserving …), sodass ein Befehl, der nie lief, nachvollziehbar wird.
Zwei Dinge ändern sich bewusst nicht: Die 409-Konflikt-Recovery-Leiter verwirft weiterhin ausstehende Updates (das muss sie, um die konkurrierende getUpdates-Session zu verdrängen), und Watcher-Reconnects bewahren sie immer. Der Key gilt für beide Startpfade — Polling und Webhook —, denn der alte Inline-Kommentar, der das Webhook-Flag als No-op bezeichnete, war falsch: PTB reicht es an delete_webhook / set_webhook weiter, die die gespeicherten Updates von Telegram tatsächlich verwerfen.
Ein Channel ohne Mention kann wieder Threads bekommen
Der dritte ist ein versehentliches Entweder-oder. free_response_channels entscheidet, ob eine @mention nötig ist; auto_thread entscheidet, ob jede Konversation ihren eigenen Thread bekommt. Das sind unabhängige Belange — doch sobald der Inline-Default einzog, deaktivierte der erste still den zweiten. Ein Channel konnte also entweder mention-frei sein (und alle Themen landeten in einem einzigen Thread) oder gethreadet (aber mit Mention-Pflicht bei jedem Mal). Community- und Support-Channels auf Discord traf das zuerst.
Es gibt jetzt ein explizites Opt-in:
# config.yaml auf oberster Ebene (nicht unter platforms:)
discord:
  free_response_auto_thread: true    # Default false — nichts ändert sich, solange du es nicht setzt
Es wirkt nur auf den Free-Response-Pfad, und die bestehende Vorrangregel bleibt unangetastet: no_thread_channels gewinnt weiterhin uneingeschränkt, sprachgebundene Channels bleiben inline, und ein globales auto_thread: false deaktiviert Threading weiterhin überall. Die passende Umgebungsvariable ist DISCORD_FREE_RESPONSE_AUTO_THREAD, und der YAML-Key ist damit überbrückt.
Der gemeinsame Nenner: Stille
Nimmt man die drei zusammen, ist das Fehlerbild identisch: Keine Exception, keine Warnung, nur „warum passiert nichts?“ Die Fünf-Sekunden-Antwort ist reines Warten; die Offline-Nachrichten wurden aktiv verworfen; der ungethreadete Channel war der Fall zweier unabhängiger Defaults, die sich gegenseitig aufheben. Nichts davon ist aus der UI erkennbar. Wenn du diese Problemklasse debuggst, ist eine brauchbare Reihenfolge:
- Prüfe, ob die Nachricht Hermes überhaupt erreicht hat — suche den Inbound-Record im Gateway-Log.
- Ist sie angekommen, aber die Antwort ist langsam, verdächtige das Batching: Schreibe
text_batch_delay_secondsexplizit hin, statt auf den Default zu vertrauen. - Ist nach einem Kaltstart „nichts passiert“, prüfe
drop_pending_on_cold_bootund suche die ZeileCold boot:.
Ist das heute verfügbar?
Wieder die ehrliche Antwort: kein Release. Die drei Änderungen wurden am 19.–20. September 2026 gemergt, der neueste Release ist v0.21.3 (Tag v2026.9.14), sie sind also nur auf main — hermes update liefert dir weiterhin das alte Verhalten und kennt die oben genannten Keys nicht. Die Docs (messaging/whatsapp.md, messaging/weixin.md, messaging/telegram.md, messaging/discord.md) wurden parallel dazu aktualisiert.
Das Muster
Alle drei Fixes korrigieren dieselbe Gewohnheit: Defaults entscheiden für den Nutzer, ohne eine Spur zu hinterlassen. Ein Delay-Default ist eine Zahl, die zu irgendeiner anderen Maschine passte; das Verwerfen des Rückstands ist in manchen Deployments Pflicht und frisst auf einem persönlichen Laptop deine Anweisungen; zwei Keys haben jeweils einen vernünftigen Default, die sich kombiniert gegenseitig aufheben. Die Gegenmittel sind schlicht — einen Default an einen bereits bewährten Takt angleichen und ihn kappen, die Wahl zurückgeben und sie jedes Mal loggen, und ein explizites Opt-in hinzufügen, statt einen Default umzudrehen.
Wenn du Messaging-Plattformen anbindest, passen der Telegram-Inline-Picker und Media-Zustellung aus einer Sandbox gut zu diesem Beitrag; wie Nachrichten in einem Multi-Bot-Raum Threads und Zugreihenfolge bekommen, steht im Group-Chat-Beitrag.