Dein Bot hat zweimal geantwortet — lief das Modell zweimal?
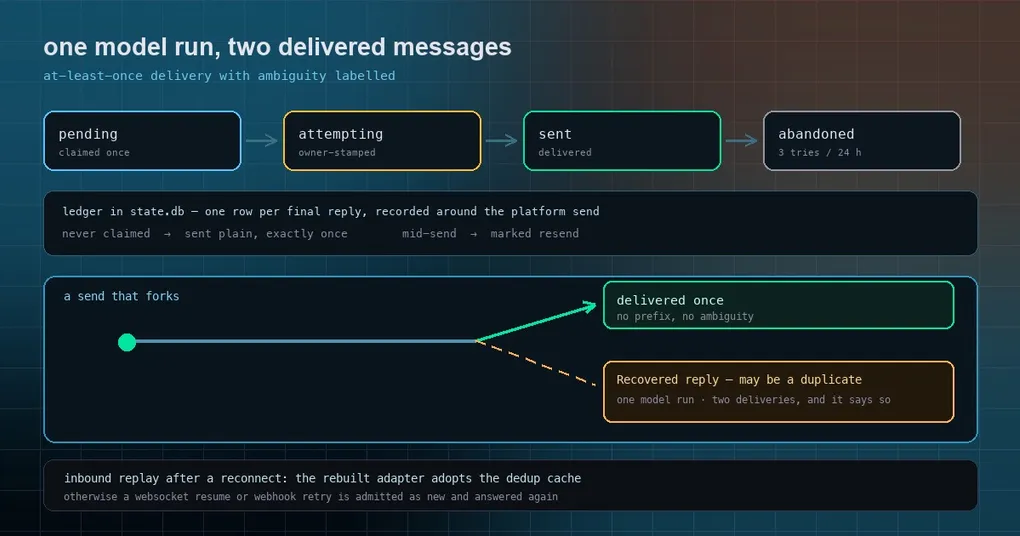
Du fragst deinen Bot in einem Gruppenchat etwas, bekommst eine Antwort, und dann — zehn Minuten später, direkt nachdem du das Gateway neu gestartet hast — kommt dieselbe Antwort noch einmal. Dein erster Gedanke gilt dem Geld: Lief das Modell zweimal, und habe ich zweimal bezahlt? Dein zweiter Gedanke gilt dem Vertrauen: Wenn es jetzt zweimal antwortet, was wiederholt es sonst noch?
Beide Fragen haben konkrete Antworten, und der Mechanismus dahinter gehört zu den sorgfältiger entworfenen Teilen des Gateways. Zwei Bugs darin wurden diese Woche gefixt (#120444 und #120450), also ist jetzt ein guter Moment zu verstehen, was du da eigentlich vor dir hast.
Das Delivery-Ledger, in einfachen Worten
Um jeden Send an eine Plattform herum schreibt Hermes die finale Antwort in ein dauerhaftes Delivery-Ledger in state.db. Wenn das Gateway zwischen dem Erzeugen einer Antwort und der Empfangsbestätigung der Plattform abstürzt oder neu startet, hat der nächste Boot drei Möglichkeiten: die Antwort verlieren, den ganzen Turn neu laufen lassen (teuer und möglicherweise falsch) oder das zustellen, was gespeichert wurde. Es stellt zu.
Die Semantik ist bewusst ehrlich statt clever — at-least-once, mit Etikett für Mehrdeutigkeit statt Rätselraten:
- Eine Antwort, deren Send nie begonnen hat, wird unverändert erneut zugestellt, ohne Zusatz. Diese kann man gefahrlos genau einmal senden.
- Eine Antwort, die mitten im Send war, als das Gateway starb — die Plattform hat sie vielleicht oder vielleicht auch nicht erhalten —, wird mit dem sichtbaren Präfix
♻️ Recovered reply — … may be a duplicateerneut zugestellt. - Ein Send, der vom Flood Control abgelehnt wurde (etwa Telegram Rate Limits), wird nach Ablauf der aufgezeichneten Strafe automatisch erneut versucht, ohne Reconnect oder Neustart, und das Recovery-Präfix warnt, dass frühere Chunks bereits angekommen sein können. Das Ledger kann aus der Nachrichtenlänge keine Teillieferung ableiten, deshalb sagt es das ausdrücklich.
- Jeder andere abgelehnte finale Send — ein 5xx der Plattform, ein unklassifizierter Fehler — wird nach wachsendem Backoff von 30 Sekunden, dann zwei Minuten erneut versucht. Der letzte budgetierte Versuch bleibt für den nächsten Gateway-Start liegen, sodass ein Ausfall, der den Timer überlebt, die Antwort nie stranden lässt. Ein dauerhaft unerreichbarer Chat (geblockter Bot, gelöschte Gruppe) wird gar nicht erneut versucht.
Die Redelivery ist begrenzt: drei Versuche und 24 Stunden Frische, danach wird die Zeile verworfen. Zugestellte Zeilen werden nach sieben Tagen aufgeräumt. Retries behalten das ursprüngliche Bot-Profil, den Chat und den Thread, und ein multiplexed Gateway behält die Antworten jedes bedienten Profils in dem Home, in dem es gestartet wurde.
Was dir der Marker sagt
Das ist die praktische Erkenntnis: ein etikettiertes Duplikat heißt, das Modell lief nicht zweimal. Das Gateway hat erkannt, dass ein Send bereits unterwegs war, und sich entschieden, die gespeicherte Antwort erneut zu senden, statt den Turn neu zu laufen. Die Antwort, die du zweimal siehst, ist ein Modell-Run, zweimal zugestellt, mit einem Präfix, das es zugibt.
Wenn du also eine doppelte Antwort bekommst, schau nach dem ♻️ Recovered reply-Präfix, bevor du deine Provider-Rechnung verantwortlich machst. Ist es da, lautet die ehrliche Bilanz: doppelte Nachricht, nicht doppelte Ausgaben. Ist es nicht da und trennt ein Neustart die beiden Antworten, dann hat dich der Bug unten erwischt.
Bug eins: ein Crash mitten in der Redelivery schickte eine zweite, unmarkierte Kopie
Das Ledger markiert Zeilen, während es sie beansprucht. Ein Gateway, das getötet wurde, während sein Boot-Sweep eine gespeicherte Antwort erneut zustellte, ließ früher eine Zeile zurück, die der nächste Boot erneut beanspruchen und ohne das Recovery-Präfix senden konnte — das schlechteste Ergebnis, weil das Duplikat unmarkiert und damit nicht von einem echten zweiten Run zu unterscheiden war.
Der Fix verschiebt jede beanspruchte Zeile innerhalb desselben Owner-Stamp-Compare-and-Swap, mit dem sie beansprucht wird, auf attempting. Vorher bekamen nur Flood-Zeilen diese Behandlung. Die needs_marker-Entscheidung liest weiterhin den Pre-Claim-Zustand der Zeile, sodass eine nie beanspruchte Zeile weiterhin schlicht und genau einmal rausgeht — das Verhalten, das der erste Punkt oben verspricht, bleibt erhalten und wird nicht eingetauscht. Eine übrig gebliebene pending-Zeile mit attempts größer null, die ein älterer Build schon beansprucht und möglicherweise gesendet hatte, wird jetzt ebenfalls markiert.
Es gab eine Schwester-Race im selben Mechanismus: Eine beim Boot beanspruchte failed-Zeile blieb failed und im Besitz des laufenden Prozesses, während ihr Boot-Send unterwegs war. Der Runtime-Reconnect-Sweep — der failed-Zeilen nimmt — konnte sie dann beanspruchen und ein zweites Mal senden. Die Zeile bleibt jetzt für den gesamten Send attempting, sodass der Boot-Claim exklusiv ist.
Bug zwei: ein reconnected Adapter vergaß, was er schon gesehen hatte
Das zweite Duplikat hatte nichts mit der ausgehenden Zustellung zu tun. Wenn eine Verbindung zu einer Messaging-Plattform abreißt, ersetzt der Reconnect-Watcher des Gateways den fehlgeschlagenen Adapter durch eine neue Instanz. Die Inbound-Deduplizierung — der MessageDeduplicator, der eine eingehende Nachrichten-ID verwirft, die er schon gesehen hat — lebte auf der Adapter-Instanz. Ein brandneuer Adapter startete also mit leerem Cache.
Das ist relevant, weil Plattformen wiederholen. Ein Websocket-Resume, ein Webhook-Retry oder ein unbestätigter Poll-Batch kann dieselbe eingehende Nachricht direkt nach dem Reconnect erneut ausliefern. Mit leerem Cache nahm das Gateway sie als neu an, lief einen Turn und antwortete ein zweites Mal.
Der Fix speist die Dedup-Caches des neu aufgebauten Adapters aus der Instanz, die er ersetzt, und übernimmt die noch lebenden IDs mit ihren ursprünglichen Seen-Zeiten. Das Subtile daran ist „lebend“: Der Cache-Eintrag behält seinen ursprünglichen Timestamp, statt aufgefrischt zu werden, damit sich das Dedup-Fenster nicht still verlängert, nur weil der Adapter neu aufgebaut wurde. Es ist ein kleiner, vollständiger Fix für eine ganze Familie von „warum hat es zweimal geantwortet“-Meldungen.
Was du dagegen tun kannst
- Lies zuerst den Marker. Ein
♻️ Recovered reply-Präfix heißt: ein Modell-Run, zwei Zustellungen. Budgetmäßig bist du auf der sicheren Seite; dupliziert ist die Antwort, nicht die Ausgabe. - Unmarkierte Duplikate nach einem Neustart oder Reconnect sind genau das, wogegen diese beiden Fixes arbeiten.
mainzu ziehen — oder auf das nächste getaggte Release zu warten, da beide nach v0.21.4 gelandet sind — ist das Mittel der Wahl. - Wenn du lieber eine Antwort verlierst, als je ein Duplikat zu erzeugen, schaltet
gateway.delivery_ledger: falsedas Ledger ab und stellt das ältere Verhalten wieder her: Antworten, die gerade unterwegs sind, gehen bei einem Crash verloren. Das ist ein echter Trade-off, kein kostenloser Schalter — für einen Bot, bei dem ein Duplikat inakzeptabel und eine verlorene Antwort akzeptabel ist, ist er richtig; für einen Support-Bot wahrscheinlich nicht. - Sonst gibt es nichts zu konfigurieren. Es gibt kein Dedup-Fenster zum Tunen und keine Retry-Anzahl zum Setzen; die Grenzen oben sind das Design.
Das größere Bild dazu, wie Antworten eine Plattform erreichen, findest du in unserem Messaging-Delivery-Cadence-Guide (Batching und Backlog-Verhalten), dazu Media Attachment Delivery für Dateien und Bilder und Background Notification Batching dafür, wie geplante Arbeit zurückmeldet. Wenn du ein Gateway betreibst, das unerwartet neu startet, erklärt der Loop-Watchdog-Guide den Recovery-Pfad, den ein neu startendes Gateway durchläuft.