Votre bot a répondu deux fois — le modèle a-t-il tourné deux fois ?
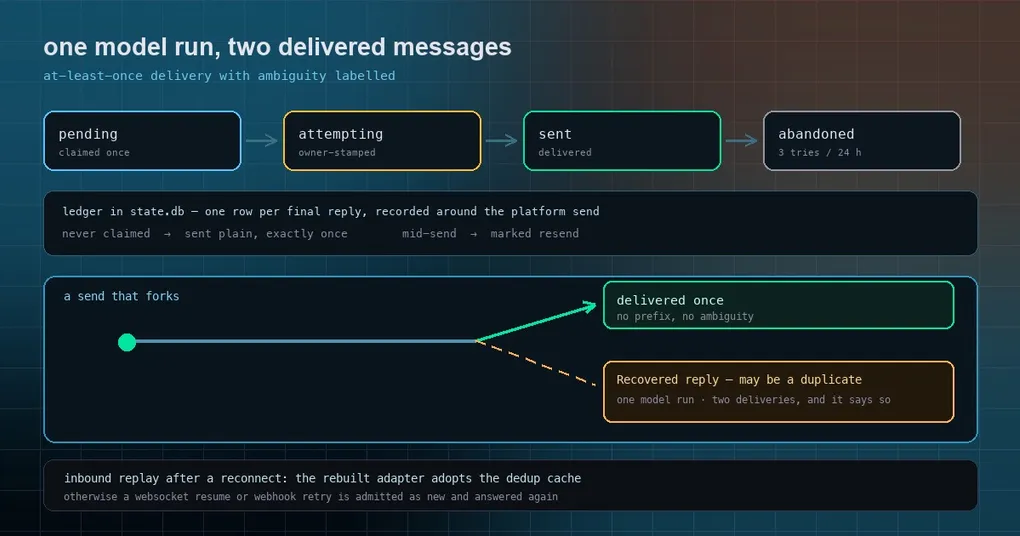
Vous posez une question à votre bot dans un groupe, vous obtenez une réponse, puis — dix minutes plus tard, juste après avoir redémarré le gateway — la même réponse arrive à nouveau. Votre première pensée concerne l’argent : le modèle a-t-il tourné deux fois, et ai-je payé deux fois ? La seconde concerne la confiance : s’il répond deux fois maintenant, que répète-t-il d’autre ? Ces deux questions ont des réponses concrètes, et le mécanisme derrière est l’une des parties les plus soigneusement conçues du gateway. Deux bugs y ont été corrigés cette semaine (#120444 et #120450), c’est donc le bon moment pour comprendre ce que vous regardez.
Le delivery ledger, en clair
Autour de chaque envoi vers une plateforme, Hermes enregistre la réponse finale dans un delivery ledger durable qui vit dans state.db. Si le gateway crashe ou redémarre entre la production d’une réponse et la confirmation de réception par la plateforme, le prochain boot a trois options : perdre la réponse, relancer tout le tour (coûteux et potentiellement faux), ou redélivrer ce qu’il a stocké. Il redélivre.
La sémantique est délibérément honnête plutôt qu’astucieuse — at-least-once, avec l’ambiguïté étiquetée au lieu d’être devinée :
- Une réponse dont l’envoi n’a jamais commencé est redélivrée telle quelle, sans rien ajouté. Celle-là est sûre à envoyer exactement une fois.
- Une réponse qui était en cours d’envoi quand le gateway est mort — la plateforme l’a peut-être reçue, peut-être pas — est redélivrée avec un préfixe visible
♻️ Recovered reply — … may be a duplicate. - Un envoi refusé par le flood control (les rate limits de Telegram, par exemple) est retenté automatiquement une fois la pénalité enregistrée expirée, sans reconnexion ni redémarrage, et le préfixe de récupération avertit que des chunks antérieurs peuvent déjà être arrivés. Le ledger ne peut pas déduire une livraison partielle de la longueur du message, alors il le dit.
- Tout autre envoi final rejeté — un 5xx de plateforme, une erreur non classée — est retenté après un backoff croissant de 30 secondes, puis de deux minutes. La dernière tentative budgétée est laissée pour le prochain démarrage du gateway, pour qu’une panne qui dépasse le minuteur ne laisse jamais la réponse en rade. Un chat définitivement injoignable (bot bloqué, groupe supprimé) n’est pas retenté du tout.
La redélivrance est bornée : trois tentatives et 24 heures de fraîcheur, après quoi la ligne est abandonnée. Les lignes livrées sont purgées au bout de sept jours. Les retries conservent le profil de bot, le chat et le thread d’origine, et un gateway multiplexé garde les réponses de chaque profile servi dans le home d’où il a démarré.
Ce que le marqueur vous dit
Voici la conclusion pratique : un doublon étiqueté signifie que le modèle n’a pas tourné deux fois. Le gateway a reconnu qu’un envoi était déjà en vol et a choisi de renvoyer la réponse stockée plutôt que de relancer le tour. La réponse que vous voyez deux fois est un seul run de modèle, livré deux fois, avec un préfixe qui l’admet.
Donc quand vous recevez une double réponse, cherchez le préfixe ♻️ Recovered reply avant d’accuser la facture de votre provider. S’il est là, la comptabilité honnête est un message dupliqué, pas une dépense dupliquée. S’il n’est pas là et que les deux réponses sont séparées par un redémarrage, vous tombiez sur le bug décrit ci-dessous.
Bug un : un crash en pleine redélivrance envoyait une seconde copie non marquée
Le ledger marque les lignes au moment où il les réclame. Un gateway tué pendant que son balayage de boot redélivrait une réponse stockée laissait autrefois une ligne que le boot suivant pouvait réclamer à nouveau et envoyer sans le préfixe de récupération — le pire des cas, parce que le doublon n’était pas étiqueté et donc impossible à distinguer d’un vrai second run.
Le correctif déplace chaque ligne réclamée vers attempting à l’intérieur du même compare-and-swap d’owner-stamp qui la réclame. Auparavant, seules les lignes de flood recevaient ce traitement. La décision needs_marker lit toujours l’état pré-claim de la ligne, donc une ligne qui n’a jamais été réclamée part toujours nue et exactement une fois — le comportement promis par la première puce ci-dessus est préservé, pas échangé. Une ligne pending résiduelle avec des attempts supérieurs à zéro, qu’un build plus ancien avait déjà réclamée et peut-être envoyée, est désormais marquée elle aussi.
Il y avait une race sœur dans le même mécanisme : une ligne failed réclamée au boot restait failed et possédée par le processus vivant pendant que son envoi de boot était en vol. Le balayage de reconnexion du runtime — qui prend les lignes failed — pouvait alors la réclamer et l’envoyer une seconde fois. La ligne reste désormais attempting pendant tout l’envoi, le claim de boot est donc exclusif.
Bug deux : un adapter reconnecté oubliait ce qu’il avait déjà vu
Le second doublon n’avait rien à voir avec la livraison sortante. Quand une connexion à une plateforme de messagerie tombe, le watcher de reconnexion du gateway remplace l’adapter défaillant par une nouvelle instance. La déduplication entrante — le MessageDeduplicator qui jette un ID de message entrant déjà vu — vivait sur l’instance de l’adapter. Un adapter tout neuf démarrait donc avec un cache vide.
Cela compte parce que les plateformes rejouent. Une reprise de websocket, un retry de webhook ou un lot de poll non acquitté peut livrer le même message entrant à nouveau juste après la reconnexion. Avec un cache vide, le gateway l’admettait comme nouveau, lançait un tour, et répondait une seconde fois.
Le correctif amorce les caches de dédup de l’adapter reconstruit à partir de l’instance qu’il remplace, en adoptant les IDs encore vivants avec leurs heures de première vue d’origine. La partie subtile, c’est « vivants » : l’entrée de cache conserve son timestamp d’origine plutôt que d’être rafraîchie, pour que la fenêtre de dédup ne s’étende pas silencieusement juste parce que l’adapter a été reconstruit. C’est un correctif petit et complet pour toute une famille de rapports « pourquoi a-t-il répondu deux fois ».
Que faire de tout ça
- Lisez d’abord le marqueur. Un préfixe
♻️ Recovered replysignifie un run de modèle et deux livraisons. Côté budget, tout va bien ; la réponse est dupliquée, pas la dépense. - Les doublons non marqués après un redémarrage ou une reconnexion sont ce que ces deux correctifs adressent. Tirer
main— ou attendre la prochaine release taguée, puisque les deux sont arrivés après v0.21.4 — est le remède. - Si vous préférez perdre une réponse plutôt que d’en dupliquer une,
gateway.delivery_ledger: falsedésactive le ledger et restaure l’ancien comportement : les réponses en vol sont perdues en cas de crash. C’est un vrai compromis, pas un interrupteur gratuit — pour un bot où un doublon est inacceptable et une réponse perdue acceptable, c’est le bon choix ; pour un bot de support, probablement pas. - Rien d’autre à configurer. Il n’y a pas de fenêtre de dédup à régler ni de nombre de retries à définir ; les bornes ci-dessus sont le design.
La vue d’ensemble sur la façon dont les réponses atteignent une plateforme se trouve dans notre guide de la cadence de livraison des messages (batching et comportement de backlog), avec la livraison des pièces jointes média pour les fichiers et les images, et le batching des notifications d’arrière-plan pour la façon dont le travail planifié rend compte. Si vous faites tourner un gateway qui redémarre de façon inattendue, le guide du loop watchdog explique le chemin de récupération que traverse un gateway qui redémarre.