Tu bot respondió dos veces: ¿se ejecutó el modelo dos veces?
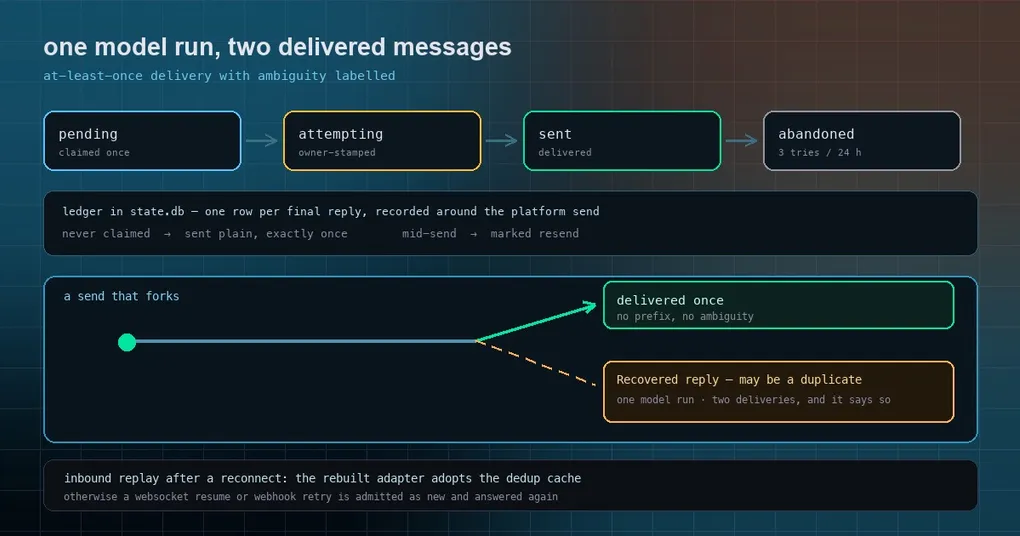
Preguntas algo a tu bot en un chat de grupo, recibes una respuesta y luego —diez minutos más tarde, justo después de reiniciar el gateway— la misma respuesta vuelve a llegar. Tu primer pensamiento es sobre dinero: ¿se ejecutó el modelo dos veces y pagué dos veces? El segundo es sobre confianza: si responde dos veces ahora, ¿qué más estará repitiendo?
Las dos preguntas tienen respuesta concreta, y el mecanismo que hay detrás es una de las partes mejor diseñadas del gateway. Esta semana se arreglaron dos bugs en él (#120444 y #120450), así que es un buen momento para entender qué estás viendo.
El delivery ledger, en palabras llanas
Alrededor de cada envío a una plataforma, Hermes registra la respuesta final en un delivery ledger durable que vive en state.db. Si el gateway se cae o se reinicia entre producir una respuesta y la confirmación de recepción de la plataforma, el siguiente arranque tiene tres opciones: perder la respuesta, volver a ejecutar el turno entero (caro y posiblemente equivocado) o reenviar lo que guardó. Reenvía.
La semántica es deliberadamente honesta antes que ingeniosa: at-least-once, con la ambigüedad etiquetada en lugar de adivinada:
- Una respuesta cuyo envío nunca empezó se reenvía tal cual, sin añadir nada. Esa es segura de enviar exactamente una vez.
- Una respuesta que estaba a mitad de envío cuando murió el gateway —puede que la plataforma la recibiera o puede que no— se reenvía con un prefijo visible
♻️ Recovered reply — … may be a duplicate. - Un envío rechazado por flood control (los rate limits de Telegram, por ejemplo) se reintenta automáticamente cuando expira la penalización registrada, sin necesidad de reconectar ni reiniciar, y el prefijo de recuperación avisa de que los fragmentos anteriores pueden haber llegado ya. El ledger no puede inferir una entrega parcial a partir de la longitud del mensaje, así que lo dice.
- Cualquier otro envío final rechazado —un 5xx de la plataforma, un error sin clasificar— se reintenta tras un backoff creciente de 30 segundos y luego dos minutos. El último intento presupuestado se reserva para el siguiente arranque del gateway, de modo que una caída que dure más que el temporizador nunca deja la respuesta varada. Un chat permanentemente inalcanzable (bot bloqueado, grupo borrado) no se reintenta en absoluto.
El reenvío está acotado: tres intentos y 24 horas de frescura, tras lo cual la fila se abandona. Las filas entregadas se podan a los siete días. Los retries conservan el profile del bot original, el chat y el thread, y un gateway multiplexado mantiene las respuestas de cada profile servido en la casa desde la que se arrancó.
Qué te dice el marcador
Esta es la conclusión práctica: un duplicado etiquetado significa que el modelo no se ejecutó dos veces. El gateway reconoció que ya había un envío en vuelo y optó por reenviar la respuesta guardada en lugar de repetir el turno. La respuesta que estás viendo dos veces es una sola ejecución del modelo, entregada dos veces, con un prefijo que lo admite.
Así que cuando te llegue una respuesta doble, busca el prefijo ♻️ Recovered reply antes de culpar a la factura de tu proveedor. Si está ahí, la contabilidad honesta es un mensaje duplicado, no un gasto duplicado. Si no está y las dos respuestas están separadas por un reinicio, estabas dando con el bug de abajo.
Bug uno: una caída a mitad de reenvío enviaba una segunda copia sin marca
El ledger marca las filas a medida que las reclama. Un gateway matado mientras su boot sweep estaba reenviando una respuesta guardada dejaba antes una fila que el siguiente arranque podía reclamar de nuevo y enviar sin el prefijo de recuperación: el peor resultado, porque el duplicado quedaba sin etiqueta y por tanto era indistinguible de una segunda ejecución real.
El arreglo mueve cada fila reclamada a attempting dentro del mismo compare-and-swap que la reclama con el owner-stamp. Antes solo las filas de flood recibían ese trato. La decisión de needs_marker sigue leyendo el estado previo a la reclamación de la fila, así que una fila que nunca fue reclamada sigue saliendo limpia y exactamente una vez: el comportamiento que promete el primer punto de arriba se conserva, no se sacrifica. Una fila pending sobrante con attempts mayor que cero, que una build más antigua ya había reclamado y quizá enviado, ahora también se marca.
Había una carrera hermana en el mismo mecanismo: una fila failed reclamada en el arranque se quedaba como failed y en propiedad del proceso vivo mientras su envío de arranque estaba en vuelo. El sweep de reconexión en runtime —que toma filas failed— podía entonces reclamarla y enviarla una segunda vez. Ahora la fila permanece en attempting durante todo el envío, así que la reclamación del arranque es exclusiva.
Bug dos: un adapter reconectado olvidaba lo que ya había visto
El segundo duplicado no tenía nada que ver con la entrega saliente. Cuando se cae la conexión con una plataforma de mensajería, el watcher de reconexión del gateway sustituye el adapter fallido por una instancia nueva. La deduplicación de entrada —el MessageDeduplicator que descarta un id de mensaje entrante que ya ha visto— vivía en la instancia del adapter. Un adapter recién creado arrancaba por tanto con la caché vacía.
Eso importa porque las plataformas reenvían. Un resume de websocket, un retry de webhook o un lote de polling sin reconocer pueden entregar el mismo mensaje entrante justo después de la reconexión. Con la caché vacía, el gateway lo admitía como nuevo, ejecutaba un turno y respondía por segunda vez.
El arreglo siembra las cachés de dedup del adapter reconstruido desde la instancia a la que sustituye, adoptando los IDs todavía vivos con sus horas de primera vista originales. La parte sutil es “vivos”: la entrada de caché conserva su timestamp original en lugar de refrescarse, así que la ventana de dedup no se alarga en silencio solo porque el adapter se haya reconstruido. Es un arreglo pequeño y completo para toda una familia de informes de “por qué respondió dos veces”.
Qué hacer al respecto
- Lee primero el marcador. Un prefijo
♻️ Recovered replysignifica una ejecución del modelo y dos entregas. En cuanto a presupuesto estás bien; lo duplicado es la respuesta, no el gasto. - Los duplicados sin marca después de un reinicio o una reconexión son justo lo que atacan estos dos arreglos. Hacer pull de
main—o esperar a la próxima release etiquetada, ya que ambos aterrizaron después de la v0.21.4— es el remedio. - Si prefieres perder una respuesta antes que duplicarla jamás,
gateway.delivery_ledger: falsedesactiva el ledger y restaura el comportamiento anterior: las respuestas en vuelo se pierden ante una caída. Es un intercambio real, no un interruptor gratis; para un bot donde un duplicado es inaceptable y una respuesta perdida es aceptable, es la elección correcta; para un bot de soporte, probablemente no. - No hay nada más que configurar. No hay ventana de dedup que ajustar ni número de retries que fijar; los límites de arriba son el diseño.
La foto más amplia de cómo llegan las respuestas a una plataforma está en nuestra guía de cadencia de entrega de mensajes (batching y comportamiento del backlog), con la entrega de adjuntos multimedia para archivos e imágenes y el batching de notificaciones en segundo plano para cómo reporta el trabajo programado. Si ejecutas un gateway que se reinicia de forma inesperada, la guía del loop watchdog explica el camino de recuperación por el que pasa un gateway que se reinicia.