机器人回复了两遍:模型真的跑了两次吗
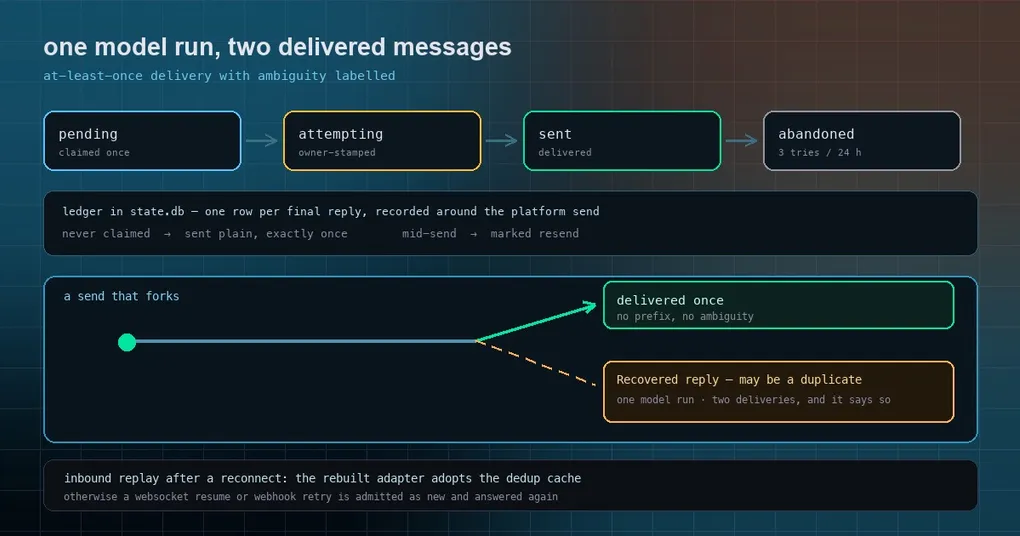
你在群里问机器人一个问题,拿到回答;十分钟后,就在你重启完网关的那一刻,同一个回答又来了。你的第一个念头跟钱有关:模型是不是跑了两遍,我是不是付了两次?第二个念头跟信任有关:现在它会重复回答,那它还在重复什么?
这两个问题都有确切答案,而背后的机制是网关里设计得相当讲究的一块。本周修掉了其中两个 bug(#120444 和 #120450),正好是把这件事讲明白的时候。
用大白话说投递账本
每一次向平台发送消息,Hermes 都会把最终回复记进 state.db 里一本持久化的投递账本。如果网关在“产出回复”和“平台确认收到”之间崩溃或重启,下一次启动只有三条路:把回复丢掉、把整个回合重跑一遍(又贵又可能跑出不一样的结果)、或者把存下来的那份重发出去。Hermes 选择重发。
它的语义是刻意做诚实的,而不是做聪明的——至少一次投递,含糊的地方明着标出来,绝不猜:
- 那次发送从未开始的回复,原样重发,什么都不加。这一种可以安全地只发一次。
- 网关挂掉时正发到一半的回复(平台可能收到、也可能没收到),重发时带上可见的
♻️ Recovered reply — … may be a duplicate前缀。 - 被限流挡下来的发送(比如 Telegram 的速率限制),会在记录在案的惩罚期结束后自动重试,不需要重连或重启;恢复前缀会提醒你前面几段可能已经送达。账本无法从消息长度推断出“部分送达”,所以它就把这件事说出来。
- 其他被拒的最终发送——平台 5xx、没归类的错误——按 30 秒、再到 2 分钟的递增退避重试。预算里的最后一次尝试会留给下一次网关启动,所以比计时器更久的故障也不会把回复搁死。而永久不可达的会话(机器人被拉黑、群被删)根本不会重试。
重发是有边界的:最多 3 次、24 小时内的新鲜度,之后就放弃该记录。已投递的记录 7 天后清理。重试会保留原来的机器人 profile、会话和话题;多路复用的网关会把每个被服务 profile 的回复都记在它启动时所用的那个 home 里。
那个标记告诉了你什么
这是最实用的结论:带标记的重复,意味着模型没有跑第二遍。 网关发现有一份发送已经在途中,于是选择重发存下来的回复,而不是重跑那个回合。你看到两次的那条回复,是一次模型运行、两次投递,而且前缀自己承认了这一点。
所以下次收到重复回答,先找 ♻️ Recovered reply 前缀,再去怀疑账单。前缀在,账要这么算:重复的是消息,不是花销。前缀不在、而两次回答之间隔了一次重启——那你撞上的就是下面这个 bug。
Bug 一:重发途中崩溃,会补发第二份没有标记的副本
账本在抢占记录的时候会给它打标记。而一个在启动清扫正在重发存下来的回复时被杀掉的网关,会留下一条记录,让下一次启动可以再次抢占并不带恢复前缀地发出去——这是最糟的结果,因为这份重复没有标记,和真正的第二次运行完全分不出来。
修复的做法是:在同一次基于属主戳的 compare-and-swap 里,把所有被抢占的记录都置为 attempting,而不只是限流那类记录。needs_marker 依然读取记录被抢占前的状态,所以一条从未被抢占过的记录仍然原样、且只发一次——上面第一条承诺的行为被保住了,而不是被换掉。一条 attempts 大于零、被旧版本已经抢占过、甚至可能已经发出去的遗留 pending 记录,现在也会被打上标记。
同一个机制里还有一处相邻的竞态:启动时被抢占的一条 failed 记录,在它的启动发送还在途中时,仍然是 failed 且仍属于这个活着的进程。运行期重连清扫会取走 failed 记录,于是可能抢走它、再发一遍。现在这条记录在整个发送期间都保持在 attempting,启动时的抢占因此是独占的。
Bug 二:重连后的适配器忘了自己见过什么
第二种重复跟出站投递毫无关系。当消息平台的连接断开,网关的重连监视器会用一个全新的实例替换掉失败的适配器。而入站去重——那个丢掉“已经见过的入站消息 ID”的 MessageDeduplicator——是存在适配器实例上的。于是新适配器一启动,缓存是空的。
这件事要紧,是因为平台会重放。WebSocket 续连、webhook 重试、一批没被确认的轮询结果,都可能在重连刚结束就把同一条入站消息再投一次。缓存空着,网关就会当成新消息收下,跑一个回合,再回答一遍。
修复是把被替换实例里还活着的去重记录播种进重建后的适配器缓存,并且保留它们原本的“首次见到”时间。微妙之处就在“还活着”:缓存条目保留原时间戳,而不是被刷新,所以去重窗口不会因为适配器被重建就被悄悄延长。一个很小、但很完整的修复,覆盖了一整类“它为什么回答了两遍”的报告。
你该怎么做
- 先看标记。
♻️ Recovered reply前缀意味着一次模型运行、两次投递。预算上你没事,重复的是回复,不是花销。 - 重启或重连之后出现的不带标记的重复,正是这两个修复针对的情况。拉取
main(或等下一个正式版本——两处改动都在 v0.21.4 之后)就是解法。 - 如果你宁愿丢回复也绝不接受重复,把
gateway.delivery_ledger设为false可以关掉账本,恢复旧行为:在途回复在崩溃时丢失。这是一笔真实的取舍,不是免费的开关——对“重复不可接受、丢一条能忍”的机器人是对的,对客服机器人大概就不是。 - 其他都不用配。 没有去重窗口要调,也没有重试次数要设;上面的边界就是设计本身。
回复怎么抵达平台,更完整的画面在消息投递节奏指南(批量与积压行为)里;文件和图片看媒体附件投递,定时任务怎么回报结果看后台通知批量投递。如果你的网关会意外重启,循环看门狗指南讲了重启中的网关会走的那条恢复路径。