Deja de regalar tu cuota a las imágenes: los dos ajustes de visión que merece la pena conocer
Le pides a Hermes una pasada de UI: mira una docena de capturas, señala tres problemas de alineación y quedas satisfecho con el resultado. Después llega la factura y aparece algo contraintuitivo: esas doce imágenes se facturaron una y otra vez durante el resto de la sesión, y parte del coste se fue en reescribir 120.000 tokens de historial de conversación solo para soltar una imagen. Las imágenes son una de las cosas más naturales que darle a un agente y una de las partes menos intuitivas de su contexto y su coste. Dos PR fusionados el 17 de septiembre arreglaron la pieza más cara y te dejaron dos ajustes que girar.
Una imagen no es un vistazo puntual: viaja durante toda la sesión
Hermes trata las imágenes de dos maneras, con curvas de coste totalmente distintas:
- Incrustación nativa. Cuando tu modelo principal tiene visión y su provider admite imágenes dentro de los resultados de herramientas (ahora mismo, las pilas de Anthropic, OpenAI, Azure-OpenAI y Gemini 3.x),
vision_analyzemete los píxeles en crudo en el resultado de una herramienta. El modelo principal ve la imagen en su siguiente turno: sin descriptor, sin pérdida de información, sin latencia extra. La pega: ese resultado de herramienta se reenvía en cada llamada posterior a la API. - Descriptor auxiliar. Con un modelo principal solo de texto (o un provider cuyo canal de resultados de herramientas no puede llevar imágenes), la petición va al modelo de visión configurado en
auxiliary.visiony se inyecta una descripción textual en la conversación. Sin píxeles en el contexto, pero con pérdida de detalle.
Así que lo que cuesta de verdad «que le eche un vistazo a esta imagen» depende de en qué ruta estés, y la mayoría de la gente no tiene ni idea de cuál, hasta que se lo dicen la factura o la ventana de contexto.
El incidente: 120.000 tokens reescritos para retirar una imagen
Como las incrustaciones nativas viajan con la sesión, necesitan un mecanismo de retirada, o unas cuantas docenas de capturas llenarían la ventana. Hermes tenía dos desalojos en la ruta de envío (evict_stale_outbound_tool_images en agent/context_compressor.py y _evict_old_screenshots en agent/anthropic_message_convert.py) con una regla simple: conservar siempre las 3 imágenes más recientes.
La regla en sí era razonable. El problema era dónde se topaba con la caché del prompt. Anthropic hace coincidir su caché por un prefijo de bytes exacto. Cada imagen nueva retiraba una antigua, y retirar significaba reescribir el mensaje que la llevaba, un mensaje que ya estaba dentro del prefijo cacheado. Reescribe el prefijo y el provider tendrá que reprocesar la conversación desde ese mensaje en adelante en lugar de leer caché.
Un usuario lo reportó con un script de reproducción (#113517), y los números son difíciles de discutir:
| Métrica | Medido |
|---|---|
| Porcentaje de los tokens de escritura de caché de la sesión gastados en estos colapsos de prefijo | 62% |
| Tokens reescritos que podrían haber sido lecturas de caché | 707.180 |
| Peor petición individual (retirar una imagen) | 127.720 tokens de historial reescritos |
| Lo que esa imagen valía en realidad | 255 – 721 tokens |
Expresado sin rodeos: para ahorrar unos cientos de tokens de imagen, la sesión recalculó cien mil tokens de historial. Las escrituras de caché se facturan —y consumen rate limit— muy por encima de las lecturas de caché, así que esto supuso aproximadamente entre un cuarto y un tercio de la cuota de toda la sesión. Y ese porcentaje escala de forma lineal con el número de imágenes: cuanto más miras, más pierdes.
La lección que merece la pena quedarse no es la cifra concreta, sino la regla general: cualquier operación que reescribe una parte del historial ya cacheada cuesta muchísimo más de lo que intentaba ahorrar.
El arreglo: retirar por lotes, solo al llegar al límite del provider y decidido en un único sitio
El PR #113953, fusionado el 17 de septiembre, sustituyó la política de retirada:
- Disparar con el límite del provider (20 bloques de imagen / 24 MB) en lugar de una vez por cada imagen nueva.
- Retirar todo un lote de las imágenes de herramienta más antiguas —8 de golpe— y contar bloques, no mensajes (un resultado de herramienta puede llevar varias imágenes, algo que la contabilidad antigua hacía mal).
- «Conservar las 3 más recientes» pasa a ser un suelo de satisfacibilidad, ya no una ventana que se mueve con cada turno; es la red de seguridad que mantiene la petición dentro del techo del provider.
- Las subidas del usuario quedan reservadas frente a los dos techos, pero nunca se reescriben: tus propias imágenes adjuntas no las toca la limpieza del agente.
- Un único módulo de política se encarga ahora de todo:
agent/image_eviction_policy.pycontiene las constantes y el cálculo del número de retiradas para las dos pasadas. Antes, las constantes de límite, lote y suelo y el bucle de retirada estaban duplicados con nombres distintos en dos módulos, así que reajustar uno solo hacía que la pasada de envío volviera a desalojar en un segundo frente.
El antes y el después es contundente: en la ruta antigua un solo colapso podía reescribir seis cifras de tokens; después, la retirada solo ocurre al alcanzar el límite, el frente se mantiene quieto dentro de un lote y el prefijo cacheado sobrevive.
Los dos ajustes que merece la pena conocer
El mismo trabajo introdujo una nueva sección de configuración de primer nivel; ojo, es algo distinto de auxiliary.vision, que elige el modelo descriptor:
vision:
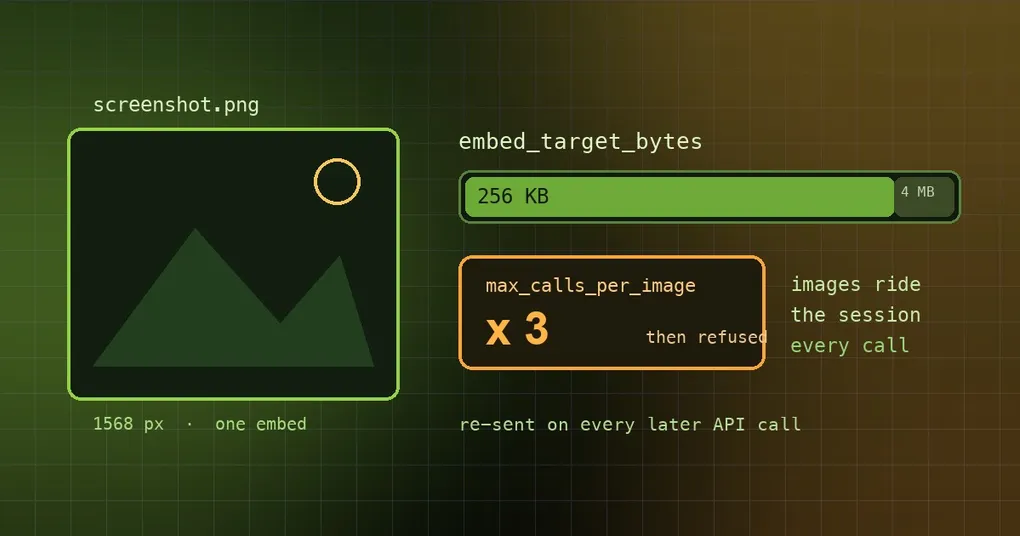
  embed_target_bytes: 262144   # presupuesto de bytes por incrustación; acotado 64 KiB .. 4 MiB (por defecto 256 KB)
  max_calls_per_image: 3       # sin definir: solo los subagentes de delegate_task se limitan a 3; el agente principal, sin límite
vision.embed_target_bytes acota cuántos bytes puede ocupar una imagen incrustada. Todo lo que supere ese presupuesto —o mida más de 1568 px de ancho— se reduce a un JPEG que sí encaje. 256 KB va bien para capturas normales; las capturas densas de tablas hechas con el móvil suelen volver como «ilegibles» con ese tamaño, así que súbelo, por ejemplo a 1048576. Las capturas de navegador entregadas de forma nativa usan el mismo presupuesto.
vision.max_calls_per_image acota cuántas veces puede incrustarse la misma imagen en una sesión —recortes de región incluidos, emparejados por la ruta resuelta—. Cuando se alcanza el tope, la herramienta se niega con un mensaje claro en lugar de volver a incrustar:
vision_analyze refused: this image has already been loaded into context N time(s) — answer from what you can already see, or ask the userPor defecto solo se limitan los subagentes delegados, a 3. El motivo es que se ejecutan sin supervisión y no se les puede corregir a mitad de bucle: una vez un subagente quemó 158 llamadas de visión repartidas en cinco archivos. Define un número explícito y se aplica en todas partes; 0 significa sin límite.
Configurarlo, en un build que lo tenga:
hermes config get vision            # valores actuales
hermes config set vision.embed_target_bytes 1048576
Una advertencia honesta: la sección vision: es nueva. En la CLI publicada de esta máquina (v0.21.0), hermes config get vision responde Config key not set: vision, porque la sección llegó a la configuración por defecto de main el 17 de septiembre. Hasta que actualices más allá de eso, escribir esas dos líneas en config.yaml no dará error: el build antiguo simplemente las ignora.
Averiguar si estás pagando por nada
- Primero, conoce tu ruta. Un modelo principal con visión más un provider que lleva imágenes en los resultados de herramientas significa incrustación nativa (imágenes reenviadas una y otra vez). En caso contrario estás en la ruta del descriptor, donde solo se reenvía texto: mucho más barata.
- Piensa antes de mirar. Una captura completa y sus recortes comparten una misma clave de contador, así que «imagen completa una vez, y luego tres recortes» cuenta como cuatro incrustaciones. Si necesitas detalle, recorta la región directamente en lugar de verlo todo primero.
- Cuando los subagentes hacen trabajo intensivo de visión, ese tope por defecto de 3 es tu barandilla; no te apresures a poner
0. - Cuando el contexto aprieta, añadir menos imágenes es mejor que comprimir después: la compresión también llama a un modelo.
Para seguir leyendo: fotos HEIC de iPhone cubre otro fallo del mundo real en la misma cadena de visión; optimización de tokens de contexto y el presupuesto de snapshots del navegador aplican la misma idea de presupuesto a otros dos objetos; y si además quieres que cada llamada de fondo salga más barata, configurar el esfuerzo de razonamiento es la otra mitad de la respuesta.
Resumen
- Las imágenes incrustadas de forma nativa se reenvían una y otra vez durante el resto de la sesión; la antigua política de «conservar las 3 más recientes» reescribía un mensaje ya cacheado con cada imagen nueva, colapsando el prefijo: medido en un 62% de los tokens de escritura de caché de esa sesión.
- El PR #113953 retira por lotes de 8, solo al alcanzar el límite del provider (20 bloques / 24 MB), con la política centralizada en
agent/image_eviction_policy.py. - El PR #113817 añade dos ajustes:
vision.embed_target_bytes(por defecto 256 KB, acotado 64 KiB–4 MiB) yvision.max_calls_per_image(por defecto: solo los subagentes limitados a 3;0= sin límite). - Ambos se fusionaron en
mainel 17 de septiembre de 2026 y todavía no están en ninguna release etiquetada (la última es la v0.21.3).