Pare de deixar as imagens comerem a sua cota: os dois ajustes de visão que valem conhecer
Você pede ao Hermes uma revisão de UI: ele olha uma dúzia de screenshots, aponta três problemas de alinhamento e você fica satisfeito com o resultado. Depois chega a fatura e aparece algo contraintuitivo — aquelas doze imagens foram cobradas repetidamente pelo resto da sessão, e parte do custo foi reescrever 120.000 tokens de histórico da conversa só para descartar uma única imagem. Imagens são uma das coisas mais naturais de se entregar a um agente e uma das partes menos intuitivas do seu contexto e do seu custo. Dois PRs mesclados em 17 de setembro corrigiram a parte mais cara disso e deixaram dois ajustes para você girar.
Uma imagem não é um olhar único — ela acompanha a sessão inteira
O Hermes lida com imagens de duas formas, com curvas de custo completamente diferentes:
- Embedding nativo. Quando o seu modelo principal tem capacidade de visão e o provider dele aceita imagens dentro de resultados de ferramenta (atualmente as pilhas Anthropic, OpenAI, Azure-OpenAI e Gemini 3.x), o
vision_analyzecoloca os pixels crus em um resultado de ferramenta. O modelo principal vê a imagem no turno seguinte — sem descritor, sem perda de informação, sem latência extra. A pegadinha: esse resultado de ferramenta é reenviado a cada chamada de API posterior. - Descritor auxiliar. Para um modelo principal só-texto (ou um provider cujo canal de resultados de ferramenta não carrega imagens), a requisição vai para o modelo de visão configurado em
auxiliary.vision, e uma descrição em texto é injetada na conversa. Nenhum pixel no contexto, mas há perda de detalhe.
Então o que “deixa ele dar uma olhada nesta imagem” de fato custa depende do caminho em que você está — e a maioria das pessoas não tem ideia de qual é, até a fatura ou a janela de contexto avisar.
O incidente: 120.000 tokens reescritos para aposentar uma imagem
Como os embeds nativos acompanham a sessão, eles precisam de um mecanismo de aposentadoria, senão algumas dezenas de screenshots encheriam a janela. O Hermes tinha dois despejos no caminho de envio (evict_stale_outbound_tool_images em agent/context_compressor.py e _evict_old_screenshots em agent/anthropic_message_convert.py) com uma regra simples: manter sempre as 3 imagens mais novas.
A regra em si era razoável. O problema era onde ela encontrava o cache de prompt. A Anthropic casa o cache dela por um prefixo exato de bytes. Cada imagem nova aposentava uma antiga, e aposentar significava reescrever a mensagem que a carregava — uma mensagem que já estava dentro do prefixo em cache. Reescreva o prefixo e o provider terá de reprocessar a conversa a partir daquela mensagem em diante, em vez de ler o cache.
Um usuário relatou isso com um script de replay (#113517), e os números são difíceis de contestar:
| Métrica | Medido |
|---|---|
| Parcela dos tokens de escrita de cache da sessão gasta nesses colapsos de prefixo | 62% |
| Tokens reescritos que poderiam ter sido leituras de cache | 707.180 |
| Pior requisição única (aposentando uma imagem) | 127.720 tokens de histórico reescritos |
| Quanto aquela imagem de fato valia | 255 – 721 tokens |
Em termos simples: para economizar algumas centenas de tokens de imagem, a sessão recalculou cem mil tokens de histórico. Escritas de cache são cobradas — e limitadas por taxa — bem acima das leituras de cache, então isso respondeu por cerca de um quarto a um terço de toda a cota da sessão. E a parcela escala linearmente com o número de imagens: quanto mais você olha, mais você perde.
A lição que vale guardar não é o número específico, mas a regra geral: qualquer operação que reescreve uma parte já em cache do histórico custa muito mais do que aquilo que ela tentava economizar.
A correção: aposentar em lotes, só no limite do provider, decidido em um único lugar
O PR #113953, mesclado em 17 de setembro, substituiu a política de aposentadoria:
- Disparar no limite do provider (20 blocos de imagem / 24 MB) em vez de uma vez a cada imagem nova.
- Aposentar um lote inteiro das imagens de ferramenta mais antigas — 8 por vez — e contar blocos, não mensagens (um resultado de ferramenta pode carregar várias imagens, e a contabilidade antiga errava isso).
- “Manter as 3 mais novas” vira um piso de satisfatibilidade, não mais uma janela que se move a cada turno; é a rede de segurança que mantém a requisição dentro do teto do provider.
- Uploads do usuário são reservados em relação aos dois tetos, mas nunca reescritos — as suas próprias imagens anexadas não são tocadas pela limpeza do agente.
- Um único módulo de política agora cuida disso:
agent/image_eviction_policy.pyguarda as constantes e o cálculo de quantas imagens aposentar para as duas passadas. Antes, as constantes de limite, lote e piso e o laço de aposentadoria estavam duplicados com nomes diferentes em dois módulos, então reajustar apenas um faria a passada de envio despejar de novo em uma segunda fronteira.
O antes e depois é gritante: no caminho antigo, um único colapso podia reescrever seis dígitos de tokens; depois, a aposentadoria acontece só no limite, a fronteira fica parada dentro de um lote e o prefixo em cache sobrevive.
Os dois ajustes que valem conhecer
O mesmo trabalho introduziu uma nova seção de configuração de primeiro nível — note que é uma coisa diferente de auxiliary.vision, que escolhe o modelo descritor:
vision:
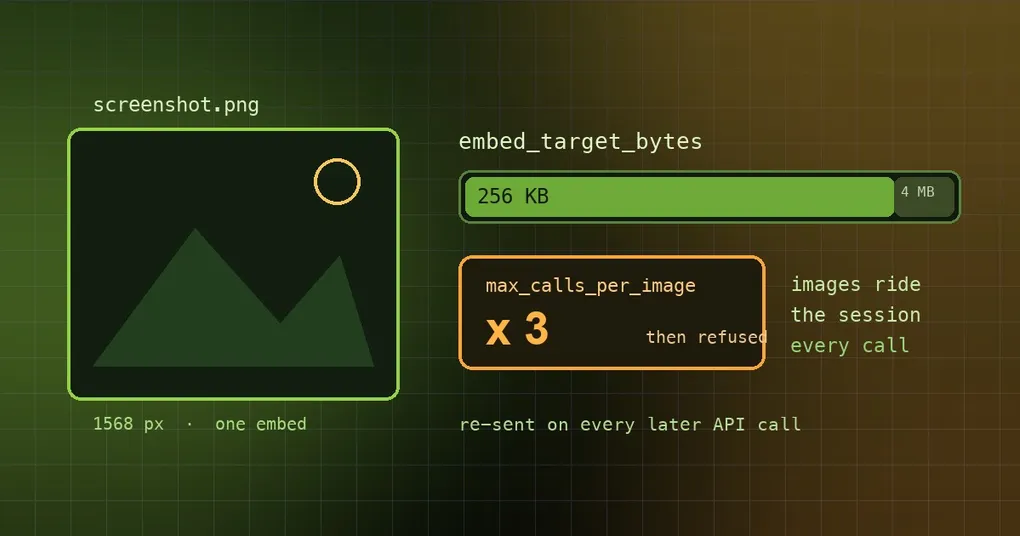
  embed_target_bytes: 262144   # orçamento de bytes por embed; limitado a 64 KiB .. 4 MiB (padrão 256 KB)
  max_calls_per_image: 3       # sem valor definido: só subagentes de delegate_task são limitados a 3, o agente principal é ilimitado
vision.embed_target_bytes limita quantos bytes uma imagem embutida pode ocupar. Tudo o que passa do orçamento — ou que seja mais largo que 1568 px — é reduzido para um JPEG que caiba. 256 KB é suficiente para screenshots comuns; screenshots densos de tabelas em celular muitas vezes voltam “ilegíveis” nesse tamanho, então aumente, por exemplo para 1048576. Screenshots de navegador entregues nativamente usam o mesmo orçamento.
vision.max_calls_per_image limita com que frequência a mesma imagem pode ser embutida em uma sessão — recortes de região incluídos, casados pelo caminho resolvido. Quando o limite é atingido, a ferramenta recusa com uma mensagem clara em vez de embutir de novo:
vision_analyze refused: this image has already been loaded into context N time(s) — answer from what you can already see, or ask the userPor padrão, apenas subagentes delegados recebem limite, de 3. O motivo é que eles rodam sem supervisão e não podem ser direcionados no meio do laço — um subagente uma vez queimou 158 chamadas de visão em cinco arquivos. Defina um número explícito e ele vale em todo lugar; 0 significa ilimitado.
Como configurar, em uma build que já tem isso:
hermes config get vision            # valores atuais
hermes config set vision.embed_target_bytes 1048576
Uma ressalva honesta: a seção vision: é nova. No CLI lançado desta máquina (v0.21.0), hermes config get vision responde Config key not set: vision, porque a seção entrou na configuração padrão da main em 17 de setembro. Até você atualizar além disso, escrever essas duas linhas no config.yaml não vai dar erro — a build mais antiga simplesmente as ignora.
Como descobrir se você está pagando por nada
- Primeiro, saiba qual é o seu caminho. Modelo principal com visão mais um provider que carrega imagens em resultados de ferramenta significa embedding nativo (imagens reenviadas repetidamente). Caso contrário, você está no caminho do descritor, onde só texto é reenviado — bem mais barato.
- Pense antes de olhar. Um screenshot completo e os seus recortes compartilham a mesma chave de contador, então “imagem inteira uma vez, depois três recortes” conta como quatro embeds. Se você precisa de detalhe, recorte a região de imediato em vez de ver tudo primeiro.
- Quando subagentes fazem trabalho pesado de visão, aquele limite padrão de 3 é a sua proteção; não corra para definir
0. - Quando o contexto está apertado, adicionar menos imagens é melhor do que comprimir depois — a compressão em si chama um modelo.
Leitura adicional: fotos HEIC de iPhone cobre uma falha diferente do mundo real na mesma cadeia de visão; otimização de tokens de contexto e o orçamento de snapshot do navegador aplicam a mesma ideia de orçamento a dois outros objetos; e se você quer que toda chamada de fundo também saia mais barata, configurar o esforço de raciocínio é a outra metade da resposta.
Resumo
- Imagens embutidas nativamente são reenviadas repetidamente pelo resto da sessão; a antiga política “manter as 3 mais novas” reescrevia uma mensagem já em cache a cada imagem nova, colapsando o prefixo — medido em 62% dos tokens de escrita de cache daquela sessão.
- O PR #113953 aposenta em lotes de 8, só no limite do provider (20 blocos / 24 MB), com a política centralizada em
agent/image_eviction_policy.py. - O PR #113817 adiciona dois ajustes:
vision.embed_target_bytes(padrão 256 KB, limitado a 64 KiB–4 MiB) evision.max_calls_per_image(padrão: só subagentes limitados, a 3;0= ilimitado). - Ambos entraram na
mainem 17 de setembro de 2026 e ainda não estão em uma release marcada (a mais recente é a v0.21.3).