Cessez de laisser les images dévorer votre quota : les deux réglages de vision qui valent la peine
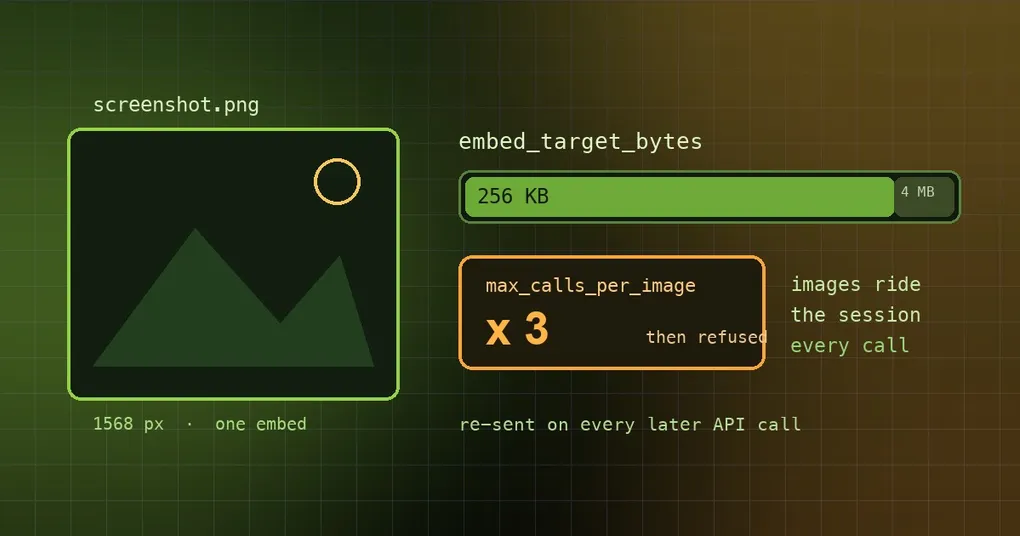
Vous demandez à Hermes une passe d’interface : il examine une douzaine de captures d’écran, signale trois problèmes d’alignement, et le résultat vous convainc. Puis la facture arrive et quelque chose de contre-intuitif apparaît — ces douze images ont été facturées encore et encore pendant le reste de la session, et une partie du coût est passée dans la réécriture de 120 000 tokens d’historique de conversation, simplement pour écarter une image. Les images sont l’une des choses les plus naturelles à confier à un agent et l’un des aspects les moins intuitifs de son contexte et de son coût. Deux PR fusionnées le 17 septembre ont corrigé le poste le plus cher et vous ont laissé deux réglages à ajuster.
Une image n’est pas un simple coup d’œil — elle accompagne toute la session
Hermes traite les images de deux manières, avec des courbes de coût totalement différentes :
- Intégration native. Quand votre modèle principal sait voir et que son provider accepte les images dans les résultats d’outils (actuellement les piles Anthropic, OpenAI, Azure-OpenAI et Gemini 3.x),
vision_analyzeplace les pixels bruts dans un résultat d’outil. Le modèle principal voit l’image à son tour suivant — pas de descripteur, aucune perte d’information, aucune latence supplémentaire. Le piège : ce résultat d’outil est renvoyé à chaque appel API ultérieur. - Descripteur auxiliaire. Pour un modèle principal dépourvu de vision (ou un provider dont le canal de résultats d’outils ne peut pas transporter d’images), la requête part vers le modèle de vision configuré sous
auxiliary.vision, et une description textuelle est injectée dans la conversation. Aucun pixel dans le contexte, mais du détail est perdu.
Ce que coûte réellement un « jette un œil à cette image » dépend donc du chemin sur lequel vous êtes — et la plupart des gens l’ignorent jusqu’à ce que la facture ou la fenêtre de contexte le leur apprenne.
L’incident : 120 000 tokens réécrits pour retirer une seule image
Comme les intégrations natives accompagnent la session, elles ont besoin d’un mécanisme de retrait, sans quoi quelques dizaines de captures d’écran rempliraient la fenêtre. Hermes avait deux évictions sur le chemin d’envoi (evict_stale_outbound_tool_images dans agent/context_compressor.py et _evict_old_screenshots dans agent/anthropic_message_convert.py) avec une règle simple : garder toujours les 3 images les plus récentes.
La règle elle-même était raisonnable. Le problème, c’est là où elle rencontrait le cache de prompt. Anthropic apparie son cache sur un préfixe d’octets exact. Chaque nouvelle image en retirait une ancienne, et retirer signifiait réécrire le message qui la portait — un message déjà situé à l’intérieur du préfixe mis en cache. Réécrivez le préfixe et le provider doit retraiter la conversation à partir de ce message, au lieu de lire le cache.
Un utilisateur l’a signalé avec un script de rejeu (#113517), et les chiffres sont difficiles à contester :
| Métrique | Mesuré |
|---|---|
| Part des tokens d’écriture de cache de la session dépensée sur ces effondrements de préfixe | 62 % |
| Tokens réécrits qui auraient pu être des lectures de cache | 707 180 |
| Pire requête isolée (retrait d’une image) | 127 720 tokens d’historique réécrits |
| Ce que cette image valait réellement | 255 – 721 tokens |
En clair : pour économiser quelques centaines de tokens d’image, la session recalculait cent mille tokens d’historique. Les écritures de cache sont facturées — et limitées en débit — bien au-dessus des lectures de cache, ce qui représentait environ un quart à un tiers du quota total de la session. Et cette part augmente linéairement avec le nombre d’images : plus vous en regardez, plus vous perdez.
La leçon à retenir n’est pas le chiffre précis, mais la règle générale : toute opération qui réécrit une partie déjà mise en cache de l’historique coûte bien plus que ce qu’elle cherchait à économiser.
Le correctif : retirer par lots, uniquement à la limite du provider, et décider en un seul endroit
La PR #113953, fusionnée le 17 septembre, a remplacé la politique de retrait :
- Déclenchement à la limite du provider (20 blocs d’images / 24 MB) au lieu d’une fois par nouvelle image.
- Retrait de tout un lot des images d’outils les plus anciennes — 8 à la fois — et comptage en blocs, pas en messages (un résultat d’outil peut porter plusieurs images, ce que l’ancienne comptabilité ratait).
- « Garder les 3 plus récentes » devient un plancher de satisfiabilité, et non plus une fenêtre qui bouge à chaque tour ; c’est le filet de sécurité qui maintient la requête sous le plafond du provider.
- Les envois de l’utilisateur sont réservés face aux deux plafonds mais jamais réécrits — vos propres images jointes ne sont pas touchées par le nettoyage de l’agent.
- Un seul module de politique en est désormais responsable :
agent/image_eviction_policy.pydétient les constantes et le calcul du nombre de retraits pour les deux passes. Auparavant, les constantes de limite, de lot et de plancher ainsi que la boucle de retrait étaient dupliquées sous des noms différents dans deux modules, si bien que réaccorder l’un seul faisait ré-évincer la passe réseau sur un second front.
Le contraste avant/après est net : sur l’ancien chemin, un seul effondrement pouvait réécrire six chiffres de tokens ; ensuite, le retrait n’a lieu qu’à la limite, le front reste stable à l’intérieur d’un lot, et le préfixe mis en cache survit.
Les deux réglages qui valent la peine
Le même travail a introduit une nouvelle section de config de premier niveau — à noter qu’elle est différente de auxiliary.vision, qui choisit le modèle descripteur :
vision:
  embed_target_bytes: 262144   # budget d'octets par intégration, borné 64 KiB .. 4 MiB (défaut 256 KB)
  max_calls_per_image: 3       # non défini : seuls les subagents delegate_task sont plafonnés à 3, l'agent principal est illimité
vision.embed_target_bytes borne le nombre d’octets qu’une image intégrée peut occuper. Tout ce qui dépasse le budget — ou mesure plus de 1568 px de large — est réduit à un JPEG qui tient. 256 KB convient aux captures d’écran ordinaires ; les captures denses de tableaux prises sur téléphone reviennent souvent « illisibles » à cette taille, augmentez-la donc, par exemple à 1048576. Les captures d’écran du navigateur livrées nativement utilisent le même budget.
vision.max_calls_per_image borne la fréquence à laquelle la même image peut être intégrée dans une session — recadrages de régions inclus, appariés par chemin résolu. Une fois le plafond atteint, l’outil refuse avec un message clair au lieu d’intégrer à nouveau :
vision_analyze refused: this image has already been loaded into context N time(s) — answer from what you can already see, or ask the userPar défaut, seuls les subagents délégués sont plafonnés, à 3. La raison : ils tournent sans surveillance et ne peuvent pas être recadrés en cours de boucle — un subagent a déjà brûlé 158 appels de vision sur cinq fichiers. Fixez un nombre explicite et il s’applique partout ; 0 signifie illimité.
Pour le configurer, sur une version qui en dispose :
hermes config get vision            # valeurs actuelles
hermes config set vision.embed_target_bytes 1048576
Une réserve honnête : la section vision: est nouvelle. Sur la CLI publiée de cette machine (v0.21.0), hermes config get vision répond Config key not set: vision, parce que la section est arrivée dans la config par défaut sur main le 17 septembre. Tant que vous n’aurez pas dépassé cette version, écrire ces deux lignes dans config.yaml ne provoquera pas d’erreur — l’ancienne version les ignore simplement.
Déterminer si vous payez pour rien
- D’abord, connaissez votre chemin. Un modèle principal capable de vision plus un provider qui transporte les images dans les résultats d’outils signifie une intégration native (images renvoyées à répétition). Sinon, vous êtes sur le chemin du descripteur, où seul le texte est renvoyé — bien moins cher.
- Réfléchissez avant de regarder. Une capture complète et ses recadrages partagent une même clé de compteur, donc « l’image entière une fois, puis trois recadrages » compte comme quatre intégrations. Si vous avez besoin de détail, recadrez directement la région au lieu de tout regarder d’abord.
- Quand des subagents font un travail gourmand en vision, ce plafond par défaut de 3 est votre garde-fou ; ne vous empressez pas de mettre
0. - Quand le contexte est serré, ajouter moins d’images vaut mieux que compresser ensuite — la compression elle-même appelle un modèle.
Pour aller plus loin : les photos HEIC d’iPhone décrit une autre défaillance bien réelle sur la même chaîne de vision ; l’optimisation des tokens de contexte et le budget des instantanés du navigateur appliquent la même idée de budget à deux autres objets ; et si vous voulez aussi que chaque appel d’arrière-plan coûte moins cher, configurer l’effort de raisonnement est l’autre moitié de la réponse.
En résumé
- Les images intégrées nativement sont renvoyées à répétition pendant le reste de la session ; l’ancienne politique « garder les 3 plus récentes » réécrivait un message déjà mis en cache à chaque nouvelle image, effondrant le préfixe — mesuré à 62 % des tokens d’écriture de cache de cette session.
- La PR #113953 retire par lots de 8, uniquement à la limite du provider (20 blocs / 24 MB), avec la politique centralisée dans
agent/image_eviction_policy.py. - La PR #113817 ajoute deux réglages :
vision.embed_target_bytes(défaut 256 KB, borné 64 KiB–4 MiB) etvision.max_calls_per_image(par défaut : seuls les subagents sont plafonnés, à 3 ;0= illimité). - Les deux ont été fusionnées dans
mainle 17 septembre 2026 et ne figurent pas encore dans une version taguée (la dernière est v0.21.3).