图片正在悄悄吃掉你的额度:两个该认识的图片配置项
你让 Hermes 帮忙做一轮界面走查:它看了十来张截图,指出了三处对齐问题,你很满意。月底打开账单,你会发现一件反直觉的事——那十来张图在整个会话里被反复计费了很久,而其中一部分开销甚至花在“为了少发一张图,把十二万 token 的对话历史重写了一遍”上。图片是 agent 用起来最自然的功能之一,也是上下文与成本里最不直观的一环。9 月 17 日合并的两个 PR 修掉了其中最贵的一处,同时给你留下了两个可以自己拧的旋钮。
图片不是“看一眼就过去”,它会跟着整个会话走
Hermes 处理图片有两条路,成本曲线完全不同:
- 原生嵌入:当你的主模型支持视觉、并且它的 provider 支持在「工具结果」里携带图片(目前是 Anthropic、OpenAI、Azure-OpenAI 和 Gemini 3.x 这几套栈),
vision_analyze会直接把图片像素塞进工具结果。主模型在下一轮就能看到图——没有描述器、没有信息损失、也没有额外延迟。代价是:这个工具结果会在之后每一次 API 调用里被重新发送。 - 辅助描述器:主模型是纯文本模型(或者 provider 的工具结果通道不带图)时,请求转给
auxiliary.vision指定的视觉模型,返回一段文字描述注入对话。像素不进上下文,但细节会损失。
所以“让它看一眼这张图”的实际成本,取决于你走的是哪条路——而绝大多数人对这件事毫无感觉,直到账单或上下文窗口提醒他。
事故复盘:为了退掉一张图,重写了 12 万 token 的历史
原生嵌入的图片既然会一直跟着会话走,就必须有“退休”机制,否则几十张截图会把上下文撑爆。Hermes 的发送路径上有两处退休逻辑(agent/context_compressor.py 的 evict_stale_outbound_tool_images 和 agent/anthropic_message_convert.py 的 _evict_old_screenshots),原来的规则很简单:始终保留最新的 3 张图。
规则本身很合理,问题出在它和 prompt 缓存相遇的地方。Anthropic 的提示缓存按精确的字节前缀匹配。每当一张新图进来,就有一张老图被退休;而“退休”意味着重写那条携带图片的消息——那条消息早就已经在缓存前缀里了。前缀一旦被改写,provider 就必须从那条消息开始重新处理整段对话,而不是读缓存。
一位用户带着复现脚本报告了这个情况(#113517),数据非常清楚:
| 指标 | 实测值 |
|---|---|
| 这类前缀崩塌占该会话缓存写 token 的比例 | 62% |
| 被重写、本可以是缓存读的 token | 707,180 |
| 最糟的单次请求(为了退掉一张图) | 重写 127,720 token 的历史 |
| 那张图本身值多少 | 255 ~ 721 token |
翻译成人话:为了省几百 token 的图,把十几万 token 的历史重算了一遍。缓存写比缓存读贵得多、也更容易触到速率限制,所以这一项大致占掉了该会话四分之一到三分之一的配额消耗。而且这个比例会随图片数量线性放大——你看的图越多,亏得越多。
这个例子值得记住的不是具体数字,而是那条通用规律:任何“重写历史中已缓存部分”的操作,代价都远超它想省下的那点东西。
修复之后:按上限整批退休,而且只在一个地方判定
9 月 17 日合并的 PR #113953 改掉了退休策略:
- 只在供应商上限处触发:达到 20 个图像块 / 24 MB 才动手,而不是每来一张新图就动一次。
- 一次退休一整批:以 8 个为单位退休最老的工具图片,且按“图像块”而不是按“消息”计数(一条工具结果可能带好几张图,这在此前是算错的)。
- “保留最新 3 张”降级为下限:它不再是一个每轮都会推移的窗口,而是保证结果在供应商上限内可发送的兜底。
- 用户自己上传的图片在两道天花板下预留额度,但不被重写——你自己贴的图不会因为别人(agent)的清理而被动过。
- 策略集中到一个模块:新增
agent/image_eviction_policy.py保存常量与退休数量计算,两条发送路径共用。此前这两个模块各自复制了一份“上限/批大小/下限”的常量,只调其中一个会让另一条路径在第二个前沿上重复退休。
修复前后的量级对比很直观:一个会话若命中旧逻辑,一次前缀崩塌就能重写十万量级的 token;改完之后,退休只在上限处发生,且前沿在一次批处理内保持不动、缓存前缀得以稳定。
两个你该认识的旋钮
同一批工作还带来一个新的顶层配置段——注意它和 auxiliary.vision(选描述器模型)是两件不同的事:
vision:
  embed_target_bytes: 262144   # 单张图片的字节预算;clamp 64 KiB .. 4 MiB(默认 256 KB)
  max_calls_per_image: 3       # 不填时:只有 delegate_task 子代理受限 3 次,主代理不限
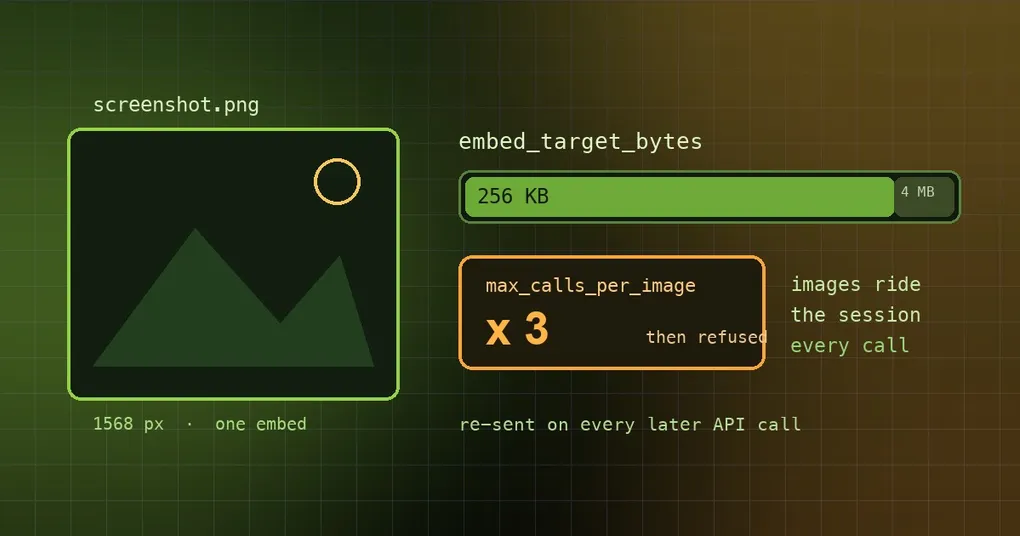
vision.embed_target_bytes 管的是“一张图塞进去时最多占多少字节”。超过预算、或者宽度超过 1568 px 的图会被压成 JPEG 缩到预算内。256 KB 对普通截图够用;手机拍的密集表格截图经常在这个尺寸下被模型判为“看不清”——那就往上调,比如 1048576。浏览器与浏览器截图走的是同一预算。
vision.max_calls_per_image 管的是“同一张图在一个会话里最多被嵌入几次”。这里的“同一张图”包含它的局部裁剪(按解析后的路径归并)。到达上限后,工具不再嵌入,而是返回一句明确的拒绝:
vision_analyze refused: this image has already been loaded into context N time(s) — answer from what you can already see, or ask the user默认只有委托出去的子代理被限制在 3 次,主代理不限。原因是子代理无人盯着、也没法在循环中途被叫停:曾有一个子代理在 5 个文件上烧掉了 158 次视觉调用。显式写一个数字则对所有会话生效,写 0 表示全部不限。
配置方式(新版本里):
hermes config get vision            # 看当前值
hermes config set vision.embed_target_bytes 1048576要诚实说一句:vision: 这个段是新的。在本机安装的发布版 CLI(v0.21.0)上执行 hermes config get vision 会直接返回 Config key not set: vision——因为该段是 9 月 17 日随 main 一起加进默认配置的。在你升级到包含它的版本之前,把这两行写进 config.yaml 不会报错,但旧版本会忽略它们。
怎么判断自己是不是在花冤枉钱
- 先看走的是哪条路:主模型支持视觉、且 provider 的工具结果能带图,就是原生嵌入(图片反复重发);否则是描述器路径(只有文字反复重发,便宜得多)。
- 看图之前想一想:整张截图和它的局部裁剪共享同一个计数键,所以“整图看一遍 + 再裁三块细看”会算四次嵌入。真需要细节时直接裁那块区域,比先看全图再裁更省。
- 子代理跑视觉密集任务时,默认的 3 次上限就是你的护栏,别急着设
0。 - 上下文紧张时,减少“同时塞很多图”比事后压缩更划算——因为压缩本身也要调用模型。
延伸阅读:iPhone HEIC 照片的处理讲的是同一条视觉链路上另一类真实问题;上下文 token 优化与浏览器快照预算则是同一套“预算”思路在两个不同对象上的应用;想让每次后台调用都更便宜,推理强度配置是另一半答案。
小结
- 原生嵌入的图片会跟着整个会话反复重发;旧的“保留最新 3 张”策略每来一张新图就重写一条已缓存消息,导致前缀缓存整体失效——实测占该会话缓存写 token 的 62%。
- PR #113953 改成“只在供应商上限(20 块 / 24 MB)触发、按 8 个一批退休、集中到
agent/image_eviction_policy.py判定”。 - PR #113817 带来两个旋钮:
vision.embed_target_bytes(默认 256 KB,clamp 64 KiB–4 MiB)和vision.max_calls_per_image(默认只在子代理里限制为 3 次,0= 不限)。 - 两者都是 2026-09-17 合并进
main,尚未进入正式发布(最新 v0.21.3)。