Lass Bilder nicht dein Kontingent auffressen: die zwei Vision-Schalter, die es zu kennen lohnt
Du bittest Hermes um einen UI-Durchgang: es sieht sich ein Dutzend Screenshots an, markiert drei Ausrichtungsprobleme, und du bist mit dem Ergebnis zufrieden. Dann kommt die Rechnung, und etwas Kontraintuitives taucht auf — diese zwölf Bilder wurden für den Rest der Session immer wieder abgerechnet, und ein Teil der Kosten floss in das Neuschreiben von 120.000 Token Gesprächsverlauf, nur um ein Bild loszuwerden. Bilder sind eine der natürlichsten Dinge, die man einem Agenten geben kann, und einer der am wenigsten intuitiven Teile seines Kontexts und seiner Kosten. Zwei am 17. September gemergte PRs haben das teuerste Stück davon behoben und dir zwei Schalter zum Drehen hinterlassen.
Ein Bild ist kein einmaliger Blick — es fährt die ganze Session mit
Hermes behandelt Bilder auf zwei Wegen, mit völlig unterschiedlichen Kostenkurven:
- Natives Einbetten. Wenn dein Hauptmodell Vision-fähig ist und sein Provider Bilder in Tool-Results unterstützt (derzeit die Stacks Anthropic, OpenAI, Azure-OpenAI und Gemini 3.x), legt
vision_analyzedie rohen Pixel in ein Tool-Result. Das Hauptmodell sieht das Bild in seinem nächsten Turn — kein Beschreiber, kein Informationsverlust, keine zusätzliche Latenz. Der Haken: dieses Tool-Result wird bei jedem späteren API-Aufruf erneut mitgeschickt. - Hilfs-Beschreiber. Bei einem reinen Text-Hauptmodell (oder einem Provider, dessen Tool-Result-Kanal keine Bilder tragen kann) geht die Anfrage an das unter
auxiliary.visionkonfigurierte Vision-Modell, und eine Textbeschreibung wird in das Gespräch eingefügt. Keine Pixel im Kontext, dafür geht Detail verloren.
Was „lass es sich dieses Bild einmal ansehen“ tatsächlich kostet, hängt also davon ab, auf welchem Pfad du bist — und die meisten wissen nicht, welcher es ist, bis die Rechnung oder das Kontextfenster es ihnen sagt.
Der Vorfall: 120.000 Token neu geschrieben, um ein einziges Bild zu entfernen
Da native Embeds die ganze Session mitfahren, brauchen sie einen Mechanismus zum Entfernen, sonst würden ein paar Dutzend Screenshots das Fenster füllen. Hermes hatte zwei Evictions auf dem Sendepfad (evict_stale_outbound_tool_images in agent/context_compressor.py und _evict_old_screenshots in agent/anthropic_message_convert.py) mit einer einfachen Regel: die drei neuesten Bilder immer behalten.
Die Regel selbst war vernünftig. Das Problem war, wo sie auf den Prompt-Cache traf. Anthropic gleicht seinen Cache über ein exaktes Byte-Präfix ab. Jedes neue Bild entfernte ein altes, und Entfernen bedeutete, die Nachricht neu zu schreiben, die es trug — eine Nachricht, die bereits im gecachten Präfix lag. Schreibe das Präfix neu, und der Provider muss das Gespräch ab dieser Nachricht erneut verarbeiten, statt Cache zu lesen.
Ein Nutzer hat es mit einem Replay-Skript gemeldet (#113517), und die Zahlen lassen wenig Raum für Argumente:
| Messgröße | Gemessen |
|---|---|
| Anteil der Cache-Write-Token der Session, der auf diese Präfix-Kollapse entfiel | 62% |
| Token, die neu geschrieben wurden und Cache-Reads hätten sein können | 707.180 |
| Schlimmster einzelner Request (ein Bild entfernen) | 127.720 Token Verlauf neu geschrieben |
| Was dieses Bild tatsächlich wert war | 255 – 721 Token |
Klartext: um ein paar hundert Token Bild zu sparen, rechnete die Session hunderttausend Token Verlauf neu. Cache-Writes werden deutlich über Cache-Reads abgerechnet — und ratenbegrenzt —, deshalb machte das etwa ein Viertel bis ein Drittel des Kontingents der ganzen Session aus. Und der Anteil skaliert linear mit der Zahl der Bilder: je mehr du anschaust, desto mehr verlierst du.
Die Lehre, die es zu behalten gilt, ist nicht die konkrete Zahl, sondern die allgemeine Regel: jede Operation, die einen bereits gecachten Teil des Verlaufs neu schreibt, kostet weit mehr als das, was sie einsparen wollte.
Der Fix: in Batches entfernen, nur an der Provider-Grenze, an einer Stelle entschieden
PR #113953, gemergt am 17. September, hat die Entfernungspolitik ersetzt:
- Auslösen an der Provider-Grenze (20 Bild-Blöcke / 24 MB) statt einmal pro neuem Bild.
- Ein ganzes Batch der ältesten Tool-Bilder entfernen — 8 auf einmal — und dabei Blöcke zählen, nicht Nachrichten (ein Tool-Result kann mehrere Bilder tragen, was die alte Rechnung falsch machte).
- „Die drei neuesten behalten“ wird zu einer Untergrenze der Erfüllbarkeit, nicht mehr zu einem Fenster, das sich in jedem Turn verschiebt; sie ist das Sicherheitsnetz, das den Request unter der Obergrenze des Providers hält.
- Nutzer-Uploads sind gegen beide Obergrenzen reserviert, werden aber nie neu geschrieben — deine selbst angehängten Bilder werden vom Aufräumen des Agenten nicht angefasst.
- Ein einziges Politik-Modul besitzt das jetzt:
agent/image_eviction_policy.pyenthält die Konstanten und die Berechnung der Entfernungszahl für beide Durchgänge. Zuvor waren die Konstanten für Grenze, Batch und Untergrenze sowie die Entfernungsschleife unter verschiedenen Namen in zwei Modulen dupliziert, sodass ein Nachjustieren nur einer Stelle den Wire-Durchgang an einer zweiten Front erneut evicten ließ.
Das Vorher/Nachher ist krass: auf dem alten Pfad konnte ein einzelner Kollaps eine sechsstellige Token-Zahl neu schreiben; danach findet Entfernung nur noch an der Grenze statt, die Front bleibt innerhalb eines Batches stehen, und das gecachte Präfix überlebt.
Die zwei Schalter, die es zu kennen lohnt
Dieselbe Arbeit hat einen neuen Top-Level-Konfigurationsabschnitt eingeführt — beachte, dass das etwas anderes ist als auxiliary.vision, das das Beschreiber-Modell auswählt:
vision:
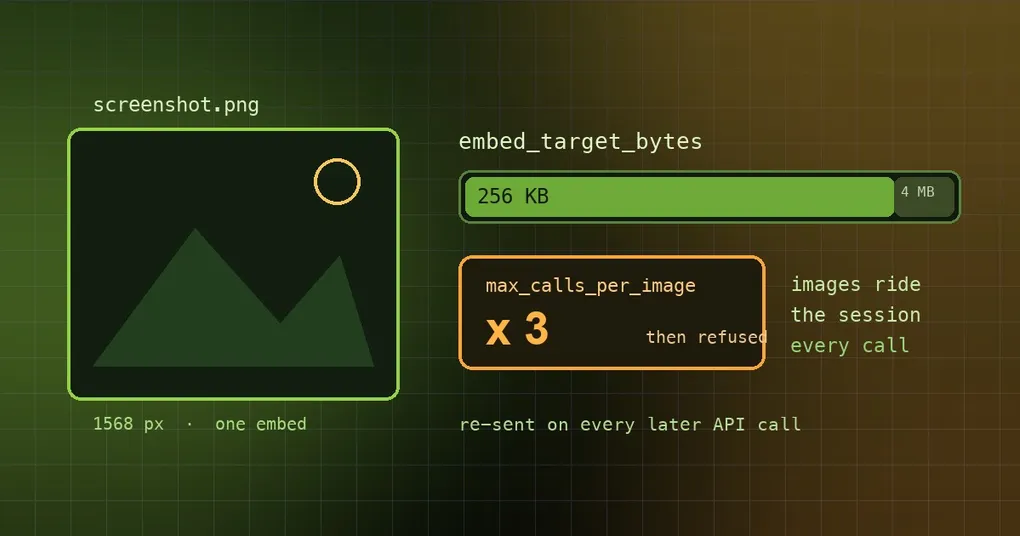
  embed_target_bytes: 262144   # Byte-Budget pro Embed; begrenzt auf 64 KiB .. 4 MiB (Standard 256 KB)
  max_calls_per_image: 3       # nicht gesetzt: nur delegate_task-Subagenten sind auf 3 begrenzt, Haupt-Agent unbegrenzt
vision.embed_target_bytes begrenzt, wie viele Bytes ein eingebettetes Bild belegen darf. Alles über dem Budget — oder breiter als 1568 px — wird auf ein passendes JPEG herunterskaliert. 256 KB sind für gewöhnliche Screenshots in Ordnung; dichte Handy-Screenshots von Tabellen kommen in dieser Größe oft „unlesbar“ zurück, also erhöhe den Wert, zum Beispiel auf 1048576. Browser-Screenshots, die nativ geliefert werden, nutzen dasselbe Budget.
vision.max_calls_per_image begrenzt, wie oft dasselbe Bild in einer Session eingebettet werden darf — Regions-Crops eingeschlossen, abgeglichen über den aufgelösten Pfad. Ist die Obergrenze erreicht, verweigert das Werkzeug mit einer klaren Meldung, statt erneut einzubetten:
vision_analyze refused: this image has already been loaded into context N time(s) — answer from what you can already see, or ask the userStandardmäßig sind nur delegierte Subagenten begrenzt, und zwar auf 3. Der Grund: sie laufen unbeaufsichtigt und lassen sich mitten in der Schleife nicht steuern — ein Subagent hat einmal 158 Vision-Aufrufe über fünf Dateien verbrannt. Setze eine explizite Zahl, und sie gilt überall; 0 bedeutet unbegrenzt.
So konfigurierst du das, auf einem Build, der es hat:
hermes config get vision            # aktuelle Werte
hermes config set vision.embed_target_bytes 1048576
Eine ehrliche Einschränkung: der Abschnitt vision: ist neu. In der veröffentlichten CLI dieser Maschine (v0.21.0) antwortet hermes config get vision mit Config key not set: vision, weil der Abschnitt am 17. September in der Standardkonfiguration auf main gelandet ist. Bis du darüber hinaus aktualisierst, führen diese zwei Zeilen in config.yaml zu keinem Fehler — der ältere Build ignoriert sie einfach.
Herausfinden, ob du für nichts bezahlst
- Kenne zuerst deinen Pfad. Vision-fähiges Hauptmodell plus ein Provider, der Bilder in Tool-Results trägt, bedeutet natives Einbetten (Bilder werden wiederholt mitgeschickt). Sonst bist du auf dem Beschreiber-Pfad, wo nur Text erneut gesendet wird — deutlich günstiger.
- Denk nach, bevor du schaust. Ein vollständiger Screenshot und seine Crops teilen sich einen Zähler-Schlüssel, deshalb zählt „ganzes Bild einmal, dann drei Crops“ als vier Embeds. Wenn du Details brauchst, schneide die Region gleich selbst zu, statt erst alles anzusehen.
- Wenn Subagenten Vision-lastige Arbeit machen, ist die Standardgrenze von 3 dein Geländer; setze sie nicht vorschnell auf
0. - Wenn der Kontext knapp ist, ist es besser, weniger Bilder hinzuzufügen, als hinterher zu komprimieren — Kompression ruft selbst ein Modell auf.
Weiterlesen: iPhone-HEIC-Fotos behandelt einen anderen Praxisfall auf derselben Vision-Kette; Kontext-Token-Optimierung und das Browser-Snapshot-Budget wenden dieselbe Budget-Idee auf zwei andere Objekte an; und wenn auch jeder Hintergrundaufruf günstiger sein soll, ist die Konfiguration des Reasoning-Aufwands die andere Hälfte der Antwort.
Zusammenfassung
- Nativ eingebettete Bilder werden für den Rest der Session wiederholt mitgeschickt; die alte Politik „die drei neuesten behalten“ schrieb bei jedem neuen Bild eine bereits gecachte Nachricht neu und ließ das Präfix kollabieren — gemessen 62% der Cache-Write-Token dieser Session.
- PR #113953 entfernt in Batches von 8, nur an der Provider-Grenze (20 Blöcke / 24 MB), mit der Politik zentralisiert in
agent/image_eviction_policy.py. - PR #113817 ergänzt zwei Schalter:
vision.embed_target_bytes(Standard 256 KB, begrenzt auf 64 KiB–4 MiB) undvision.max_calls_per_image(Standard: nur Subagenten begrenzt, auf 3;0= unbegrenzt). - Beide sind am 17. September 2026 in
maingemergt und noch in keinem getaggten Release (das neueste ist v0.21.3).