Tu UI de chat autoalojada por fin puede ver pensar al agente
Son las diez de la noche en la interfaz web autoalojada que montaste para tu equipo, y un compañero escribe “mira qué se rompió en los logs de build de la semana pasada”. Aparece un spinner. Y después nada. Veinte segundos, cuarenta segundos: asume que se ha colgado y recarga la página. En realidad el agente estaba metido a fondo en los logs, ejecutando comandos, discutiendo consigo mismo sobre qué fallo importaba. Simplemente, la capa compatible con OpenAI nunca se lo contó a nadie.
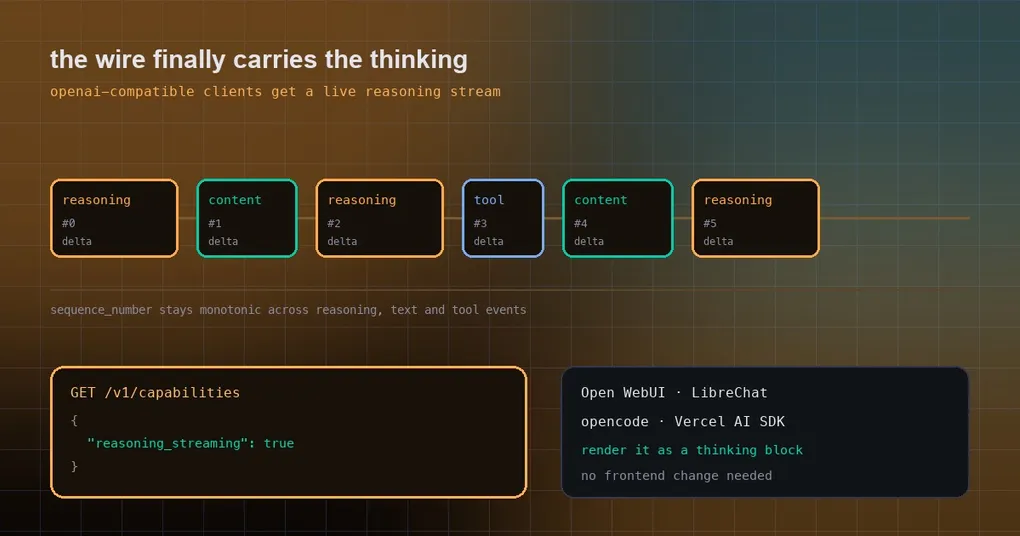
Si usas Hermes como backend detrás de Open WebUI, LobeChat, LibreChat, NextChat, ChatBox o un frontend que escribiste contra el Vercel AI SDK, ese silencio es la peor parte de la experiencia. El PR #115797, fusionado el 19 de septiembre, cierra esa brecha: esos frontends ya pueden mostrar el pensamiento del modelo mientras ocurre, igual que lo hacen las superficies oficiales.
El problema nunca fue el agente, sino el transporte
Hermes lleva un tiempo con un flujo de reasoning propio. El agente mantiene un reasoning_callback, y la CLI, la app de escritorio y el dashboard web lo usan para renderizar un bloque de “pensamiento” en vivo.
Los dos escritores SSE compatibles con OpenAI nunca registraban ese callback. El reasoning se perdía justo en la frontera del transporte: la misma respuesta que podías ver razonarse en una terminal llegaba a tu propio frontend como silencio absoluto. El arreglo en sí no tiene nada de glamuroso: conectar el callback existente a los escritores, anunciarlo y documentarlo.
Dos flujos, dos formatos de evento
Los detalles importan, porque cada frontend consume un formato distinto.
/v1/chat/completions (streaming): los deltas de reasoning llegan en choices[0].delta.reasoning_content, mientras el texto de la respuesta se queda en delta.content. reasoning_content es el campo estilo DeepSeek que Open WebUI, opencode y el Vercel AI SDK ya reconocen: lo renderizan como un bloque de pensamiento plegable sin que tengas que tocar nada en tu frontend.
/v1/responses (streaming): cada ráfaga de pensamiento es un item de salida reasoning nativo de la spec. El orden de los eventos es response.output_item.added (con item.type puesto en reasoning) → response.reasoning_summary_part.added → uno o más response.reasoning_summary_text.delta → ..._text.done → ..._part.done → response.output_item.done. El item se cierra antes de que se abra el siguiente mensaje o item function_call, y se repite en response.completed:
{"id": "rs_...", "type": "reasoning", "status": "completed", "summary": [{"type": "summary_text", "text": "..."}]}sequence_number se mantiene estrictamente monotónico a lo largo de los eventos de reasoning, texto y herramientas, así que un cliente que ensambla por número de secuencia no puede reordenar nada.
Sin streaming también funciona: /v1/chat/completions devuelve el reasoning del turno en choices[0].message.reasoning_content, y /v1/responses devuelve ese mismo item de salida reasoning por delante del mensaje.
Descubrimiento de capacidades: GET /v1/capabilities ahora anuncia features.reasoning_streaming: true. Un cliente puede decidir si renderiza un bloque de pensamiento o cae a un modo silencioso sin tener que adivinar números de versión.
Conectarlo en tres pasos
Si tu API server aún no está habilitado (viene desactivado por defecto), actívalo en el archivo de entorno:
# ~/.hermes/.env
API_SERVER_ENABLED=true
API_SERVER_KEY=change-me-local-dev
# Solo hace falta si un navegador debe llamar a Hermes directamente — mantenlo como allowlist
# API_SERVER_CORS_ORIGINS=http://localhost:3000
Arranca el gateway:
hermes gateway
# [API Server] API server listening on http://127.0.0.1:8642
Confirma que el reasoning aparece de verdad antes de tocar el frontend:
curl http://localhost:8642/v1/chat/completions \
  -H "Authorization: Bearer change...-dev" \
  -H "Content-Type: application/json" \
  -d '{"model": "hermes-agent", "stream": true,
       "messages": [{"role": "user", "content": "What is 23 times 47? Work it out first, then answer"}]}'
El stream alterna fragmentos de delta.reasoning_content y delta.content. Apunta el frontend a http://localhost:8642/v1 y listo: una UI como Open WebUI ya sabe dibujar un bloque de pensamiento; esta es la primera vez que hay algo que dibujar.
Tres cosas que conviene saber
Uno: puedes desactivarlo, pero no de forma global. El reasoning solo se emite cuando el modelo realmente produce razonamiento y la config reasoning resuelta lo permite. La desactivación por petición es model_options.reasoning.enabled: false. Si tu modelo no razona en absoluto, aquí no verás nada, y eso es lo esperado, no un fallo.
Dos: no expongas el API server a internet. Detrás de ese puerto está todo el conjunto de herramientas del agente, incluidos los comandos de terminal. API_SERVER_KEY es obligatorio en cualquier despliegue, incluso con el bind de loopback por defecto. Para acceso entre máquinas, usa un túnel SSH o Tailscale en lugar de hacer bind en 0.0.0.0 y cruzar los dedos.
Tres: de momento esto vive en main. El PR se fusionó el 19 de septiembre; la release etiquetada más reciente es v0.21.3 del 14 de septiembre. Para usarlo hoy sigues main (hermes update, o las instrucciones de rama del repositorio), o esperas a la siguiente etiqueta. En builds antiguas, /v1/capabilities simplemente no trae el campo, y un frontend que lo comprueba hace fallback sin problemas.
Por qué esto merece un artículo
Quien autoaloja un frontend suele hacerlo por uno de dos motivos: una interfaz más agradable, o datos que nunca salen de su red. Los dos grupos chocan con el mismo muro, porque el valor de un agente está precisamente en la deliberación previa a la conclusión, y la capa compatible con OpenAI solo entregaba el punto final.
Si tu preocupación va en la dirección contraria — que el modelo piense menos y gaste menos tokens — esa es otra palanca: reasoning_effort es ajustable por petición, y lo desglosamos en la guía de reasoning effort. Una controla si piensa; esta controla si puedes verlo. Ahora existen las dos.
¿Empiezas de cero? La guía de instalación cubre el backend, y la referencia del comando gateway cubre las otras plataformas que puede servir. La próxima vez que un compañero se quede mirando un spinner, al menos sabrá que está pensando.