Sua UI de chat auto-hospedada finalmente pode ver o agente pensando
Dez da noite, na UI web auto-hospedada que você montou para o seu time, um colega digita “veja o que quebrou nos logs de build da semana passada”. Um spinner gira. Depois, nada. Vinte segundos, quarenta segundos — ele conclui que travou e recarrega a página. Na verdade, o agente estava enfiado nos logs, rodando comandos, discutindo consigo mesmo sobre qual falha importava. A camada compatível com a OpenAI simplesmente nunca contou isso a ninguém.
Se você roda o Hermes como backend por trás do Open WebUI, LobeChat, LibreChat, NextChat, ChatBox ou de um frontend que você mesmo escreveu em cima do Vercel AI SDK, esse silêncio é a pior parte da experiência. O PR #115797, mesclado em 19 de setembro, fecha a lacuna: agora esses frontends podem mostrar o que o modelo está pensando enquanto acontece, do mesmo jeito que as superfícies oficiais fazem.
O problema nunca foi o agente — foi o transporte
O Hermes carrega um stream de raciocínio já há um bom tempo. O agente mantém um reasoning_callback, e a CLI, o app de desktop e o dashboard web usam esse callback para renderizar um bloco de “pensando” ao vivo.
Os dois writers de SSE compatíveis com a OpenAI nunca instalaram esse callback. O raciocínio era descartado exatamente na fronteira do transporte — a mesma resposta que você conseguia ver sendo raciocinada no terminal chegava ao seu frontend como silêncio absoluto. A correção em si não tem glamour nenhum: ligar o callback que já existia nos writers, anunciá-lo e documentá-lo.
Dois streams, dois formatos de evento
Os detalhes importam, porque frontends diferentes consomem formatos diferentes.
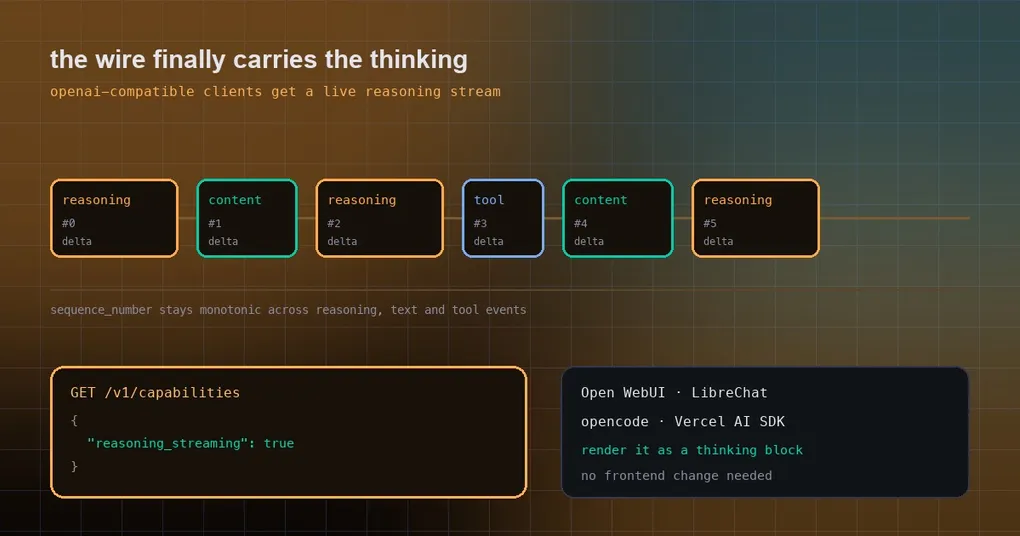
/v1/chat/completions (streaming): os deltas de raciocínio chegam como choices[0].delta.reasoning_content, enquanto o texto da resposta continua em delta.content. reasoning_content é o campo no estilo DeepSeek que o Open WebUI, o opencode e o Vercel AI SDK já reconhecem — eles o renderizam como um bloco de pensamento recolhível, sem nenhuma alteração no seu frontend.
/v1/responses (streaming): cada rajada de pensamento é um item de saída reasoning nativo da especificação. A ordem dos eventos é response.output_item.added (com item.type definido como reasoning) → response.reasoning_summary_part.added → um ou mais response.reasoning_summary_text.delta → ..._text.done → ..._part.done → response.output_item.done. O item fecha antes que a próxima mensagem ou o próximo item function_call abra, e ele é repetido em response.completed:
{"id": "rs_...", "type": "reasoning", "status": "completed", "summary": [{"type": "summary_text", "text": "..."}]}sequence_number permanece estritamente monotônico entre eventos de raciocínio, de texto e de ferramenta, então um cliente que monta tudo por número de sequência não consegue reordenar nada.
Fora do streaming também funciona: /v1/chat/completions devolve o raciocínio do turno em choices[0].message.reasoning_content, e /v1/responses devolve o mesmo item de saída de raciocínio antes da mensagem.
Descoberta de capacidade: o GET /v1/capabilities agora anuncia features.reasoning_streaming: true. Um cliente consegue decidir se renderiza um bloco de pensamento ou volta para um modo discreto sem ficar adivinhando números de versão.
Ligando tudo em três passos
Se o seu API server ainda não está habilitado (ele vem desligado por padrão), ligue-o no arquivo de ambiente:
# ~/.hermes/.env
API_SERVER_ENABLED=true
API_SERVER_KEY=change-me-local-dev
# Só é necessário se um navegador precisar chamar o Hermes diretamente — mantenha como allowlist
# API_SERVER_CORS_ORIGINS=http://localhost:3000
Inicie o gateway:
hermes gateway
# [API Server] API server listening on http://127.0.0.1:8642
Confirme que o raciocínio realmente aparece antes de mexer no frontend:
curl http://localhost:8642/v1/chat/completions \
  -H "Authorization: Bearer change-me-local-dev" \
  -H "Content-Type: application/json" \
  -d '{"model": "hermes-agent", "stream": true,
       "messages": [{"role": "user", "content": "What is 23 times 47? Work it out first, then answer"}]}'
O stream alterna chunks de delta.reasoning_content e de delta.content. Aponte o frontend para http://localhost:8642/v1 e pronto — uma UI como o Open WebUI já sabe desenhar um bloco de pensamento; esta é a primeira vez que existe algo para desenhar.
Três coisas que vale saber
Um: você pode desligar, mas não de forma global. O raciocínio só é emitido quando o modelo de fato produz raciocínio e a configuração resolvida de reasoning permite. O opt-out por requisição é model_options.reasoning.enabled: false. Se o seu modelo não faz raciocínio nenhum, você não vai ver nada aqui, o que é o esperado e não um defeito.
Dois: não exponha o API server para a internet. Atrás dessa porta está o conjunto completo de ferramentas do agente, comandos de terminal incluídos. API_SERVER_KEY é obrigatório em qualquer implantação, inclusive no bind padrão em loopback. Para acesso entre máquinas, use um túnel SSH ou Tailscale em vez de fazer bind em 0.0.0.0 e torcer.
Três: isso vive na main por enquanto. O PR foi mesclado em 19 de setembro; a release marcada mais nova é a v0.21.3 de 14 de setembro. Para usar hoje, você acompanha a main (hermes update, ou as instruções de branch no repositório), ou espera a próxima tag. Em builds mais antigos, o /v1/capabilities simplesmente não tem o campo, e um frontend que o verifica faz fallback sem problemas.
Por que isso merece um post
Quem auto-hospeda um frontend normalmente faz isso por um de dois motivos: uma interface mais agradável, ou dados que nunca saem da sua rede. Os dois grupos batem na mesma parede, porque o valor de um agente está justamente na deliberação antes da conclusão — e a camada compatível com a OpenAI costumava entregar apenas o ponto final.
Se a sua preocupação é a direção oposta — fazer o modelo pensar menos e gastar menos tokens —, esse é outro botão: reasoning_effort é ajustável por requisição, o que destrinchamos no guia do reasoning-effort. Um controla se ele pensa; este controla se você consegue assistir. Os dois agora existem.
Começando do zero? O guia de instalação cobre o backend, e a referência do comando gateway cobre as outras plataformas que ele pode servir. Na próxima vez que um colega ficar encarando um spinner, pelo menos ele vai saber que o agente está pensando.