自建聊天前端里,Agent 想什么你终于看得见了
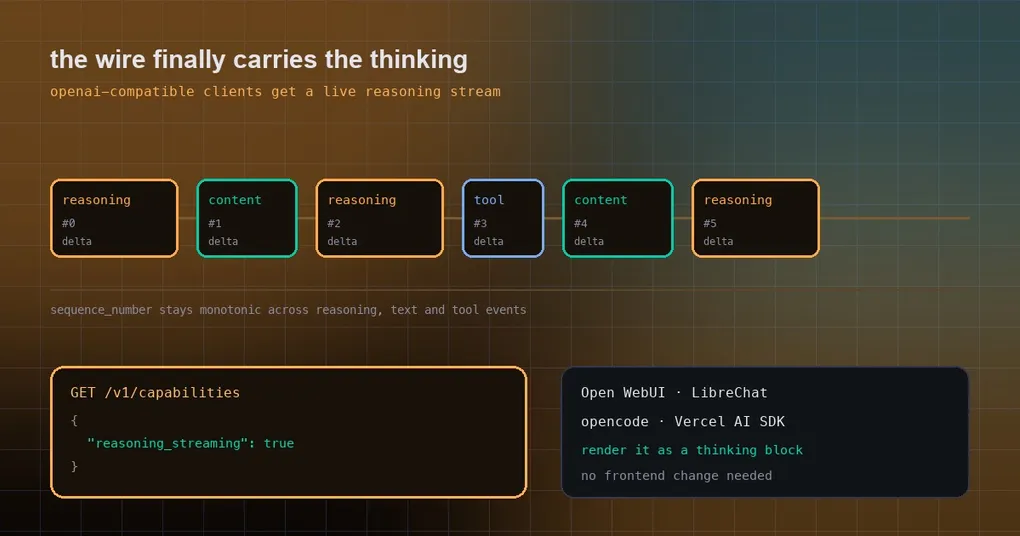
晚上十点,你给团队搭的自建 Web UI 上,产品同学敲了一行「帮我查一下上周的构建失败日志」。屏幕上转了个圈,然后……什么都没有。二十秒、四十秒,他以为卡死了,刷新了页面。其实 agent 正埋头翻日志、跑命令、自己跟自己讨论——只是这些过程,OpenAI 兼容层一个字都没往外发。
如果你把 Hermes 当作后端,接在 Open WebUI、LobeChat、LibreChat、NextChat、ChatBox,或者自己写的 Vercel AI SDK 前端上,这个空白就是最劝退的体验。9 月 19 日合入的 PR #115797 把它补上了:现在这些前端能像官方界面一样,实时显示模型的推理过程。
问题不在 Agent,在传输层
Hermes 自己是有推理流的。Agent 内部维护一个 reasoning_callback,CLI、桌面 App、Web 仪表盘都靠它渲染「正在思考」。
但 OpenAI 兼容的那两个写流函数从来没装过这个回调——推理在传输边界被直接丢掉了。于是同一段回答,在终端里你能看到模型怎么权衡的,在自建前端里只有一段沉默。PR #115797 做的事并不花哨:把已有的回调接到 SSE writer 上,顺手补上能力探测字段和文档。
两条流,两种事件
改动的细节值得抄下来,因为不同前端吃的是不同格式。
/v1/chat/completions(流式):推理增量走 choices[0].delta.reasoning_content,正文照旧走 delta.content。reasoning_content 是 DeepSeek 引入、后来被广泛接受的字段名,Open WebUI、opencode、Vercel AI SDK 都认识它——它们会自动把它渲染成一个可折叠的「思考」块,不用你改前端代码。
/v1/responses(流式):走规范原生的 reasoning 输出项,事件顺序是 response.output_item.added(item.type 为 reasoning)→ response.reasoning_summary_part.added → reasoning_summary_text.delta 若干次 → ..._text.done → ..._part.done → response.output_item.done。这组事件在下一条 message 或 function_call 之前闭合,并且会回显在 response.completed 的输出里:
{"id": "rs_...", "type": "reasoning", "status": "completed", "summary": [{"type": "summary_text", "text": "..."}]}sequence_number 在推理、正文、工具调用事件之间保持严格单调递增——前端按序号拼装不会乱序。
非流式同样有:/v1/chat/completions 的 choices[0].message.reasoning_content,/v1/responses 的 reasoning 输出项排在 message 之前。
能力探测:GET /v1/capabilities 现在返回 features.reasoning_streaming: true。客户端可以据此决定是渲染思考块还是退回安静模式,不用靠猜版本号。
怎么用:三步接上
如果你的 API server 还没开,先在最外层环境变量里打开(默认是关的):
# ~/.hermes/.env
API_SERVER_ENABLED=true
API_SERVER_KEY=change-me-local-dev
# 只有浏览器需要直连时才配置,且务必写白名单
# API_SERVER_CORS_ORIGINS=http://localhost:3000
启动 gateway:
hermes gateway
# [API Server] API server listening on http://127.0.0.1:8642
先确认推理真的出来了,再接前端:
curl http://localhost:8642/v1/chat/completions \
  -H "Authorization: Bearer change-me-local-dev" \
  -H "Content-Type: application/json" \
  -d '{"model": "hermes-agent", "stream": true,
       "messages": [{"role": "user", "content": "23 乘 47 等于多少?先心算再回答"}]}'
流式返回里会交替出现 delta.reasoning_content 与 delta.content 两种分片。然后把前端指向 http://localhost:8642/v1 即可——Open WebUI 之类的界面本来就会渲染思考块,这次是第一次真的有东西可渲染。
三个容易踩的点
第一,想关掉很容易,但不是全站开关。 推理只在模型确实产生推理、并且解析后的 reasoning 配置允许时才会发出;请求级的关闭开关是 model_options.reasoning.enabled: false。反过来说:如果你的模型本身不做推理,这里什么都不会出现,这很正常。
第二,别把 API server 直接暴露到公网。 这个端口背后是完整的 agent 工具集,包括终端命令。API_SERVER_KEY 在任何部署下都是必需的(哪怕是默认的 127.0.0.1),需要跨机器访问就走 SSH 隧道或 Tailscale,别把 0.0.0.0 和弱口令一起交出去。
第三,这是 main 上的新东西。 PR 在 9 月 19 日合入,而最新的标签发布是 9 月 14 日的 v0.21.3。想用就得跟 main(hermes update 或按仓库说明拉取),或者等下一个标签。用旧版本时 /v1/capabilities 里没有这个字段,前端退回安静模式即可,不会报错。
为什么这件事值得一提
自建前端的人分成两类:一类图界面舒服,一类图数据不出内网。这两类人都被同一个问题卡过——Agent 的价值恰恰在于它不假思索之前的那些「思索」,而 OpenAI 兼容层只把最后一个句号递出来。
顺带说一句,如果你在意的是让模型少想一点、省点 token,那是另一个方向的旋钮:请求体里的 reasoning_effort 可以按请求调档,我们在 推理档位那篇 里拆过。一个管「想不想」,一个管「看不看得见」,两件事现在都齐了。
想从零开始搭后端,先看安装指南;gateway 的其它平台配置在命令参考里。下次产品同学再盯着转圈,他至少知道——它在想。