Deine selbst gehostete Chat-UI kann dem Agenten endlich beim Denken zusehen
Zehn Uhr abends, in der selbst gehosteten Web-UI, die du für dein Team aufgesetzt hast, tippt eine Kollegin: „schau nach, was im Build-Log der letzten Woche kaputtgegangen ist.“ Ein Spinner dreht sich. Dann nichts. Zwanzig Sekunden, vierzig Sekunden — sie hält es für einen Hänger und lädt die Seite neu. Der Agent war in Wahrheit tief in den Logs, hat Befehle ausgeführt und mit sich selbst darüber gestritten, welcher Fehler zählt. Die OpenAI-kompatible Schicht hat es nur niemandem erzählt.
Wenn du Hermes als Backend hinter Open WebUI, LobeChat, LibreChat, NextChat, ChatBox oder einem Frontend betreibst, das du gegen das Vercel AI SDK geschrieben hast, ist genau dieses Schweigen der schlimmste Teil der Erfahrung. PR #115797, gemergt am 19. September, schließt die Lücke: Diese Frontends können das Denken des Modells jetzt live anzeigen, genau wie die offiziellen Oberflächen.
Das Problem war nie der Agent — es war der Transport
Hermes trägt schon eine Weile einen Reasoning-Stream mit sich. Der Agent unterhält einen reasoning_callback, und CLI, Desktop-App und Web-Dashboard nutzen ihn alle, um einen Live-„Thinking“-Block zu rendern.
Die beiden OpenAI-kompatiblen SSE-Writer haben diesen Callback nie installiert. Das Reasoning ging exakt an der Transportgrenze verloren — dieselbe Antwort, der du im Terminal beim Denken zusehen konntest, kam in deinem eigenen Frontend als Funkstille an. Der Fix selbst ist unspektakulär: den bestehenden Callback in die Writer verdrahten, ihn bekannt machen, ihn dokumentieren.
Zwei Streams, zwei Event-Formen
Die Details sind wichtig, denn verschiedene Frontends konsumieren verschiedene Formate.
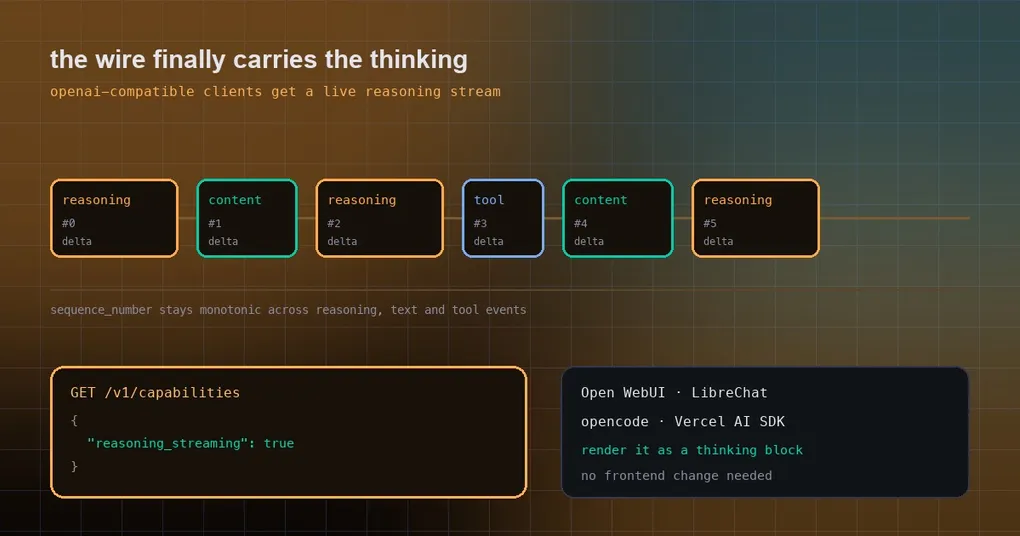
/v1/chat/completions (streaming): Reasoning-Deltas kommen als choices[0].delta.reasoning_content, während der Antworttext in delta.content bleibt. reasoning_content ist das Feld im DeepSeek-Stil, das Open WebUI, opencode und das Vercel AI SDK bereits kennen — sie rendern es als einklappbaren Thinking-Block, ohne dass du am Frontend etwas ändern musst.
/v1/responses (streaming): Jeder Denk-Ausbruch ist ein spezifikationsnatives reasoning-Output-Item. Die Event-Reihenfolge ist response.output_item.added (mit item.type auf reasoning) → response.reasoning_summary_part.added → ein oder mehrere response.reasoning_summary_text.delta → ..._text.done → ..._part.done → response.output_item.done. Das Item wird geschlossen, bevor die nächste Message oder ein function_call-Item geöffnet wird, und es wird in response.completed gespiegelt:
{"id": "rs_...", "type": "reasoning", "status": "completed", "summary": [{"type": "summary_text", "text": "..."}]}sequence_number bleibt über Reasoning-, Text- und Tool-Events hinweg streng monoton, sodass ein Client, der nach Sequenznummer zusammensetzt, nichts umsortieren kann.
Non-Streaming funktioniert ebenfalls: /v1/chat/completions liefert das Reasoning des Turns in choices[0].message.reasoning_content, und /v1/responses liefert dasselbe Reasoning-Output-Item vor der Message.
Capability-Discovery: GET /v1/capabilities gibt jetzt features.reasoning_streaming: true bekannt. Ein Client kann entscheiden, ob er einen Thinking-Block rendert oder auf einen stillen Modus zurückfällt, ohne Versionsnummern zu raten.
Einrichtung in drei Schritten
Wenn dein API-Server noch nicht aktiviert ist (standardmäßig ist er aus), schalte ihn in der Umgebungsdatei ein:
# ~/.hermes/.env
API_SERVER_ENABLED=true
API_SERVER_KEY=change-me-local-dev
# Nur nötig, wenn ein Browser Hermes direkt aufrufen soll — als Allowlist halten
# API_SERVER_CORS_ORIGINS=http://localhost:3000
Starte das Gateway:
hermes gateway
# [API Server] API server listening on http://127.0.0.1:8642
Prüfe, dass Reasoning wirklich ankommt, bevor du das Frontend anfasst:
curl http://localhost:8642/v1/chat/completions \
  -H "Authorization: Bearer change...-dev" \
  -H "Content-Type: application/json" \
  -d '{"model": "hermes-agent", "stream": true,
       "messages": [{"role": "user", "content": "What is 23 times 47? Work it out first, then answer"}]}'
Der Stream wechselt sich mit delta.reasoning_content- und delta.content-Chunks ab. Richte das Frontend auf http://localhost:8642/v1, und du bist fertig — eine UI wie Open WebUI weiß bereits, wie man einen Thinking-Block zeichnet; zum ersten Mal gibt es etwas zu zeichnen.
Drei Dinge, die man wissen sollte
Erstens: Du kannst es abschalten, aber nicht global. Reasoning wird nur ausgegeben, wenn das Modell tatsächlich welches produziert und die aufgelöste reasoning-Konfiguration es erlaubt. Der Opt-out pro Request ist model_options.reasoning.enabled: false. Wenn dein Modell überhaupt nicht denkt, siehst du hier nichts — das ist erwartet und nicht kaputt.
Zweitens: Setze den API-Server nicht dem Internet aus. Hinter diesem Port steckt das komplette Toolset des Agenten, Terminal-Befehle inklusive. API_SERVER_KEY ist für jedes Deployment Pflicht, auch bei der standardmäßigen Loopback-Bindung. Für Zugriff über Maschinen hinweg nutze einen SSH-Tunnel oder Tailscale, statt 0.0.0.0 zu binden und zu hoffen.
Drittens: Das lebt vorerst auf main. Der PR wurde am 19. September gemergt; das neueste getaggte Release ist v0.21.3 vom 14. September. Um es heute zu nutzen, folgst du main (hermes update oder den Branch-Anweisungen im Repo), oder du wartest auf den nächsten Tag. Bei älteren Builds fehlt /v1/capabilities schlicht das Feld, und ein Frontend, das es prüft, fällt sauber zurück.
Warum das einen Beitrag wert ist
Wer ein Frontend selbst hostet, tut das meist aus einem von zwei Gründen: eine schönere Oberfläche, oder Daten, die das eigene Netz nie verlassen. Beide Gruppen stoßen auf dieselbe Wand, denn der Wert eines Agenten liegt genau im Abwägen vor dem Schluss — und die OpenAI-kompatible Schicht übergab früher nur den letzten Punkt.
Wenn dich die umgekehrte Richtung umtreibt — das Modell weniger denken lassen und weniger Tokens verbrauchen —, ist das ein anderer Regler: reasoning_effort ist pro Request einstellbar, was wir in dem Leitfaden zu reasoning_effort auseinandergenommen haben. Der eine steuert, ob es denkt; dieser hier steuert, ob du zusehen kannst. Beide existieren jetzt.
Startest du bei null? Die Installationsanleitung deckt das Backend ab, und die Gateway-Befehlsreferenz deckt die anderen Plattformen ab, die es bedienen kann. Wenn eine Kollegin das nächste Mal auf einen Spinner starrt, weiß sie wenigstens, dass da gerade gedacht wird.