Votre interface de chat auto-hébergée peut enfin regarder l’agent penser
Dix heures du soir, sur l’interface web auto-hébergée que vous avez montée pour votre équipe. Un collègue tape « regarde ce qui a cassé dans les logs de build de la semaine dernière ». Un spinner tourne. Puis rien. Vingt secondes, quarante secondes — il en conclut que ça a planté et recharge la page. L’agent, lui, était en réalité au fond des logs, à exécuter des commandes, à débattre avec lui-même de l’échec qui comptait vraiment. La couche compatible OpenAI n’en a simplement jamais rien dit à personne.
Si vous faites tourner Hermes comme backend derrière Open WebUI, LobeChat, LibreChat, NextChat, ChatBox, ou un frontend que vous avez écrit vous-même contre le Vercel AI SDK, ce silence est le pire moment de l’expérience. La PR #115797, fusionnée le 19 septembre, comble le fossé : ces frontends peuvent désormais afficher la réflexion du modèle au moment où elle se produit, exactement comme le font les surfaces officielles.
Le problème n’a jamais été l’agent — c’était le transport
Hermes transporte un flux de raisonnement depuis un moment déjà. L’agent maintient un reasoning_callback, et le CLI, l’application desktop et le tableau de bord web s’en servent tous les trois pour afficher un bloc « réflexion » en direct.
Les deux writers SSE compatibles OpenAI n’ont jamais installé ce callback. Le raisonnement était abandonné exactement à la frontière du transport — la même réponse que vous pouviez regarder se construire dans un terminal arrivait dans votre propre frontend sous forme de silence radio. Le correctif lui-même est sans éclat : brancher le callback existant dans les writers, l’annoncer, le documenter.
Deux flux, deux formes d’événements
Les détails comptent, parce que les frontends ne consomment pas tous les mêmes formats.
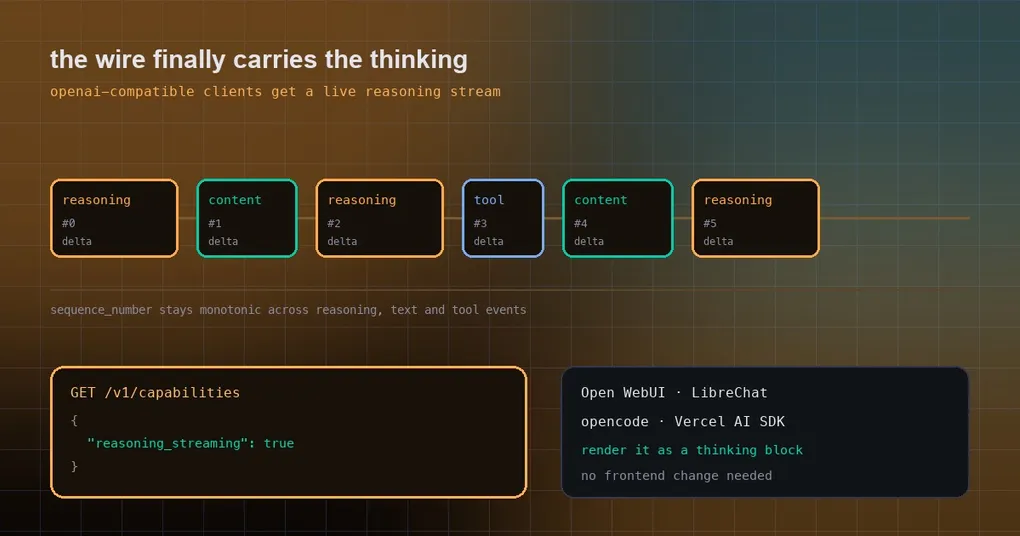
/v1/chat/completions (streaming) : les deltas de raisonnement arrivent dans choices[0].delta.reasoning_content, tandis que le texte de la réponse reste dans delta.content. reasoning_content est le champ de style DeepSeek que Open WebUI, opencode et le Vercel AI SDK reconnaissent déjà — ils l’affichent comme un bloc de réflexion repliable, sans la moindre modification de frontend de votre côté.
/v1/responses (streaming) : chaque salve de réflexion est un élément de sortie reasoning natif de la spec. L’ordre des événements est response.output_item.added (avec item.type défini à reasoning) → response.reasoning_summary_part.added → un ou plusieurs response.reasoning_summary_text.delta → ..._text.done → ..._part.done → response.output_item.done. L’élément se referme avant que le message suivant ou l’élément function_call ne s’ouvre, et il est repris dans response.completed :
{"id": "rs_...", "type": "reasoning", "status": "completed", "summary": [{"type": "summary_text", "text": "..."}]}sequence_number reste strictement monotone à travers les événements de raisonnement, de texte et d’outil, de sorte qu’un client qui assemble par numéro de séquence ne peut rien réordonner.
Le non-streaming fonctionne aussi : /v1/chat/completions renvoie le raisonnement du tour dans choices[0].message.reasoning_content, et /v1/responses renvoie le même élément de sortie reasoning avant le message.
Découverte de capacités : GET /v1/capabilities annonce désormais features.reasoning_streaming: true. Un client peut décider d’afficher un bloc de réflexion ou de retomber sur un mode silencieux sans avoir à deviner des numéros de version.
Le brancher en trois étapes
Si votre API server n’est pas encore activé (il est désactivé par défaut), activez-le dans le fichier d’environnement :
# ~/.hermes/.env
API_SERVER_ENABLED=true
API_SERVER_KEY=change-me-local-dev
# Nécessaire uniquement si un navigateur doit appeler Hermes directement — gardez une allowlist
# API_SERVER_CORS_ORIGINS=http://localhost:3000
Démarrez le gateway :
hermes gateway
# [API Server] API server à l’écoute sur http://127.0.0.1:8642
Confirmez que le raisonnement apparaît vraiment avant de toucher au frontend :
curl http://localhost:8642/v1/chat/completions \
  -H "Authorization: Bearer change...-dev" \
  -H "Content-Type: application/json" \
  -d '{"model": "hermes-agent", "stream": true,
       "messages": [{"role": "user", "content": "What is 23 times 47? Work it out first, then answer"}]}'
Le flux alterne des chunks delta.reasoning_content et delta.content. Pointez le frontend sur http://localhost:8642/v1 et c’est fini — une UI comme Open WebUI sait déjà dessiner un bloc de réflexion ; c’est la première fois qu’il y a quelque chose à dessiner.
Trois choses à savoir
Un : vous pouvez le désactiver, mais pas globalement. Le raisonnement n’est émis que lorsque le modèle en produit réellement et que la config reasoning résolue l’autorise. L’option de désactivation par requête est model_options.reasoning.enabled: false. Si votre modèle ne raisonne pas du tout, vous ne verrez rien ici : c’est attendu, pas cassé.
Deux : n’exposez pas l’API server sur Internet. Derrière ce port se trouve la panoplie complète d’outils de l’agent, commandes terminal comprises. API_SERVER_KEY est obligatoire pour tout déploiement, y compris la liaison loopback par défaut. Pour un accès entre machines, passez par un tunnel SSH ou Tailscale plutôt que de lier 0.0.0.0 en espérant que ça tienne.
Trois : pour l’instant, cela vit sur main. La PR a été fusionnée le 19 septembre ; la dernière version taguée est v0.21.3 du 14 septembre. Pour l’utiliser dès aujourd’hui, vous suivez main (hermes update, ou les instructions de branche du dépôt), sinon vous attendez le prochain tag. Sur les builds plus anciens, /v1/capabilities n’a tout simplement pas le champ, et un frontend qui le vérifie retombe proprement.
Pourquoi cela mérite un article
Ceux qui auto-hébergent un frontend le font en général pour l’une de deux raisons : une interface plus agréable, ou des données qui ne quittent jamais leur réseau. Les deux groupes se heurtent au même mur, parce que la valeur d’un agent réside précisément dans la délibération qui précède la conclusion — et la couche compatible OpenAI ne livrait autrefois que le point final.
Si votre préoccupation va dans l’autre sens — faire réfléchir le modèle moins et consommer moins de tokens — c’est un autre bouton : reasoning_effort se règle par requête, ce que nous détaillons dans le guide sur l’effort de raisonnement. L’un contrôle s’il réfléchit ; l’autre contrôle si vous pouvez le regarder faire. Les deux existent désormais.
Vous partez de zéro ? Le guide d’installation couvre le backend, et la référence de la commande gateway couvre les autres plateformes qu’il peut servir. La prochaine fois qu’un collègue fixera un spinner, au moins il saura que l’agent réfléchit.