语音那一轮不必和打字用同一个模型:Hermes 把语音轮的模型和思考都拆开了
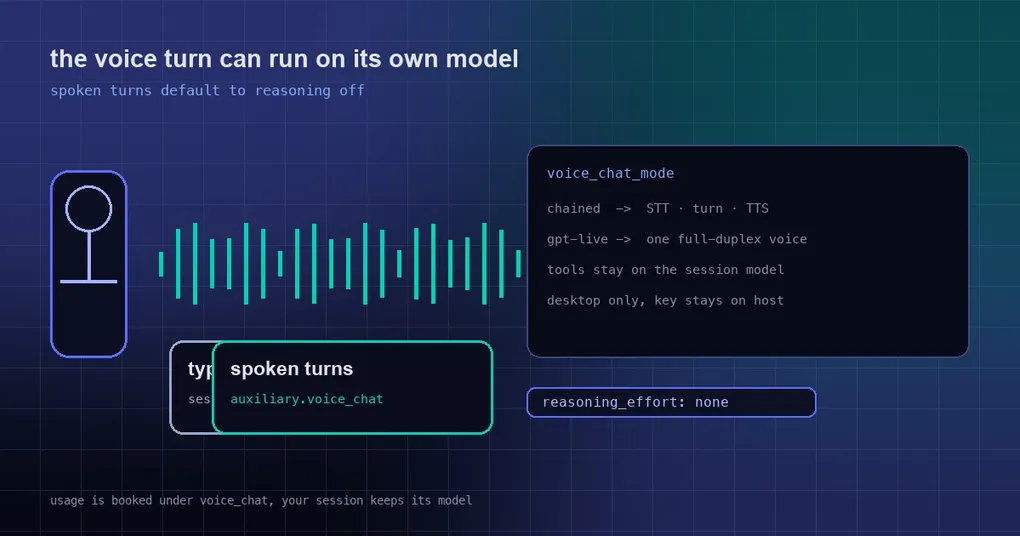
你在 Hermes Desktop 里开着语音跟 agent 说话,问一句“现在几点了”,中间那段安静长得足够你怀疑麦克风。等它开口,语速倒是自然,可你听得出它是先“想”了一遍再说——因为帮你回答的,正是你平时打字用的那个模型。问题不在语音链路,在于这一轮走的是同一套大脑:同一个模型、同一份思考预算、同一档价格。于是出现两个你不一定意识到的浪费:语音问答天生要快,却在跑长思考;语音通常是短问题,却按主力模型的账单结算。Hermes 现在把这两件事拆开了。
语音轮现在有独立的模型档位
新加的档位叫 auxiliary.voice_chat,和 vision、title_generation、compression 那些“辅助模型”是同一个机制:只换回答语音那一轮的模型,其它一切照旧。默认值是 auto,也就是沿用当前会话的模型——所以你什么都不做,行为和你熟悉的一样。
想换,有三种入口,改的都是同一个配置:
auxiliary:
  voice_chat:
    provider: openrouter          # "auto" = 用会话自己的模型(默认)
    model: google/gemini-3-flash-preview   # 留空但给了 provider,就用那家的快速模型
reasoning_effort: none # 默认:语音轮关闭思考(见下一节)- 桌面端:Settings → Models → Auxiliary models;
- 命令行:
hermes model→ 选 Auxiliary models,列表里多了voice_chat这一项,显示为currently: auto / main model; - 或者直接写进
config.yaml,就是上面那段。
生效范围要记清楚:凡是“说出来的那一轮”都算——CLI 和 TUI 的语音模式、桌面端的语音对话、以及消息平台上的语音条。语音轮拥有完整工具集,变的只有回答它的模型;你下一条打字消息仍然回到会话原本的模型,语音轮之后的记忆整理、技能回顾也一样回到会话模型。计费上,用量记在 voice_chat 这个任务名下,所以“会话的模型”这个归属不会被语音轮悄悄改掉。
默认把思考关掉,而且它会“记仇”
第二个改动更直接:语音轮默认关闭推理(reasoning_effort: none),而且即使你把档位留在 auto、由会话模型来答,也一样关。理由很朴素——语音交互的价值在及时响应,长思考会把“对话”变成“留言”。
有两个现实世界的例外,处理得很务实:
- 模型不允许关思考(比如强制思考的模型,或目录里标了必须开的路线)→ 它退而取最低可接受档位,而不是硬塞一个被拒绝的值;
- 某条路线在运行期拒绝了关闭请求 → 这个结果会被记住,下一次语音轮不再重复撞墙。
如果你想在语音里保留一点思考(比如让它边听边归纳),可以显式设一个档位;设成空字符串 "" 表示“跟随会话自己的设置”。
还有一个不显眼但很贴心的细节:语音模型从不会触发压缩。如果当前对话已经比这个(通常更小的)语音模型的上下文窗口还大,那一轮就直接由会话模型来答,并给你一条一次性提示——而不是悄悄压掉一半历史。
更彻底一点:让一个全双工语音模型接管
如果你觉得“STT → 一轮 → TTS”这个链条本身就慢,还有第二种模式。在桌面端把语音对话模式切成 gpt-live,整条链会被一个全双工语音模型替换掉:它一边说一边听,自己处理打断、语气词和背景噪声,自己没有工具;一旦你提出真正要做的事,它把请求转交给 Hermes——用你会话选的模型、完整工具集、记忆和审批来办——然后再把答案说给你听。
voice:
  voice_chat_mode: gpt-live     # chained(默认)| gpt-live
  gpt_live:
    voice: marin                # marin, cedar, quartz, ripple, vesper, willow, stone, gleam, meridian, …
    instructions: ""            # 可选:额外的语气/节奏/语言描述
需要一把 OpenAI API key(OPENAI_API_KEY、VOICE_TOOLS_OPENAI_KEY,或 voice.gpt_live.api_key)。注意计费:语音层由 OpenAI 按 每分钟 $0.05 的会话时长计费(空闲时间也算),而 Hermes 那一轮照旧按你自己的 provider 计费。如果选了 gpt-live 却没有可用的 key,按钮会回退到 chained 模式并提示你,不会静默失败。
它有几个明确不支持的地方,别踩:这种模式下不能走 Nous 托管的音频代理(必须直连 key)、只支持桌面端(CLI/TUI 的 /voice 仍然是 chained 链条)、tts 工具也仍然使用 tts.provider。另外,key 不会下发到客户端:桌面只拿到一个会话 id 和 SDP answer,真正创建会话(POST /api/audio/voice-live/session)的是网关主机。
几个容易踩的边界
gpt-live会忽略auxiliary.voice_chat:在这条路径上,语音层本身就是那个“快模型”,真正干活的是会话模型,所以再配一个语音模型没有意义。- 但 chained 模式下的打断参数仍然有效,而且值得调:
voice.barge_in(默认开)、voice.barge_in_threshold_multiplier(默认 3.0,越低越敏感——安静的蓝牙耳机可以试 1.5)、voice.barge_in_grace_seconds(默认 0.5)。调不好时可以设HERMES_VOICE_DEBUG=1,把每一块音频的 VAD 判定(校准底噪、RMS、是否触发)打到 stderr 上看。 - 语音轮的“快”是有代价的:更小的模型更可能答得敷衍。稳妥的用法是让语音轮跑一个快模型,遇到需要深想的请求时打字问——那条路径用的是你原来的模型,一分没降。
小结
auxiliary.voice_chat让“说出来的那一轮”用独立模型;默认auto(会话模型)。- 语音轮默认关闭思考;模型不支持关就退到最低档,被拒绝会被记住。
voice.voice_chat_mode: gpt-live用全双工语音模型替换整条链,由它把真实请求转交给会话模型;仅桌面端、需直连 OpenAI key、空闲也按 $0.05/分钟计。- 语音轮从不触发压缩;对话超窗时那一轮回落会话模型并提示。
语音链路的另外两半我们之前都单独写过:让本地语音模型常驻、句子级流式播放,以及上传前的静音裁剪与空闲卸载。加上今天这篇的“用哪个模型回答”,语音这条链的三段就齐了。