Um turno falado não precisa mais usar o seu modelo de digitação
Você está conversando com o Hermes Desktop com o modo de voz ligado, pergunta que horas são, e a pausa no meio é longa o bastante para você checar o microfone. Quando ele finalmente fala, o ritmo é natural, mas dá para ouvir que ele pensou antes — porque quem te responde é o mesmo modelo para o qual você digita. O problema não é o pipeline de áudio. É que este turno roda em o mesmo cérebro: mesmo modelo, mesmo orçamento de raciocínio, mesmo preço. Daí seguem dois desperdícios, e talvez você não tenha notado nenhum dos dois: a voz é a superfície que precisa ser rápida, e estava rodando raciocínio longo; os pedidos por voz costumam ser curtos, e eram cobrados como o seu modelo principal. O Hermes agora separou essas duas coisas.
Turnos falados ganham o seu próprio slot de modelo
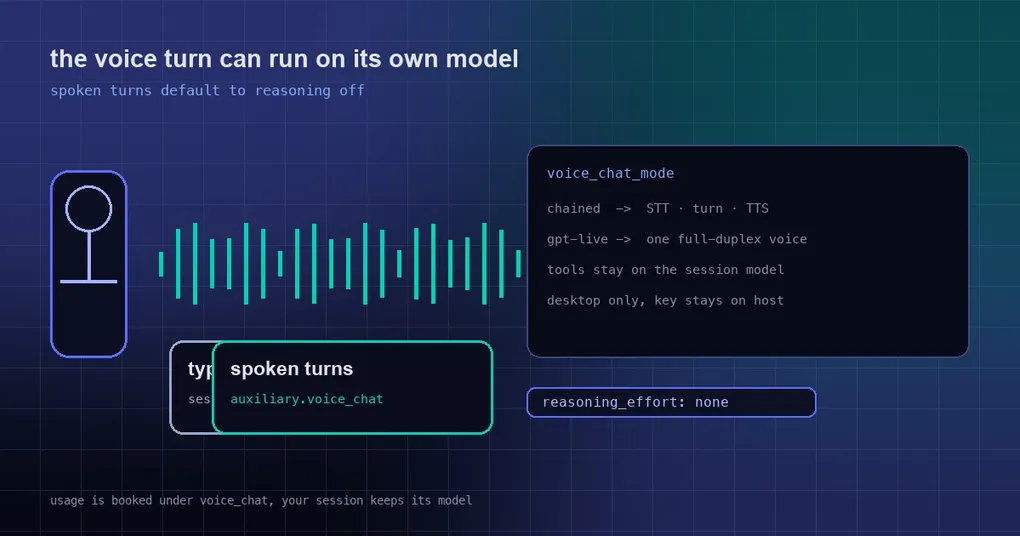
O novo slot é auxiliary.voice_chat, e ele funciona como os outros modelos auxiliares que você já conhece (vision, title_generation, compression): ele muda apenas o modelo que responde ao turno falado — todo o resto fica onde estava. O padrão é auto, que significa o modelo da sessão atual, então não fazer nada mantém o comportamento ao qual você está acostumado.
Três formas de mudá-lo, todas gravando a mesma config:
auxiliary:
  voice_chat:
    provider: openrouter          # "auto" = o modelo da própria sessão (padrão)
    model: google/gemini-3-flash-preview   # vazio com um provider = o modelo rápido desse provider
reasoning_effort: none # padrão: raciocínio desligado nos turnos de voz (veja abaixo)- Desktop: Settings → Models → Auxiliary models;
- CLI:
hermes model→ Auxiliary models, onde a lista agora carregavoice_chatcomocurrently: auto / main model; - Ou escreva direto no
config.yaml, exatamente como acima.
Conheça o raio de alcance: todo turno que é falado — modo de voz do CLI e da TUI, a conversa por voz do Desktop e as notas de voz nas plataformas de mensagens. O turno de voz mantém o toolset completo; só o modelo que o responde muda. A sua próxima mensagem digitada volta ao modelo da sessão, e o mesmo vale para as revisões de memória e de skills que seguem um turno. O uso é registrado sob a tarefa voice_chat, então um turno de voz nunca reescreve silenciosamente qual é o modelo da sua sessão.
O raciocínio fica desligado por padrão — e ele lembra de uma recusa
A segunda mudança é mais direta: os turnos de voz ficam com o raciocínio desligado por padrão (reasoning_effort: none), e isso vale mesmo quando você deixa o slot em auto e o modelo da própria sessão responde. A razão é simples: o valor de falar é o tempo de resposta; pensar demais transforma uma conversa em caixa postal.
Há duas exceções do mundo real, tratadas com bom senso:
- O modelo se recusa a desligar o raciocínio (um modelo de pensamento obrigatório, ou uma rota cujo catálogo a marca como obrigatória) → ele recebe o seu nível aceito mais baixo em vez de um valor que seria rejeitado;
- Uma rota rejeita o desligamento em tempo de execução → o resultado é memorizado, então o próximo turno de voz não bate na mesma parede.
Se você quiser um pouco de raciocínio na voz (digamos, para resumir enquanto escuta), defina um nível explicitamente. Definí-lo como a string vazia "" significa “siga o que a sessão usar”.
Mais um detalhe discreto: o modelo de voz nunca força uma compactação. Se a conversa já é maior que a janela de contexto desse modelo geralmente menor, aquele turno roda no modelo da sessão e você recebe um aviso único — em vez de metade do histórico desaparecer sem avisar.
Indo além: deixe um único modelo de voz full-duplex assumir o loop
Se a própria cadeia “transcrever → turno → falar” parece lenta, existe um segundo modo. Troque o modo de voz do Desktop para gpt-live e toda a cadeia é substituída por um único modelo de voz full-duplex: ele ouve enquanto fala, lida com interrupções, backchannels e ruído de fundo sozinho, e não tem tools próprias. No momento em que você pede trabalho de verdade, ele delega ao Hermes — o modelo da sua sessão, o toolset completo, a memória e as aprovações — e então fala a resposta de volta para você.
voice:
  voice_chat_mode: gpt-live     # chained (padrão) | gpt-live
  gpt_live:
    voice: marin                # marin, cedar, quartz, ripple, vesper, willow, stone, gleam, meridian, …
    instructions: ""            # frases extras opcionais de persona (tom, ritmo, idioma)
Ele precisa de uma chave de API da OpenAI (OPENAI_API_KEY, VOICE_TOOLS_OPENAI_KEY ou voice.gpt_live.api_key). Atenção à cobrança: a camada de voz é cobrada pela OpenAI a $0,05 por minuto de tempo de sessão (tempo ocioso conta), enquanto o turno do Hermes é cobrado no seu próprio provider, como sempre. Se o gpt-live estiver selecionado mas nenhuma chave resolver, o botão cai de volta para o modo encadeado com um aviso, em vez de falhar silenciosamente.
Vale conhecer alguns limites de antemão: este modo não pode usar o proxy de áudio gerenciado pela Nous (somente chave direta), é exclusivo do Desktop (o /voice do CLI/TUI continua no loop encadeado) e a tool tts continua usando tts.provider. A chave também nunca chega ao cliente — o desktop recebe um session id e uma resposta SDP, e o host do gateway cria a sessão (POST /api/audio/voice-live/session).
Arestas que pegam as pessoas de surpresa
- O
gpt-liveignora oauxiliary.voice_chat: nesse caminho a camada de voz já é o modelo rápido e o modelo da sessão faz o trabalho de verdade, então um modelo de voz separado não significa nada. - O ajuste de barge-in continua valendo no modo encadeado, e vale a pena ajustar:
voice.barge_in(ligado por padrão),voice.barge_in_threshold_multiplier(3.0 por padrão; menor é mais sensível — tente 1.5 num headset Bluetooth silencioso) evoice.barge_in_grace_seconds(0.5). Quando ele se comporta mal,HERMES_VOICE_DEBUG=1transmite as decisões de VAD por bloco (piso calibrado, RMS, disparo) para o stderr. - Velocidade tem um custo: um modelo menor tem mais chance de responder de forma superficial. O padrão seguro é um modelo rápido na voz e digitar a pergunta quando você precisa de profundidade — esse caminho ainda usa o seu modelo original, sem diluição.
Para fechar
- O
auxiliary.voice_chatdá ao turno falado o seu próprio modelo; o padrão éauto(o modelo da sessão). - Os turnos de voz ficam com o raciocínio desligado por padrão; um modelo que não consegue desligá-lo cai para o seu nível mais baixo, e uma recusa em tempo de execução é memorizada.
voice.voice_chat_mode: gpt-livetroca toda a cadeia por um modelo de voz full-duplex que delega trabalho de verdade ao modelo da sessão — só no Desktop, chave direta da OpenAI, $0,05/min incluindo tempo ocioso.- O modelo de voz nunca força uma compactação; se a conversa excede a sua janela, aquele turno cai de volta no modelo da sessão com um aviso.
Já cobrimos as outras duas metades da cadeia de voz: manter o modelo de fala local quente com streaming por frase, e corte de silêncio antes do upload mais descarregamento por ociosidade. Com o “qual modelo responde” de hoje, os três estágios estão documentados.