Dois segundos de silêncio toda vez que você diz a wake word — as vozes locais param de recarregar
Você diz “hey, what’s on my calendar today” no microfone e espera. Um segundo, dois, e no terceiro ele começa a falar — ele ouviu você, só estava carregando o modelo de voz na memória. A parte que enlouquece é que isso acontece em todo despertar. Você nem consegue chamar de “lento para começar”, porque ele não está começando; está começando de novo.
Motores de TTS locais — Piper, KittenTTS, qualquer coisa rodando na sua própria máquina — carregam de forma preguiçosa para economizar memória. Esse desenho está certo. O problema é o momento do unload. Uma nova chave de config na v0.21.5 corrige isso, e o mesmo lote finalmente faz o loop de voz do desktop ler sua configuração. Aqui estão todos os interruptores.
1. O problema não é carregar devagar, é descarregar cedo demais
A lógica original: ligar “ler respostas em voz alta” ou iniciar uma conversa por voz toma um lease do engine, e desligar libera esse lease. Quando o último lease é liberado e a contagem de detentores chega a zero, o modelo é descarregado imediatamente.
Uma conversa por wake word funciona assim: você diz a wake word, ele entra em conversa por voz — isso custa mais de um segundo de aquecimento (uma voz Piper tem dezenas de MB, a KittenTTS chega a cerca de 80 MB) — você diz uma frase, a conversa termina, o lease é liberado. O modelo é, portanto, despejado milissegundos depois de terminar de carregar. O próximo wake paga tudo de novo.
Existe uma variante pior: quando um release cai durante um carregamento (os toggles da CLI/TUI rodam acquire e release em threads separadas), o unload encontra um cache vazio, então o modelo fica residente sem nenhum detentor — ocupando memória e não sendo reutilizado por ninguém.
2. tts.keep_warm_seconds: o unload espera um pouco
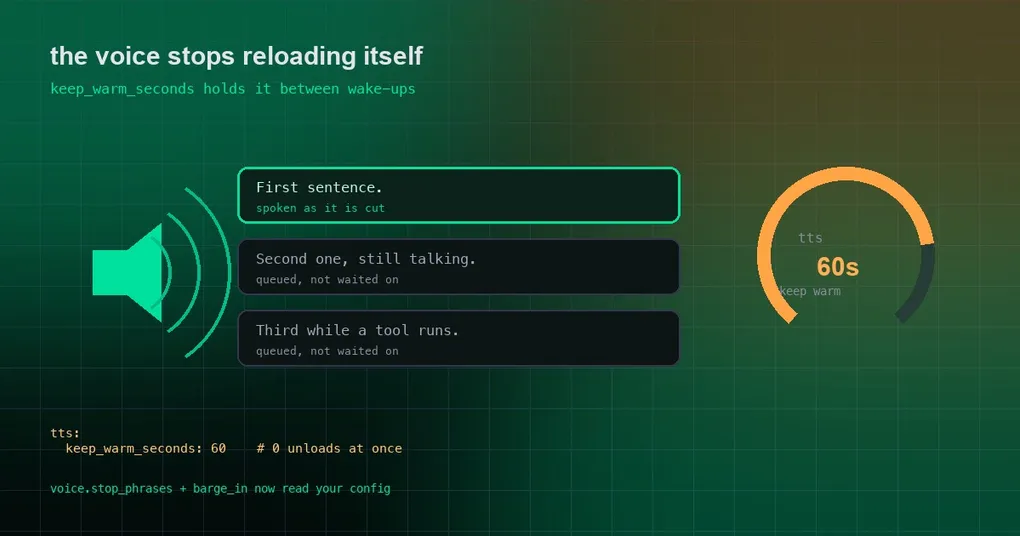
A nova chave é tts.keep_warm_seconds, padrão 60:
tts:
  keep_warm_seconds: 60    # keep a local engine loaded this long after the last toggle off (0 = unload at once)
A semântica é exatamente o que parece: depois do último release, o unload é agendado em um timer cancelável por esse tempo. Qualquer acquire dentro da janela cancela o unload pendente e reutiliza o modelo carregado. Três detalhes valem a pena:
- O valor é lido a cada chamada, então o
config.yamlde cada profile vale por si em vez de um valor global. - Um contador de geração faz um timer que já acordou virar no-op, então “o timer disparou mas alguém readquiriu no meio” não consegue descarregar um modelo em uso.
- Um aquecimento que termina sem detentores reinicia a janela — então aquecer e desligar imediatamente ainda te dá os 60 segundos completos.
O padrão mora em hermes_cli/config_defaults.py, e o comportamento está documentado na seção de lease do website/docs/user-guide/features/tts.md e no bloco de TTS do configuration.md. Para ver o que a sua instalação reporta:
hermes config get tts.keep_warm_seconds    # 60
hermes config set tts.keep_warm_seconds 0  # back to "unload immediately" if memory matters more
Definir 0 é a válvula de escape para máquinas com memória apertada que não se importam com o reload. Se o seu uso de voz é intenso, aumente em vez disso — o custo é que dezenas de MB ficam residentes por um tempo.
3. Os leases abrangem superfícies, e é isso que impede que se atropelem
Essa parte do desenho é fácil de passar batido e genuinamente útil: cada toggle segura um lease, e o modelo só é descarregado quando o último lease entre todas as superfícies é liberado. Desligar a leitura em voz alta em uma janela do Desktop, portanto, nunca puxa o engine debaixo de uma conversa por voz rodando em outra.
O mesmo mecanismo de lease chega aos providers declarados pelo usuário: um provider do tipo command roda seus opcionais warm_command / release_command, e um provider plugin Python recebe warm() / release(). Seu próprio servidor de TTS auto-hospedado pode pré-carregar e descarregar nos toggles, em vez de você inventar um hook. O Desktop chama POST /api/audio/tts-lease com {"lease": "<name>", "active": true} ou false, e outros frontends podem usar o mesmo endpoint.
Um pequeno extra que vale configurar: tts.streaming.min_len (padrão 20) é a menor primeira frase falada sozinha — aberturas mais curtas pegam carona com a frase seguinte. Vinte serve para o inglês; configurações de voz para CJK geralmente usam algo em torno de 6.
4. A parada falada no desktop agora lê sua config
Sintoma: o aviso manda você dizer “отбой” para encerrar a conversa por voz, você diz, e a palavra é enviada ao agent como prompt.
Causa: o matcher de parada isVoiceStopCommand() comparava com uma lista fixa em inglês, enquanto o aviso mostrado a você vem de voice.stop_phrases. Um usuário russo seguindo a instrução na tela não tinha chance.
Correção (PR #120751): o matcher agora lê os mesmos voice.stop_phrases que o aviso anuncia, mantendo a semântica do backend (tools/voice_mode_transcript.is_voice_stop_phrase):
voice:
stop_phrases: ["stop"] # the whole utterance must equal one of these; [] disables spoken stop- a fala inteira precisa ser igual a uma frase (sem diferenciar maiúsculas, ignorando pontuação), não apenas contê-la;
- uma string solta conta como uma frase;
[]desativa a parada falada;- um valor malformado cai para o padrão.
Há um detalhe de compatibilidade que vale sinalizar: /api/config mescla o DEFAULT_CONFIG, então uma instalação padrão sempre reporta stop_phrases: ["stop"]. Uma implementação que simplesmente usasse o que carregou faria todo usuário do desktop perder as frases extras em inglês — goodbye, never mind, cancel — então esta aqui compara a lista carregada com /api/config/defaults para evitar essa regressão.
5. A reprodução com barge-in usa o seu limiar
Sintoma: você está em um headset Bluetooth, fala por cima da resposta para interrompê-la — e nada acontece.
Causa: o nível de disparo da reprodução estava fixo em PLAYBACK_MIN_TRIGGER_LEVEL = 0.14, que fica acima do nível de fala de um headset Bluetooth HFP enquanto uma resposta toca, então sua voz nunca cruzava a linha.
Correção (PR #120751): agora ele usa o voice.barge_in_threshold_multiplier já existente (padrão 3.0) — o botão que o listener full-duplex da CLI/TUI sempre leu. Nenhuma configuração nova e nenhuma variável de ambiente. Os comentários da config descrevem o modelo: o piso de sala silenciosa é calibrado antes da reprodução, e o gatilho de fala é esse piso vezes o multiplicador.
6. O Read Aloud para de falar placeholders, e as tabelas falam o cabeçalho
Sintoma: com uma voz não-inglesa (uma voz MiniMax chinesa no relato), um bloco de código era lido em voz alta como as palavras inglesas “code block omitted”, uma URL como “link”, e uma tabela Markdown sumia sem nada falado no lugar.
Correção (PR #120752):
- Blocos de código e URLs ficam silenciosos — nenhuma palavra de placeholder em idioma nenhum, e o código continua visível na tela;
- Tokens de link de arquivo
MEDIA:nunca chegam à voz (tanto o sanitizer do desktop quanto o normalizador do backendtools/tts_text_normalize.py, que sustenta o gateway, a voz da CLI e os relays WS/POST do desktop); pontuação logo depois de um token inline é mantida, então “see MEDIA:/x.py. Then” preserva o ponto final; - Dois-pontos no fim da linha fecham: quando um bloco de código que vinha depois de “here is the list:” é removido, os dois-pontos pendurados viram ponto; dois-pontos precedidos de dígito (
3:2) são deixados em paz no backend; - As tabelas falam a linha de cabeçalho — ele diz “Item, Value, Notes.” e pula as linhas do corpo. Quem ouve aprende que há uma tabela na tela e o que ela compara, sem escutá-la célula por célula. Uma tabela cujas células de cabeçalho estão todas vazias fica silenciosa.
7. A reprodução frase a frase ainda está só no main
Uma correção intimamente relacionada não está na v0.21.5, e merece nota própria porque ataca os segundos de abertura silenciosos de uma resposta longa.
Com TTS da Edge (ou qualquer TTS sem streaming), o modo de voz do desktop costumava esperar a resposta inteira e sintetizá-la de uma vez, então uma resposta longa começava com segundos de silêncio. A documentação promete streaming por frase, mas a correção anterior cobria apenas providers com streaming; o fallback síncrono (awaitFallbackSpeech) ainda esperava a resposta completa. Esse caminho agora mantém uma fila de frases e reproduz cada frase concluída conforme ela é cortada (PR #121685, issue #79314), e um balão intermediário selado (message.interim) é liberado a cada tick de polling, então sua última frase é falada enquanto uma ferramenta roda, e não depois que ela termina.
Esse PR foi mesclado no main na tarde de 24 de setembro de 2026 (por volta de 17:12 UTC), depois de a v0.21.5 ser publicada às 10:09 UTC daquela manhã — então por enquanto ele está só no main.
8. Os atalhos de voz por teclas de função são remapeáveis (este está na v0.21.5)
O ditado one-shot virou uma ação de teclado composer.dictate sem binding, separada da conversa por voz, reutilizando o caminho de captura que o Desktop já tinha para teclas F, Caps Lock, Delete, Space e combinações com modificadores. O campo obsoleto voice.record_key do Desktop foi removido, com uma nota de que a config segue exclusiva da CLI/TUI. A arbitragem do Electron faz com que um F12 atribuído chegue ao renderer enquanto um F12 não atribuído mantém o comportamento do DevTools (PR #120928).
Na mesma janela, fluxos de teclas de função no macOS foram corrigidos: o parser da TUI mantém intactas as sequências de terminal F1–F12 (incluindo caminhos do protocolo de teclas modificadas), e o dock de trabalho ao vivo ganhou Ctrl+R como fallback portátil do F7 tanto na TUI quanto na CLI clássica (PR #120666).
Status da release em resumo
| Capacidade | PR | Status |
|---|---|---|
Retenção de aquecimento do tts.keep_warm_seconds |
#121080 | na v0.21.5 |
Parada falada lê voice.stop_phrases |
#120751 | na v0.21.5 |
Barge-in usa voice.barge_in_threshold_multiplier |
#120751 | na v0.21.5 |
| Read Aloud: sem placeholders, tabelas leem o cabeçalho | #120752 | na v0.21.5 |
| Ditado remapeável por teclas de função | #120928 | na v0.21.5 |
F1–F12 no macOS e o fallback Ctrl+R |
#120666 | na v0.21.5 |
| Reprodução frase a frase do TTS Edge/síncrono | #121685 | só no main |
O que checar na sua própria instalação
hermes config get tts.keep_warm_seconds                 # 60
hermes config get voice.stop_phrases                    # - stop
hermes config get voice.barge_in_threshold_multiplier   # 3.0
Depois faça o teste de verdade: diga a wake word, fale uma frase, encerre a conversa, espere alguns segundos e desperte de novo — a segunda resposta deve ser visivelmente mais rápida, porque o modelo ainda está na memória.
A versão curta
- A dor da voz local é descarregar cedo demais, não carregar devagar: uma conversa que só desperta libera o lease milissegundos depois de o aquecimento terminar.
tts.keep_warm_seconds(padrão 60) faz o unload esperar, e um novo acquire dentro da janela o cancela;0restaura o descarregamento imediato.- A parada falada e o limiar de barge-in agora leem sua config, em vez de uma lista fixa em inglês e de um nível fixo.
- O Read Aloud não fala mais placeholders e as tabelas leem seu cabeçalho; a reprodução frase a frase ainda está no
main, não na v0.21.5.
Este lote pertence à v0.21.5, aquela janela de patch sem release notes — a lista mais completa está na nossa página da release v0.21.5 e no guia de autoverificação da janela v0.21.5.