喊一声它要沉默两秒:本地语音不再每次重新加载模型
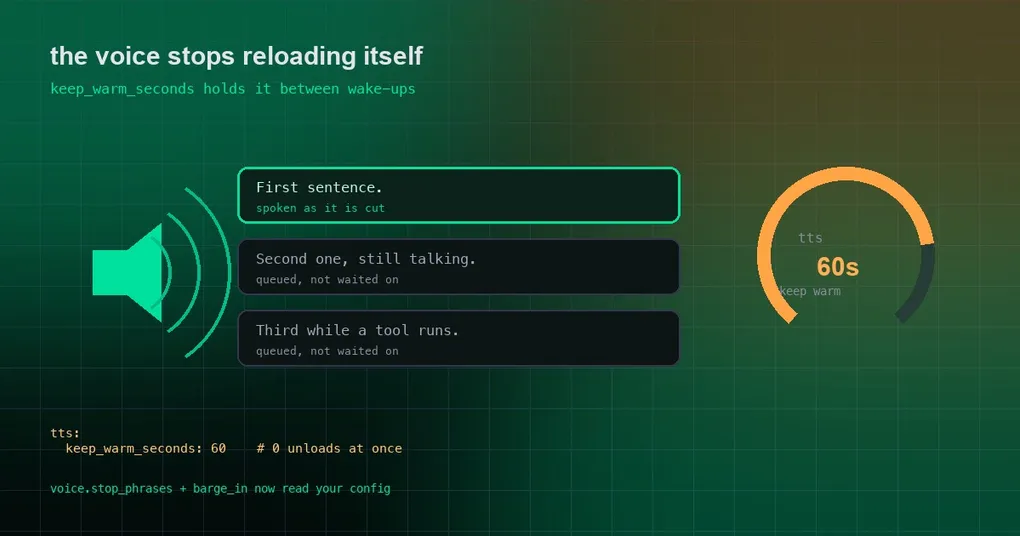
你对着麦克风说「嘿,帮我查一下今天的日程」,然后等。一秒,两秒,第三秒它才开口——它听见你了,只是还在把语音模型加载进内存。更让人难受的是:这件事每次唤醒都会发生一遍。你甚至没法抱怨它“启动慢”,因为它是每次都“重新启动”。
本地 TTS(Piper、KittenTTS 这类跑在自己机器上的语音引擎)为了省内存是懒加载的:用到才载入。这个设计本身没问题,问题出在卸载的时机上。v0.21.5 里的一个新配置项把这件事修正了,同一批还让桌面端的语音循环真正开始读你的配置。这篇讲清每个开关。
一、问题不在加载慢,在卸载太快
先看原来的逻辑:每次你打开“朗读回复”或者开始一段语音会话,就相当于对语音引擎持有一次租约(lease);关掉时释放。当最后一个租约释放、持有者计数归零,代码会立刻卸载模型。
那段“唤醒词式”的对话是这样的:你喊一声,它进入语音会话——这中间有一秒多的预热加载(Piper 的声音模型是几十 MB,KittenTTS 最多约 80MB)——你说一句话,对话结束,租约释放。于是模型在加载完几毫秒之后就被驱逐了。下一次唤醒,从零再来一遍。
还有一个更隐蔽的变体:释放发生在加载过程中的时候(CLI/TUI 里切换语音的 acquire 和 release 跑在不同线程上),卸载会看到一个空缓存,于是模型留在内存里,但持有者是零——既占着内存,又没被复用。
二、tts.keep_warm_seconds:卸载等一等
新的配置项是 tts.keep_warm_seconds,默认 60:
tts:
keep_warm_seconds: 60 # 最后一次关闭后再保留这么久(0 = 立即卸载)语义很直白:最后一次释放后,卸载会被安排在一个可取消的定时器上等这么久。在这个窗口内,任何一次重新开启(重新 acquire)都会取消这次卸载,直接复用已经加载的模型。具体有三个细节值得知道:
- 按调用读取配置,所以每个 profile 自己的
config.yaml生效,不是全局写死。 - **用一个代数计数器(generation counter)**保证一个已经醒来的定时器变成空操作——不会出现“定时器醒了、又已经有人重新持有”的竞态把模型卸掉。
- 一次没有持有者的预热结束后,窗口会重新开始计时——也就是说你刚预热完立刻关掉,仍然是按 60 秒算。
配置默认值在 hermes_cli/config_defaults.py 里,说明写进了 website/docs/user-guide/features/tts.md 的租约小节和 configuration.md 的 TTS 块。想验证自己拿到的值:
hermes config get tts.keep_warm_seconds    # 60
hermes config set tts.keep_warm_seconds 0  # 想省内存就设 0,行为回到"立即卸载"
设成 0 是给“内存紧张、不在乎每次重载”的人留的退路。反过来,如果你的语音交互很密集,可以调大——代价是一段时间内那几十 MB 常驻内存。
三、租约本身是跨界面的,换句话说它能防“互相踩”
这一点是设计里比较容易忽略但很实用的部分:每个开关持有一份租约,只有跨所有界面的最后一个租约释放时模型才会卸载。所以你在桌面端一个窗口里关掉朗读,不会把另一个窗口正在进行的语音对话的引擎抽走。
同样的租约机制也覆盖用户自定义的 provider:命令行型 provider 会执行它可选的 warm_command / release_command,Python 插件型 provider 会收到 warm() / release()。也就是说你自建的语音服务同样可以按开关预加载和卸载,而不是自己想办法挂钩。桌面端调用的是 POST /api/audio/tts-lease,请求体是 {"lease": "<name>", "active": true} 或 false,其他前端可以直接用同一个端点。
另外一个小而有用的配置:tts.streaming.min_len(默认 20)决定多长的首句才被单独朗读;更短的开场白会跟下一句一起读。默认 20 适合英语,中日韩的语音配置一般用 6 左右。
四、桌面端的口头停止,现在读你的配置
症状:你按提示说“отбой”想结束语音对话,结果这句话被当成 prompt 发给了 agent。
原因:判断口头停止的 isVoiceStopCommand() 只匹配一份写死的英文列表,而界面上提示你的那句话来自 voice.stop_phrases。俄语用户看到提示说“说 отбой 结束”,说出来的词却根本不在匹配表里。
修法(PR #120751):匹配器改为读取和提示同一份 voice.stop_phrases,并且沿用后端的语义(tools/voice_mode_transcript.is_voice_stop_phrase):
voice:
stop_phrases: ["stop"] # 整句话必须等于其中一个短语才结束;[] 表示禁用口头停止- 整句话必须等于某个短语(忽略大小写和标点),不是包含;
- 写成裸字符串会被当成一个短语;
[]表示禁用口头停止;- 值格式不合法时回落到默认值。
还有一个必须注意的兼容细节:/api/config 会把 DEFAULT_CONFIG 合并进来,所以默认安装永远会报出 stop_phrases: ["stop"]。如果实现只做“读到什么用什么”,那么每一个桌面端用户都会失去 goodbye、never mind、cancel 这些额外英文短语——这次的实现会把加载到的列表和 /api/config/defaults 做比较,避免这个回归。
五、喊话打断播放,用你的阈值
症状:你戴着蓝牙耳机,在它朗读回复的时候开口打断——它不理会。
原因:触发“打断播放”的阈值写死为 PLAYBACK_MIN_TRIGGER_LEVEL = 0.14,这个值高于蓝牙 HFP 耳机在播放时的说话电平,所以你怎么说都够不到那条线。
修法(PR #120751):改用已有的 voice.barge_in_threshold_multiplier(默认 3.0)——CLI/TUI 的全双工监听器一直在读这个键,只是桌面端没用它。没有新增配置项,也没有环境变量。 配置里的注释写得很清楚:播放前先标定安静房间的底噪,说话触发的门槛是“底噪 × 这个倍数”。
六、朗读不再念占位词,表格改念表头
症状:用中文(或其他非英文)语音时,读到代码块的位置会念出英文的 “code block omitted”,读到链接的位置念 “link”;遇到 Markdown 表格则整块消失,没有任何提示。
修法(PR #120752):
- 代码块和 URL 完全静默——任何语言都不再念占位词,代码在屏幕上照常可见;
MEDIA:文件链接令牌不会进语音(桌面端清洗器和后端规范化器tools/tts_text_normalize.py都改了,后者同时支撑 gateway、CLI 语音和桌面的 WS/POST 转发);行内令牌紧跟的标点会保留,所以 “see MEDIA:/x.py. Then” 的句号还在;- 行尾冒号会闭合:当“这里有三个:“后面跟着的代码块被移除时,冒号会被改成句号;前面是数字的冒号(比如 3:2)在后端不会被动;
- 表格改念表头行——它会读 “Item, Value, Notes.” 然后跳过数据行。听的人知道这里有一张表、比的是什么,又不用一个单元格一个单元格地听下去。表头全为空的表格保持静默。
七、逐句朗读:还在 main 上
还有一条相关但是不在 v0.21.5 里的修复,值得单独说明,因为它解决的是“长回答开头几秒的沉默”:
用 Edge(或其他非流式)TTS 时,桌面端语音模式以前会等整段回复生成完再一次性合成,所以长回答前面会有好几秒没声音。文档承诺的是逐句朗读,但之前的修复只覆盖了流式 provider,同步回退路径(awaitFallbackSpeech)仍然在等完整回复。现在这条路径维护一个句子队列,每切出一句就立刻播放(PR #121685 / issue #79314);同时被封存的中间气泡(message.interim)会在每个轮询周期被冲刷,它的最后一句在工具执行期间就被念出来,而不是等工具跑完。
这条 PR 合入 main 的时间是 2026 年 9 月 24 日下午(UTC 约 17:12),晚于 v0.21.5 在当天上午 10:09 UTC 的发布,所以目前只在 main 上。
八、功能键语音快捷键可以重新绑定(这条在 v0.21.5 里)
一键口述变成了一个未绑定的 composer.dictate 键盘动作,和语音对话分开;它复用了桌面端既有的按键捕获路径(F 键、Caps Lock、Delete、Space 以及组合键)。过时的桌面端 voice.record_key 字段被移除,并注明该配置只对 CLI/TUI 有效。Electron 侧加了仲裁:被指派给渲染进程的 F12 能收到按键,没被指派的 F12 保留 DevTools 行为(PR #120928)。
同一个窗口里,macOS 上的功能键工作流也修好了:TUI 解析器保留 F1–F12 终端序列(包括带修饰键的协议路径),并且给 TUI 和经典 CLI 的实时工作坞加了 Ctrl+R 作为 F7 的可移植备选(PR #120666)。
发布状态一览
| 能力 | PR | 状态 |
|---|---|---|
tts.keep_warm_seconds 保活 |
#121080 | 在 v0.21.5 里 |
口头停止读 voice.stop_phrases |
#120751 | 在 v0.21.5 里 |
打断阈值用 voice.barge_in_threshold_multiplier |
#120751 | 在 v0.21.5 里 |
| 朗读不再念占位词、表格念表头 | #120752 | 在 v0.21.5 里 |
| 功能键口述可重绑 | #120928 | 在 v0.21.5 里 |
macOS F1–F12 与 Ctrl+R 备选 |
#120666 | 在 v0.21.5 里 |
| Edge/同步 TTS 逐句朗读 | #121685 | 仅在 main |
你可以做的自查
hermes config get tts.keep_warm_seconds                 # 60
hermes config get voice.stop_phrases                    # - stop
hermes config get voice.barge_in_threshold_multiplier   # 3.0
然后做一次真实测试:喊一次唤醒词,说完一句结束对话,隔几秒再喊一次——第二次的反应应该明显更快(模型还在内存里)。
小结
- 本地语音的痛点是卸载太早,不是加载太慢:唤醒式对话在预热结束几毫秒后就释放租约。
tts.keep_warm_seconds(默认 60)让卸载等一等,窗口内重新开启会取消卸载;0回到立即卸载。- 口头停止和打断阈值现在都读你的配置,不再用写死的英文列表和硬编码电平。
- 朗读不再念占位词,表格改念表头;逐句朗读的修复还在
main上,没进 v0.21.5。
这一批属于 v0.21.5 那个“没有发布说明”的补丁窗口,完整清单见站内的 v0.21.5 发版页 和 v0.21.5 窗口自查指南。