Dos segundos de silencio cada vez que dices la palabra de activación: las voces locales dejan de recargarse
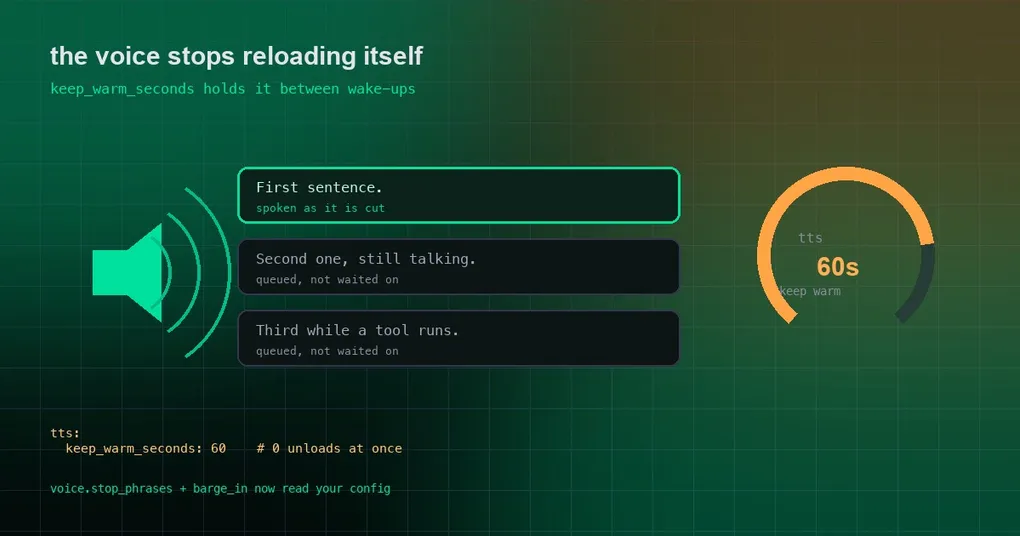
Dices «oye, ¿qué tengo hoy en el calendario?» al micrófono y esperas. Un segundo, dos, y al tercero empieza a hablar: te ha oído, simplemente estaba cargando el modelo de voz en memoria. Lo que desespera es que esto pasa en absolutamente cada activación. Ni siquiera puedes llamarlo «lento para arrancar», porque no está arrancando: está arrancando de nuevo.
Los motores TTS locales —Piper, KittenTTS, cualquiera que corra en tu propia máquina— cargan de forma perezosa para ahorrar memoria. Ese diseño está bien. El problema es el momento en que se descargan. Una clave de configuración nueva en la v0.21.5 lo arregla, y la misma tanda hace por fin que el bucle de voz del escritorio lea tu configuración. Aquí están todos los interruptores.
1. El problema no es una carga lenta, es una descarga precipitada
La lógica original: activar «leer las respuestas en voz alta» o iniciar una conversación de voz toma un lease sobre el motor, y desactivarlo lo libera. Cuando se libera el último lease y el contador de titulares llega a cero, el modelo se descarga de inmediato.
Una conversación con palabra de activación es así: dices la palabra de activación, entra en una conversación de voz —eso cuesta más de un segundo de calentamiento (una voz de Piper son decenas de MB y KittenTTS hasta unos 80 MB)—, dices una frase, la conversación termina, se libera el lease. El modelo se desaloja por tanto milisegundos después de terminar de cargarse. La siguiente activación vuelve a pagarlo todo.
Hay una variante peor: cuando una liberación cae durante una carga (los interruptores de CLI/TUI ejecutan acquire y release en hilos distintos), la descarga se encuentra una caché vacía, así que el modelo se queda residente sin ningún titular: ocupa memoria y no lo reutiliza nadie.
2. tts.keep_warm_seconds: la descarga espera un momento
La clave nueva es tts.keep_warm_seconds, por defecto 60:
tts:
  keep_warm_seconds: 60    # mantiene un motor local cargado este tiempo tras el último apagado (0 = descargar de inmediato)
La semántica es exactamente la que parece: tras la última liberación, la descarga se programa en un temporizador cancelable por ese tiempo. Cualquier acquire dentro de la ventana cancela la descarga pendiente y reutiliza el modelo ya cargado. Tres detalles que conviene conocer:
- El valor se lee en cada llamada, así que se aplica el
config.yamlde cada profile en lugar de un único valor global. - Un contador de generación convierte en no-op un temporizador que ya se ha despertado, así que «el temporizador saltó pero alguien volvió a hacer acquire en medio» no puede descargar un modelo que está en uso.
- Un calentamiento que termina sin titulares reinicia la ventana, así que calentar y apagar de inmediato te sigue dando los 60 segundos completos.
El valor por defecto vive en hermes_cli/config_defaults.py, y el comportamiento está documentado en la sección de leases de website/docs/user-guide/features/tts.md y en el bloque de TTS de configuration.md. Para ver qué reporta tu instalación:
hermes config get tts.keep_warm_seconds    # 60
hermes config set tts.keep_warm_seconds 0  # vuelve a la descarga inmediata si la memoria importa más
Poner 0 es la válvula de escape para máquinas con poca memoria a las que no importa la recarga. Si usas mucho la voz, súbelo en cambio: el coste es que unas decenas de MB se quedan residentes un rato.
3. Los leases abarcan varias superficies, y eso evita que se pisen entre sí
Esta parte del diseño es fácil de pasar por alto y resulta de verdad útil: cada interruptor mantiene un lease, y el modelo solo se descarga cuando se libera el último lease de todas las superficies. Por eso, desactivar la lectura en voz alta en una ventana del escritorio nunca le retira el motor a una conversación de voz que corre en otra.
El mismo mecanismo de lease llega a los providers declarados por el usuario: un provider de tipo comando ejecuta sus opcionales warm_command / release_command, y un provider de plugin en Python recibe warm() / release(). Tu propio servidor TTS autoalojado puede precargar y descargar con los interruptores, en lugar de que te inventes un hook. El escritorio llama a POST /api/audio/tts-lease con {"lease": "<name>", "active": true} o false, y otros frontends pueden usar el mismo endpoint.
Un extra pequeño que vale la pena ajustar: tts.streaming.min_len (por defecto 20) es la frase inicial más corta que se pronuncia sola; las aperturas más breves se van con la frase siguiente. Veinte va bien para inglés; las configuraciones de voz CJK suelen usar alrededor de 6.
4. La parada hablada del escritorio ahora lee tu configuración
Síntoma: el aviso te dice que digas «отбой» para terminar la conversación de voz, lo dices, y la palabra se envía al agent como prompt.
Causa: el comparador de parada isVoiceStopCommand() usaba una lista fija en inglés, mientras que el aviso que ves viene de voice.stop_phrases. Un usuario ruso que siguiera la instrucción en pantalla no tenía ninguna posibilidad.
Arreglo (PR #120751): el comparador ahora lee las mismas voice.stop_phrases que anuncia el aviso, manteniendo la semántica del backend (tools/voice_mode_transcript.is_voice_stop_phrase):
voice:
stop_phrases: ["stop"] # la locución completa debe ser igual a una de estas; [] desactiva la parada hablada- la locución completa tiene que ser igual a una frase (sin distinguir mayúsculas, ignorando la puntuación), no basta con que la contenga;
- una cadena suelta cuenta como una frase;
[]desactiva la parada hablada;- un valor mal formado cae al valor por defecto.
Hay un detalle de compatibilidad que conviene señalar: /api/config fusiona DEFAULT_CONFIG, así que una instalación por defecto siempre reporta stop_phrases: ["stop"]. Una implementación que simplemente usara lo que cargase haría que todos los usuarios del escritorio perdieran las frases inglesas extra —goodbye, never mind, cancel—, así que esta compara la lista cargada con /api/config/defaults para evitar esa regresión.
5. La reproducción con barge-in usa tu umbral
Síntoma: estás con unos auriculares Bluetooth, hablas por encima de la respuesta para interrumpirla, y no pasa nada.
Causa: el nivel de disparo de la reproducción estaba fijado como PLAYBACK_MIN_TRIGGER_LEVEL = 0.14, que queda por encima del nivel de voz de unos auriculares Bluetooth HFP mientras se reproduce una respuesta, así que tu voz nunca cruzaba la línea.
Arreglo (PR #120751): ahora usa el valor existente voice.barge_in_threshold_multiplier (por defecto 3.0), el mando que el listener full-duplex de la CLI/TUI siempre ha leído. Ningún ajuste nuevo y ninguna variable de entorno. Los comentarios de la configuración describen el modelo: el suelo de sala silenciosa se calibra antes de la reproducción, y el disparador de habla es ese suelo multiplicado por este factor.
6. Leer en voz alta deja de pronunciar marcadores, y las tablas leen su cabecera
Síntoma: con una voz que no es inglesa (una voz china de MiniMax en el reporte), un bloque de código se leía en voz alta como las palabras inglesas «code block omitted», una URL como «link», y una tabla Markdown desaparecía sin que se pronunciara nada en su lugar.
Arreglo (PR #120752):
- Los bloques de código y las URL se quedan en silencio: ninguna palabra de relleno en ningún idioma, y el código sigue visible en pantalla;
- Los tokens de enlace a archivos
MEDIA:nunca llegan a la voz (ni el saneador del escritorio ni el normalizador del backendtools/tts_text_normalize.py, que respalda el gateway, la voz de la CLI y los relés WS/POST del escritorio); la puntuación que va justo después de un token inline se conserva, así que «see MEDIA:/x.py. Then» mantiene su punto; - Los dos puntos al final de línea se cierran: cuando se elimina un bloque de código que seguía a «here is the list:», los dos puntos que quedaban colgando pasan a ser un punto; en el backend, unos dos puntos precedidos de dígito (
3:2) se dejan tal cual; - Las tablas leen su fila de cabecera: dice «Item, Value, Notes.» y se salta las filas del cuerpo. Quien escucha se entera de que hay una tabla en pantalla y de qué compara, sin oírla celda a celda. Una tabla cuyas celdas de cabecera estén todas vacías se queda en silencio.
7. La reproducción frase a frase sigue solo en main
Un arreglo muy relacionado no está en la v0.21.5, y merece una nota propia porque ataca los segundos de silencio al principio de una respuesta larga.
Con Edge (o cualquier TTS que no sea en streaming), el modo de voz del escritorio esperaba a la respuesta entera y la sintetizaba de una vez, así que una respuesta larga empezaba con segundos de silencio. La documentación promete streaming por frases, pero el arreglo anterior solo cubría a los providers en streaming; el fallback síncrono (awaitFallbackSpeech) seguía esperando a la respuesta completa. Esa ruta ahora mantiene una cola de frases y reproduce cada frase terminada a medida que se corta (PR #121685, incidencia #79314), y una burbuja provisional sellada (message.interim) se vacía en cada tick de sondeo, así que su última frase se pronuncia mientras corre una herramienta en lugar de después de que termine.
Ese PR se fusionó en main la tarde del 24 de septiembre de 2026 (alrededor de las 17:12 UTC), después de que la v0.21.5 se publicara a las 10:09 UTC de esa mañana, así que por ahora está solo en main.
8. Los atajos de voz con teclas de función se pueden reasignar (este sí está en la v0.21.5)
El dictado puntual pasó a ser una acción de teclado composer.dictate sin asignar, separada de la conversación de voz, que reutiliza la ruta de captura ya existente del escritorio para teclas F, Bloq Mayús, Suprimir, Espacio y combinaciones con modificadores. El campo obsoleto voice.record_key del escritorio se eliminó, con la nota de que esa configuración sigue siendo solo para CLI/TUI. El arbitraje de Electron hace que una F12 asignada llegue al renderer mientras que una F12 sin asignar conserva el comportamiento de DevTools (PR #120928).
En la misma ventana se arreglaron los flujos con teclas de función en macOS: el parser de la TUI mantiene intactas las secuencias de terminal F1–F12 (incluidas las rutas del protocolo de teclas modificadas), y el dock de trabajo en vivo ganó Ctrl+R como alternativa portátil a F7 tanto en la TUI como en la CLI clásica (PR #120666).
Estado del release de un vistazo
| Capacidad | PR | Estado |
|---|---|---|
Retención de calentamiento de tts.keep_warm_seconds |
#121080 | en la v0.21.5 |
La parada hablada lee voice.stop_phrases |
#120751 | en la v0.21.5 |
El barge-in usa voice.barge_in_threshold_multiplier |
#120751 | en la v0.21.5 |
| Leer en voz alta: sin marcadores, las tablas leen su cabecera | #120752 | en la v0.21.5 |
| Dictado reasignable con teclas de función | #120928 | en la v0.21.5 |
F1–F12 en macOS y la alternativa Ctrl+R |
#120666 | en la v0.21.5 |
| Reproducción frase a frase con TTS de Edge/síncrono | #121685 | solo en main |
Qué comprobar en tu propia instalación
hermes config get tts.keep_warm_seconds                 # 60
hermes config get voice.stop_phrases                    # - stop
hermes config get voice.barge_in_threshold_multiplier   # 3.0
Después haz la prueba de verdad: di la palabra de activación, pronuncia una frase, termina la conversación, espera unos segundos y actívalo otra vez: la segunda respuesta debería ser bastante más rápida, porque el modelo sigue en memoria.
La versión corta
- El problema de la voz local es que descarga demasiado pronto, no que cargue despacio: una conversación que solo usa la palabra de activación libera su lease milisegundos después de terminar el calentamiento.
tts.keep_warm_seconds(por defecto 60) hace que la descarga espere, y un nuevo acquire dentro de la ventana la cancela;0recupera la descarga inmediata.- La parada hablada y el umbral de barge-in ahora leen tu configuración en lugar de una lista fija en inglés y un nivel fijo.
- Leer en voz alta ya no pronuncia marcadores y las tablas leen su fila de cabecera; la reproducción frase a frase sigue en
main, no en la v0.21.5.
Esta tanda pertenece a la v0.21.5, esa ventana de patch sin notas de versión; la lista más completa está en nuestra página del release v0.21.5 y en la guía de autocomprobación de la ventana v0.21.5.