Zwei Sekunden Stille bei jedem Wake-Word — lokale Stimmen laden jetzt nicht mehr neu
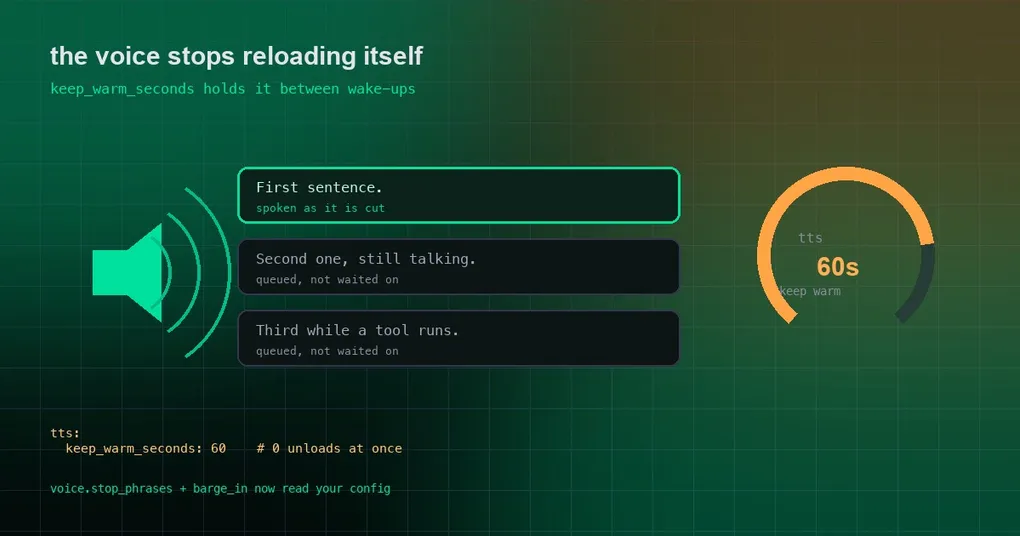
Sie sagen „hey, what’s on my calendar today“ ins Mikrofon und warten dann. Eine Sekunde, zwei, und in der dritten fängt es an zu sprechen — es hat Sie gehört, es lud nur gerade das Stimmmodell in den Speicher. Verrückt macht daran, dass es bei jedem einzelnen Aufwachen passiert. Sie können es nicht einmal „langsam beim Start“ nennen, denn es startet nicht — es startet von vorn.
Lokale TTS-Engines — Piper, KittenTTS, alles, was auf Ihrer eigenen Maschine läuft — laden lazy, um Speicher zu sparen. Dieses Design ist in Ordnung. Das Problem ist der Zeitpunkt des Entladens. Ein neuer Config-Key in v0.21.5 behebt es, und derselbe Batch lässt die Desktop-Voiceschleife endlich Ihre Konfiguration lesen. Hier kommt jeder Schalter.
1. Das Problem ist nicht langsames Laden, sondern eifriges Entladen
Die ursprüngliche Logik: „Antworten vorlesen“ einzuschalten oder eine Sprachunterhaltung zu starten nimmt ein Lease auf die Engine, das Ausschalten gibt es frei. Wenn das letzte Lease freigegeben wird und der Holder-Count auf null fällt, wird das Modell sofort entladen.
Eine Wake-Word-Unterhaltung sieht so aus: Sie sagen das Wake-Word, es beginnt eine Sprachunterhaltung — das kostet gut eine Sekunde Warm-up (eine Piper-Stimme sind zig MB, KittenTTS bis zu rund 80 MB) —, Sie sagen einen Satz, die Unterhaltung endet, das Lease wird freigegeben. Das Modell wird also Millisekunden, nachdem es fertig geladen war, verworfen. Das nächste Aufwachen bezahlt alles erneut.
Es gibt eine unangenehmere Variante: Wenn eine Freigabe während eines Ladevorgangs eintrifft (die CLI/TUI-Toggles führen Acquire und Release in getrennten Threads aus), findet das Entladen einen leeren Cache, das Modell bleibt also ganz ohne Holder resident — es belegt Speicher und wird von niemandem genutzt.
2. tts.keep_warm_seconds: Das Entladen wartet einen Moment
Der neue Key ist tts.keep_warm_seconds, Standard 60:
tts:
  keep_warm_seconds: 60    # hält eine lokale Engine so lange nach dem letzten Ausschalten geladen (0 = sofort entladen)
Die Semantik ist genau das, wonach sie klingt: Nach der letzten Freigabe wird das Entladen für diese Dauer auf einem abbrechbaren Timer geplant. Jedes Acquire innerhalb des Fensters bricht das ausstehende Entladen ab und nutzt das geladene Modell weiter. Drei Details sind wichtig:
- Der Wert wird pro Aufruf gelesen, es gilt also die jeweilige
config.yamljedes Profils statt eines globalen Werts. - Ein Generation-Counter macht einen Timer, der bereits aufgewacht ist, zum No-op, sodass „der Timer hat gefeuert, aber jemand hat zwischendurch neu angefordert“ kein Modell entladen kann, das in Benutzung ist.
- Ein Warm-up, das ohne Holder endet, startet das Fenster neu — wer also aufwärmt und sofort wieder ausschaltet, bekommt trotzdem die vollen 60 Sekunden.
Der Standardwert steht in hermes_cli/config_defaults.py, und das Verhalten ist im Lease-Abschnitt von website/docs/user-guide/features/tts.md und im TTS-Block von configuration.md dokumentiert. So prüfen Sie, was Ihre Installation meldet:
hermes config get tts.keep_warm_seconds    # 60
hermes config set tts.keep_warm_seconds 0  # back to "unload immediately" if memory matters more
0 zu setzen ist der Notausgang für speicherknappe Maschinen, denen der Reload nichts ausmacht. Nutzen Sie Sprache intensiv, erhöhen Sie den Wert stattdessen — der Preis ist, dass zig MB eine Weile resident bleiben.
3. Leases spannen über Oberflächen, was verhindert, dass sie sich gegenseitig stören
Dieser Teil des Designs ist leicht zu übersehen und wirklich nützlich: Jeder Toggle hält ein Lease, und das Modell wird erst entladen, wenn das letzte Lease über alle Oberflächen hinweg freigegeben ist. Vorlesen in einem Desktop-Fenster auszuschalten zieht die Engine also nie einer Sprachunterhaltung in einem anderen Fenster unter den Füßen weg.
Derselbe Lease-Mechanismus erreicht nutzerdeklarierte Provider: Ein Provider vom Typ Command führt sein optionales warm_command / release_command aus, und ein Python-Plugin-Provider bekommt warm() / release(). Ihr selbst gehosteter TTS-Server kann bei den Toggles vorladen und entladen, statt dass Sie einen Hook erfinden. Desktop ruft POST /api/audio/tts-lease mit {"lease": "<name>", "active": true} oder false auf, und andere Frontends können denselben Endpunkt nutzen.
Eine kleine zusätzliche Einstellung lohnt sich: tts.streaming.min_len (Standard 20) ist der kürzeste erste Satz, der allein gesprochen wird — kürzere Einstiege gehen mit dem nächsten Satz mit. Zwanzig passt für Englisch; CJK-Sprach-Setups nutzen in der Regel etwa 6.
4. Spoken Stop auf dem Desktop liest jetzt Ihre Konfiguration
Symptom: Der Hinweis sagt Ihnen, Sie sollen „отбой“ sagen, um die Sprachunterhaltung zu beenden, Sie sagen es — und das Wort wird stattdessen als Prompt an den Agenten geschickt.
Ursache: Der Stop-Matcher isVoiceStopCommand() verglich eine hartcodierte englische Liste, während der Ihnen angezeigte Hinweis aus voice.stop_phrases kommt. Ein russischer Nutzer, der der Anweisung auf dem Bildschirm folgte, hatte keine Chance.
Fix (PR #120751): Der Matcher liest jetzt dieselben voice.stop_phrases, die der Hinweis anzeigt, und behält die Semantik des Backends bei (tools/voice_mode_transcript.is_voice_stop_phrase):
voice:
stop_phrases: ["stop"] # the whole utterance must equal one of these; [] disables spoken stop- die gesamte Äußerung muss einer Phrase entsprechen (Groß-/Kleinschreibung ignoriert, Interpunktion ignoriert), es reicht nicht, sie nur zu enthalten;
- ein einfacher String zählt als eine Phrase;
[]deaktiviert Spoken Stop;- ein fehlerhafter Wert fällt auf den Standard zurück.
Ein Kompatibilitätsdetail ist erwähnenswert: /api/config merged DEFAULT_CONFIG, eine Standardinstallation meldet also immer stop_phrases: ["stop"]. Eine Implementierung, die einfach nähme, was sie geladen hat, würde jedem Desktop-Nutzer die zusätzlichen englischen Phrasen nehmen — goodbye, never mind, cancel —, deshalb vergleicht diese Variante die geladene Liste gegen /api/config/defaults, um diese Regression zu vermeiden.
5. Barge-in-Wiedergabe nutzt Ihren Schwellenwert
Symptom: Sie sind an einem Bluetooth-Headset, reden über die Antwort hinweg, um sie zu unterbrechen — und nichts passiert.
Ursache: Der Auslösepegel der Wiedergabe war hartcodiert als PLAYBACK_MIN_TRIGGER_LEVEL = 0.14, was über dem Sprachpegel eines Bluetooth-HFP-Headsets liegt, während eine Antwort abgespielt wird, Ihre Stimme überschritt die Linie also nie.
Fix (PR #120751): Es nutzt jetzt den vorhandenen voice.barge_in_threshold_multiplier (Standard 3.0) — den Regler, den der Full-Duplex-Listener von CLI/TUI schon immer gelesen hat. Keine neue Einstellung und keine Umgebungsvariable. Die Kommentare in der Konfiguration beschreiben das Modell: Der Boden im ruhigen Raum wird vor der Wiedergabe kalibriert, und der Sprachauslöser ist dieser Boden mal diesem Multiplikator.
6. Read Aloud spricht keine Platzhalter mehr, und Tabellen sprechen ihre Kopfzeile
Symptom: Mit einer nicht-englischen Stimme (im Bericht eine chinesische MiniMax-Stimme) wurde ein Codeblock als englische Worte „code block omitted“ vorgelesen, eine URL als „link“, und eine Markdown-Tabelle verschwand, ohne dass an ihrer Stelle etwas gesprochen wurde.
Fix (PR #120752):
- Codeblöcke und URLs sind stumm — kein Platzhalterwort in irgendeiner Sprache, und der Code bleibt auf dem Bildschirm sichtbar;
MEDIA:-Dateilink-Tokens erreichen die Stimme nie (sowohl der Desktop-Sanitizer als auch der Backend-Normalizertools/tts_text_normalize.py, der das Gateway, die CLI-Sprachfunktion und die WS/POST-Relays des Desktops stützt); Interpunktion direkt nach einem Inline-Token bleibt erhalten, „see MEDIA:/x.py. Then“ behält also seinen Schlusspunkt;- Zeilenfinale Doppelpunkte schließen ab: Wenn ein Codeblock nach „here is the list:“ entfernt wird, wird der hängende Doppelpunkt zum Punkt; ein Doppelpunkt nach einer Ziffer (
3:2) bleibt im Backend unangetastet; - Tabellen sprechen ihre Kopfzeile — es heißt „Item, Value, Notes.“, und die Body-Zeilen werden übersprungen. Die Zuhörerin erfährt, dass eine Tabelle auf dem Bildschirm ist und was sie vergleicht, ohne sie Zelle für Zelle zu hören. Eine Tabelle, deren Kopfzellen alle leer sind, bleibt stumm.
7. Satzweise Wiedergabe ist weiterhin nur auf main
Ein eng verwandter Fix ist nicht in v0.21.5, und er verdient eine eigene Notiz, weil er die stillen Anfangssekunden einer langen Antwort adressiert.
Mit Edge (oder jedem nicht streamenden TTS) wartete der Desktop-Sprachmodus früher die gesamte Antwort ab und synthetisierte sie in einem Zug, eine lange Antwort begann also mit Sekunden der Stille. Die Dokumentation verspricht Satz-Streaming, der frühere Fix deckte jedoch nur streamende Provider ab; der Sync-Fallback (awaitFallbackSpeech) wartete weiterhin auf die vollständige Antwort. Dieser Pfad hält jetzt eine Satzwarteschlange und spielt jeden abgeschlossenen Satz ab, sobald er geschnitten ist (PR #121685, Issue #79314), und eine versiegelte Interim-Bubble (message.interim) wird bei jedem Poll-Tick geleert, ihr letzter Satz wird also gesprochen, während ein Tool läuft, statt danach.
Dieser PR wurde am Nachmittag des 24. September 2026 (gegen 17:12 UTC) in main gemergt, nachdem v0.21.5 an diesem Morgen um 10:09 UTC veröffentlicht wurde — er ist also vorerst nur auf main.
8. Funktionstasten-Voice-Shortcuts sind neu belegbar (dieser ist in v0.21.5)
Die einmalige Diktion wurde eine nicht belegte Tastaturaktion composer.dictate, getrennt von der Sprachunterhaltung, die den bestehenden Capture-Pfad von Desktop für F-Tasten, Caps Lock, Delete, Space und Modifier-Kombinationen weiterverwendet. Das veraltete Desktop-Feld voice.record_key wurde entfernt, mit dem Hinweis, dass die Konfiguration CLI/TUI-only bleibt. Die Electron-Arbitrierung sorgt dafür, dass ein zugewiesenes F12 den Renderer erreicht, während ein nicht zugewiesenes F12 das DevTools-Verhalten behält (PR #120928).
Im selben Fenster wurden Funktionstasten-Workflows unter macOS repariert: Der TUI-Parser hält F1–F12-Terminalsequenzen intakt (einschließlich der Protokollpfade für modifizierte Tasten), und das Live-Work-Dock bekam Ctrl+R als portablen F7-Fallback über TUI und klassisches CLI hinweg (PR #120666).
Release-Status auf einen Blick
| Fähigkeit | PR | Status |
|---|---|---|
tts.keep_warm_seconds als Haltezeit für Warm-up |
#121080 | in v0.21.5 |
Spoken Stop liest voice.stop_phrases |
#120751 | in v0.21.5 |
Barge-in nutzt voice.barge_in_threshold_multiplier |
#120751 | in v0.21.5 |
| Read Aloud: keine Platzhalter, Tabellen lesen ihre Kopfzeile | #120752 | in v0.21.5 |
| Neu belegbare Funktionstasten-Diktion | #120928 | in v0.21.5 |
macOS F1–F12 und der Ctrl+R-Fallback |
#120666 | in v0.21.5 |
| Satzweise Wiedergabe bei Edge/Sync-TTS | #121685 | nur main |
Was Sie in Ihrem eigenen Install prüfen sollten
hermes config get tts.keep_warm_seconds                 # 60
hermes config get voice.stop_phrases                    # - stop
hermes config get voice.barge_in_threshold_multiplier   # 3.0
Und dann der echte Test: Sagen Sie das Wake-Word, sprechen Sie einen Satz, beenden Sie die Unterhaltung, warten Sie ein paar Sekunden und wecken Sie es erneut — die zweite Antwort sollte spürbar schneller sein, weil das Modell noch im Speicher ist.
Die Kurzfassung
- Der Schmerz bei lokaler Sprache ist zu frühes Entladen, nicht langsames Laden: Eine reine Wake-Word-Unterhaltung gibt ihr Lease Millisekunden nach dem Ende des Warm-ups frei.
tts.keep_warm_seconds(Standard 60) lässt das Entladen warten, und ein erneutes Acquire im Fenster bricht es ab;0stellt das sofortige Entladen wieder her.- Spoken Stop und die Barge-in-Schwelle lesen jetzt Ihre Konfiguration statt einer hartcodierten englischen Liste und eines hartcodierten Pegels.
- Read Aloud spricht keine Platzhalter mehr, und Tabellen lesen ihre Kopfzeile; die satzweise Wiedergabe liegt weiterhin auf
mainund nicht in v0.21.5.
Dieser Batch gehört zu v0.21.5, jenem Patch-Fenster ohne Release Notes — die vollständigere Liste steht auf unserer Release-Seite zu v0.21.5 und im Selbstcheck-Leitfaden zum v0.21.5-Fenster.