Deux secondes de silence à chaque fois que vous prononcez le mot de réveil — les voix locales ne se rechargent plus
Vous dites « hey, what’s on my calendar today » dans le micro et puis vous attendez. Une seconde, deux, et à la troisième il se met à parler — il vous a entendu, il chargeait simplement le modèle vocal en mémoire. Le plus exaspérant, c’est que cela se produit à chaque réveil. Vous ne pouvez même pas appeler ça « lent à démarrer », parce qu’il ne démarre pas : il redémarre.
Les moteurs TTS locaux — Piper, KittenTTS, tout ce qui tourne sur votre propre machine — se chargent paresseusement pour économiser de la mémoire. Ce design est très bien. Le problème, c’est le moment du déchargement. Une nouvelle clé de config dans v0.21.5 règle ça, et le même lot fait enfin lire votre configuration à la boucle vocale du desktop. Voici tous les interrupteurs.
1. Le problème n’est pas un chargement lent, c’est un déchargement trop empressé
La logique d’origine : activer « lire les réponses à voix haute » ou démarrer une conversation vocale prend un lease sur le moteur, et le désactiver le libère. Quand le dernier lease est libéré et que le compteur de détenteurs tombe à zéro, le modèle est déchargé immédiatement.
Une conversation à mot de réveil ressemble à ceci : vous dites le mot de réveil, il entre en conversation vocale — cela coûte une seconde et plus de préchauffage (une voix Piper fait des dizaines de Mo, KittenTTS jusqu’à environ 80 Mo) — vous dites une phrase, la conversation se termine, le lease est libéré. Le modèle est donc évincé quelques millisecondes après avoir fini de charger. Le réveil suivant paie à nouveau toute l’opération.
Il existe une variante plus vicieuse : quand une libération arrive pendant un chargement (les bascules du CLI/TUI exécutent acquire et release sur des threads séparés), le déchargement trouve un cache vide, donc le modèle reste résident sans le moindre détenteur — il occupe de la mémoire et personne ne le réutilise.
2. tts.keep_warm_seconds : le déchargement attend un moment
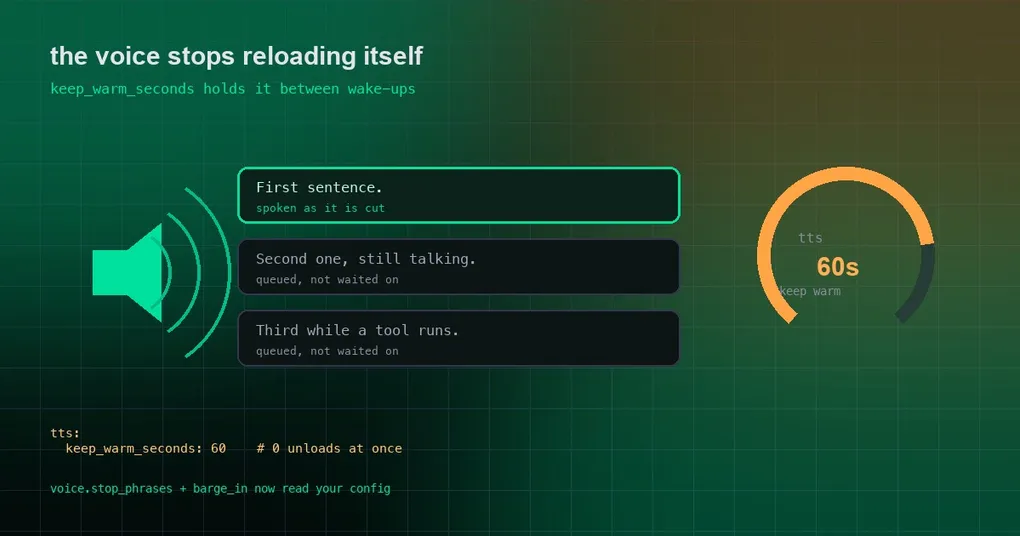
La nouvelle clé est tts.keep_warm_seconds, défaut 60 :
tts:
  keep_warm_seconds: 60    # garder un moteur local chargé aussi longtemps après la dernière bascule off (0 = décharger aussitôt)
La sémantique est exactement ce qu’elle donne à penser : après la dernière libération, le déchargement est programmé sur un minuteur annulable pour cette durée. Tout acquire dans la fenêtre annule le déchargement en attente et réutilise le modèle chargé. Trois détails valent la peine d’être connus :
- La valeur est lue à chaque appel, donc le
config.yamlde chaque profile s’applique au lieu d’une valeur globale unique. - Un compteur de génération rend inopérant un minuteur déjà réveillé, donc « le minuteur s’est déclenché mais quelqu’un a ré-acquis entre-temps » ne peut pas décharger un modèle en cours d’utilisation.
- Un préchauffage qui se termine sans détenteur redémarre la fenêtre — donc préchauffer puis couper immédiatement vous donne quand même les 60 secondes complètes.
La valeur par défaut vit dans hermes_cli/config_defaults.py, et le comportement est documenté dans la section lease de website/docs/user-guide/features/tts.md et dans le bloc TTS de configuration.md. Pour voir ce que votre installation rapporte :
hermes config get tts.keep_warm_seconds    # 60
hermes config set tts.keep_warm_seconds 0  # revenir à « décharger immédiatement » si la mémoire compte plus
Régler 0 est la soupape d’échappement pour les machines à mémoire contrainte que le rechargement ne dérange pas. Si votre usage vocal est intensif, augmentez-la plutôt — le prix est que des dizaines de Mo restent résidents un moment.
3. Les leases couvrent toutes les surfaces, ce qui les empêche de se marcher dessus
Cette partie du design est facile à manquer et réellement utile : chaque bascule détient un lease, et le modèle ne se décharge que lorsque le dernier lease de toutes les surfaces est libéré. Désactiver la lecture à voix haute dans une fenêtre Desktop ne retire donc jamais le moteur sous une conversation vocale qui tourne dans une autre.
Le même mécanisme de lease atteint les providers déclarés par l’utilisateur : un provider de type commande exécute ses warm_command / release_command optionnels, et un provider plugin Python reçoit warm() / release(). Votre propre serveur TTS auto-hébergé peut ainsi précharger et décharger sur les bascules, au lieu que vous inventiez un hook. Desktop appelle POST /api/audio/tts-lease avec {"lease": "<name>", "active": true} ou false, et les autres frontends peuvent utiliser le même endpoint.
Un petit réglage supplémentaire qui vaut la peine : tts.streaming.min_len (défaut 20) est la longueur minimale de la première phrase prononcée seule — les ouvertures plus courtes partent avec la phrase suivante. Vingt convient à l’anglais ; les configurations vocales CJK utilisent généralement autour de 6.
4. L’arrêt vocal du desktop lit désormais votre config
Symptôme : le message vous dit de dire « отбой » pour terminer la conversation vocale, vous le dites, et le mot est envoyé à l’agent comme prompt à la place.
Cause : le matcher d’arrêt isVoiceStopCommand() correspondait à une liste anglaise codée en dur, alors que le message affiché provient de voice.stop_phrases. Un utilisateur russophone suivant l’instruction à l’écran n’avait aucune chance.
Correctif (PR #120751) : le matcher lit désormais le même voice.stop_phrases que celui annoncé par le message, en conservant la sémantique du backend (tools/voice_mode_transcript.is_voice_stop_phrase) :
voice:
stop_phrases: ["stop"] # l'énoncé entier doit être égal à l'une de ces phrases ; [] désactive l'arrêt vocal- l’énoncé entier doit être égal à une phrase (insensible à la casse, ponctuation ignorée), pas simplement la contenir ;
- une chaîne nue compte comme une phrase ;
[]désactive l’arrêt vocal ;- une valeur mal formée retombe sur la valeur par défaut.
Un détail de compatibilité vaut la peine d’être signalé : /api/config fusionne DEFAULT_CONFIG, donc une installation par défaut rapporte toujours stop_phrases: ["stop"]. Une implémentation qui se contenterait d’utiliser ce qu’elle a chargé ferait perdre à chaque utilisateur desktop les phrases anglaises supplémentaires — goodbye, never mind, cancel — donc celle-ci compare la liste chargée à /api/config/defaults pour éviter cette régression.
5. La lecture de la barge-in utilise votre seuil
Symptôme : vous êtes sur un casque Bluetooth, vous parlez par-dessus la réponse pour l’interrompre — et rien ne se passe.
Cause : le niveau de déclenchement de la lecture était codé en dur à PLAYBACK_MIN_TRIGGER_LEVEL = 0.14, ce qui se situe au-dessus du niveau de parole d’un casque Bluetooth HFP pendant qu’une réponse est jouée, donc votre voix ne franchissait jamais la ligne.
Correctif (PR #120751) : il utilise désormais le voice.barge_in_threshold_multiplier existant (défaut 3.0) — le bouton que l’écouteur full-duplex du CLI/TUI a toujours lu. Aucun nouveau réglage et aucune variable d’environnement. Les commentaires de la config décrivent le modèle : le plancher de salle calme est calibré avant la lecture, et le déclencheur de parole est ce plancher multiplié par ce coefficient.
6. Read Aloud arrête de prononcer des textes de remplacement, et les tableaux prononcent leur en-tête
Symptôme : avec une voix non anglaise (une voix MiniMax chinoise dans le rapport), un bloc de code était lu à voix haute comme les mots anglais « code block omitted », une URL comme « link », et un tableau Markdown disparaissait sans que rien ne soit prononcé à sa place.
Correctif (PR #120752) :
- Les blocs de code et les URL sont muets — aucun mot de remplacement dans aucune langue, et le code reste visible à l’écran ;
- Les tokens de lien de fichier
MEDIA:n’atteignent jamais la voix (aussi bien le sanitiser du desktop que le normaliseur du backendtools/tts_text_normalize.py, qui sert le gateway, la voix du CLI et les relais WS/POST du desktop) ; la ponctuation qui suit immédiatement un token en ligne est conservée, donc « see MEDIA:/x.py. Then » garde son point ; - Les deux-points en fin de ligne se ferment : quand un bloc de code suivant « here is the list: » est retiré, le deux-points en suspens devient un point ; un deux-points précédé d’un chiffre (
3:2) est laissé intact côté backend ; - Les tableaux prononcent leur ligne d’en-tête — il dit « Item, Value, Notes. » et saute les lignes du corps. L’auditeur apprend qu’un tableau est à l’écran et ce qu’il compare, sans l’entendre cellule par cellule. Un tableau dont toutes les cellules d’en-tête sont vides reste muet.
7. La lecture phrase par phrase reste sur main uniquement
Un correctif étroitement lié n’est pas dans v0.21.5, et il mérite sa propre note parce qu’il s’attaque aux secondes de silence qui ouvrent une longue réponse.
Avec Edge (ou tout TTS non-streaming), le mode vocal du desktop attendait auparavant la réponse entière et la synthétisait d’un seul coup, donc une longue réponse commençait par des secondes de silence. La doc promet le streaming phrase par phrase, mais le correctif antérieur ne couvrait que les providers en streaming ; le repli synchrone (awaitFallbackSpeech) attendait toujours la réponse complète. Ce chemin conserve désormais une file de phrases et joue chaque phrase terminée à mesure qu’elle est découpée (PR #121685, issue #79314), et une bulle intermédiaire scellée (message.interim) est vidée à chaque tick de poll, donc sa dernière phrase est prononcée pendant qu’un outil tourne au lieu d’après.
Cette PR a été fusionnée dans main l’après-midi du 24 septembre 2026 (vers 17:12 UTC), après la publication de v0.21.5 à 10:09 UTC ce matin-là — elle est donc sur main uniquement pour l’instant.
8. Les raccourcis vocaux par touches de fonction sont réassignables (celui-ci est dans v0.21.5)
La dictée ponctuelle est devenue une action clavier composer.dictate non liée, distincte de la conversation vocale, réutilisant le chemin de capture existant de Desktop pour les F-keys, Caps Lock, Delete, Space et les combinaisons de modificateurs. L’ancien champ voice.record_key de Desktop a été supprimé, avec une note indiquant que la config reste réservée au CLI/TUI. L’arbitrage Electron fait qu’une F12 assignée atteint le renderer tandis qu’une F12 non assignée conserve le comportement DevTools (PR #120928).
Dans la même fenêtre, les workflows par touches de fonction sous macOS ont été corrigés : l’analyseur du TUI préserve intacts les séquences de terminal F1–F12 (y compris les chemins du protocole modified-key), et le dock de travail en direct a gagné Ctrl+R comme repli portable de F7 sur le TUI et le CLI classique (PR #120666).
État de release en un coup d’œil
| Capacité | PR | Statut |
|---|---|---|
Maintien après préchauffage tts.keep_warm_seconds |
#121080 | dans v0.21.5 |
L’arrêt vocal lit voice.stop_phrases |
#120751 | dans v0.21.5 |
La barge-in utilise voice.barge_in_threshold_multiplier |
#120751 | dans v0.21.5 |
| Read Aloud : pas de textes de remplacement, les tableaux lisent leur en-tête | #120752 | dans v0.21.5 |
| Dictée réassignable par touches de fonction | #120928 | dans v0.21.5 |
macOS F1–F12 et le repli Ctrl+R |
#120666 | dans v0.21.5 |
| Lecture phrase par phrase du TTS Edge/sync | #121685 | main uniquement |
Ce qu’il faut vérifier sur votre installation
hermes config get tts.keep_warm_seconds                 # 60
hermes config get voice.stop_phrases                    # - stop
hermes config get voice.barge_in_threshold_multiplier   # 3.0
Faites ensuite le vrai test : dites le mot de réveil, prononcez une phrase, terminez la conversation, attendez quelques secondes et réveillez-le à nouveau — la seconde réponse devrait être nettement plus rapide, parce que le modèle est encore en mémoire.
En bref
- La douleur des voix locales est un déchargement trop précoce, pas un chargement lent : une conversation en wake-only libère son lease quelques millisecondes après la fin du préchauffage.
tts.keep_warm_seconds(défaut 60) fait attendre le déchargement, et un ré-acquire dans la fenêtre l’annule ;0rétablit le déchargement immédiat.- L’arrêt vocal et le seuil de barge-in lisent désormais votre config au lieu d’une liste anglaise codée en dur et d’un niveau codé en dur.
- Read Aloud ne prononce plus de textes de remplacement et les tableaux lisent leur ligne d’en-tête ; la lecture phrase par phrase est encore sur
main, pas dans v0.21.5.
Ce lot appartient à v0.21.5, cette fenêtre corrective sans release notes — la liste plus complète est sur notre page de release v0.21.5 et dans le guide d’auto-vérification de la fenêtre v0.21.5.