Un tour parlé n'a plus besoin du modèle avec lequel vous tapez
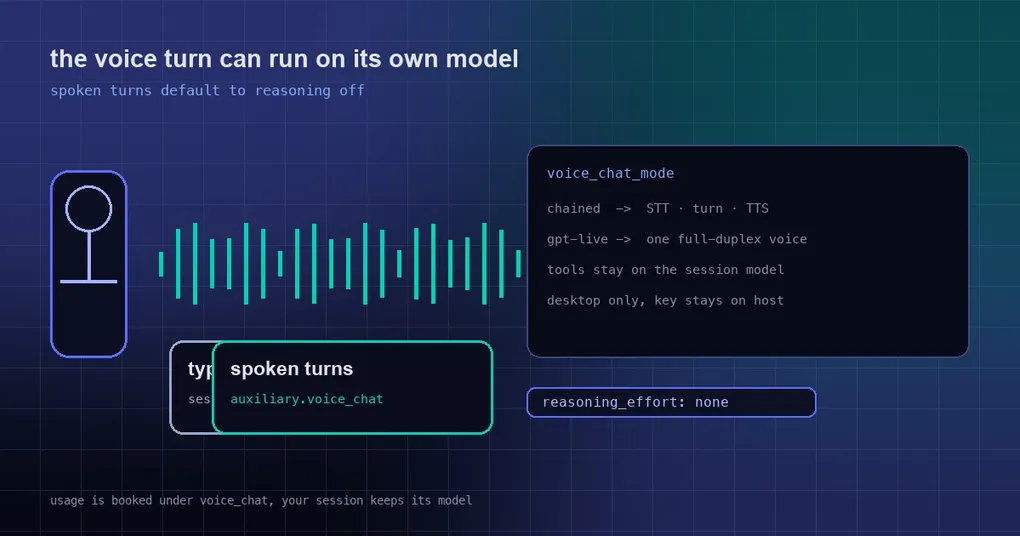
Vous parlez à Hermes Desktop avec le mode vocal activé, vous demandez l’heure, et la pause au milieu est assez longue pour vous faire vérifier le micro. Quand il parle enfin, le débit est naturel, mais vous entendez qu’il a réfléchi avant — parce que ce qui vous répond est le même modèle avec lequel vous tapez. Le problème n’est pas le pipeline audio. C’est que ce tour tourne sur le même cerveau : même modèle, même budget de réflexion, même prix. Deux gaspillages s’ensuivent, et vous n’en avez peut-être remarqué aucun : la voix est la seule surface qui doit être rapide, et elle exécutait un long raisonnement ; les demandes vocales sont généralement courtes, et elles étaient facturées à votre modèle principal. Hermes a maintenant séparé ces deux choses.
Les tours parlés ont leur propre slot de modèle
Le nouveau slot est auxiliary.voice_chat, et il fonctionne comme les autres modèles auxiliaires que vous connaissez déjà (vision, title_generation, compression) : il ne change que le modèle qui répond au tour parlé — tout le reste reste où il était. La valeur par défaut est auto, ce qui signifie le modèle de la session courante, donc ne rien faire conserve le comportement auquel vous êtes habitué.
Trois façons de le changer, qui écrivent toutes la même config :
auxiliary:
  voice_chat:
    provider: openrouter          # "auto" = le modèle propre à la session (défaut)
    model: google/gemini-3-flash-preview   # vide avec un provider = le modèle rapide de ce provider
reasoning_effort: none # défaut : raisonnement désactivé sur les tours vocaux (voir ci-dessous)- Desktop : Settings → Models → Auxiliary models ;
- CLI :
hermes model→ Auxiliary models, où la liste porte désormaisvoice_chatcommecurrently: auto / main model; - Ou écrivez-le directement dans
config.yaml, exactement comme ci-dessus.
Connaissez le rayon d’action : chaque tour qui est parlé — le mode vocal du CLI et du TUI, la conversation vocale du Desktop, et les notes vocales sur les plateformes de messagerie. Le tour vocal conserve toute la boîte à outils ; seul le modèle qui y répond change. Votre prochain message tapé revient au modèle de la session, tout comme les revues de mémoire et de skills qui suivent un tour. L’usage est enregistré sous la tâche voice_chat, donc un tour vocal ne réécrit jamais discrètement quel modèle est votre session.
Le raisonnement est désactivé par défaut — et il se souvient d’un refus
Le deuxième changement est plus direct : les tours vocaux passent par défaut en raisonnement désactivé (reasoning_effort: none), et cela s’applique même quand vous laissez le slot sur auto et que c’est le modèle de la session qui répond. La raison est simple : la valeur de la parole, c’est le temps de réponse ; une longue réflexion transforme une conversation en répondeur.
Il existe deux exceptions concrètes, gérées intelligemment :
- Le modèle refuse de désactiver le raisonnement (un modèle à réflexion obligatoire, ou une route dont le catalogue la marque comme obligatoire) → il reçoit son niveau accepté le plus bas au lieu d’une valeur qui serait rejetée ;
- Une route rejette la désactivation à l’exécution → le résultat est mémorisé, donc le tour vocal suivant ne se cogne pas au même mur.
Si vous voulez malgré tout un peu de réflexion à l’oral (par exemple pour résumer pendant l’écoute), fixez un niveau explicitement. Le mettre à la chaîne vide "" signifie « suivre ce qu’utilise la session ».
Un dernier détail discret : le modèle vocal ne force jamais une compaction. Si la conversation dépasse déjà la fenêtre de contexte de ce modèle généralement plus petit, ce tour tourne sur le modèle de la session à la place et vous recevez un avertissement unique — plutôt que la disparition silencieuse de la moitié de l’historique.
Pour aller plus loin : laisser un seul modèle vocal full-duplex tenir la boucle
Si la chaîne « transcrire → tour → parler » elle-même vous semble lente, il existe un second mode. Basculez le mode de chat vocal du Desktop sur gpt-live et toute la chaîne est remplacée par un seul modèle vocal full-duplex : il écoute pendant qu’il parle, gère lui-même les interruptions, les backchannels et le bruit de fond, et n’a aucun outil propre. Dès que vous demandez du vrai travail, il délègue à Hermes — le modèle de votre session, la boîte à outils complète, la mémoire et les approbations — puis vous redit la réponse à voix haute.
voice:
  voice_chat_mode: gpt-live     # chained (défaut) | gpt-live
  gpt_live:
    voice: marin                # marin, cedar, quartz, ripple, vesper, willow, stone, gleam, meridian, …
    instructions: ""            # phrases de persona supplémentaires facultatives (ton, rythme, langue)
Il nécessite une clé API OpenAI (OPENAI_API_KEY, VOICE_TOOLS_OPENAI_KEY, ou voice.gpt_live.api_key). Attention à la facturation : la couche vocale est facturée par OpenAI à 0,05 $ par minute de temps de session (le temps d’inactivité compte), tandis que le tour Hermes est facturé sur votre propre provider comme toujours. Si gpt-live est sélectionné mais qu’aucune clé ne se résout, le bouton retombe sur le mode chaîné avec un avertissement plutôt que d’échouer silencieusement.
Quelques limites valent la peine d’être connues d’avance : ce mode ne peut pas utiliser le proxy audio géré par Nous (clé directe uniquement), il est réservé au Desktop (/voice du CLI/TUI reste sur la boucle chaînée), et l’outil tts continue d’utiliser tts.provider. La clé n’atteint jamais le client non plus — le desktop reçoit un id de session et une réponse SDP, et l’hôte gateway crée la session (POST /api/audio/voice-live/session).
Les angles qui piègent
gpt-liveignoreauxiliary.voice_chat: sur ce chemin, la couche vocale est déjà le modèle rapide et le modèle de session fait le vrai travail, donc un modèle vocal séparé ne sert à rien.- Le réglage de la barge-in s’applique toujours en mode chaîné, et il vaut la peine d’être ajusté :
voice.barge_in(activé par défaut),voice.barge_in_threshold_multiplier(3.0 par défaut ; plus bas est plus sensible — essayez 1.5 sur un casque Bluetooth discret) etvoice.barge_in_grace_seconds(0.5). Quand ça se comporte mal,HERMES_VOICE_DEBUG=1envoie sur stderr les décisions VAD bloc par bloc (plancher calibré, RMS, déclenchement). - La vitesse a un coût : un modèle plus petit a plus de chances de répondre de façon superficielle. Le schéma sûr est un modèle rapide à l’oral, et tapez la question quand vous avez besoin de profondeur — ce chemin utilise toujours votre modèle d’origine, non dilué.
Pour conclure
auxiliary.voice_chatdonne au tour parlé son propre modèle ; la valeur par défaut estauto(le modèle de session).- Les tours vocaux passent par défaut en raisonnement désactivé ; un modèle qui ne peut pas le désactiver retombe à son niveau le plus bas, et un refus à l’exécution est mémorisé.
voice.voice_chat_mode: gpt-liveremplace toute la chaîne par un modèle vocal full-duplex qui délègue le vrai travail au modèle de session — Desktop uniquement, clé OpenAI directe, 0,05 $/min temps d’inactivité compris.- Le modèle vocal ne force jamais une compaction ; si la conversation dépasse sa fenêtre, ce tour retombe sur le modèle de session avec un avertissement.
Nous avons déjà couvert les deux autres moitiés de la chaîne vocale : garder le modèle vocal local chaud grâce au streaming au niveau des phrases, et le rognage du silence avant envoi plus le déchargement en inactivité. Avec le « quel modèle répond » d’aujourd’hui, les trois étapes sont documentées.