Un turno hablado ya no tiene que usar tu modelo de escritura
Estás hablando con Hermes Desktop con el modo de voz activado, preguntas qué hora es, y la pausa intermedia es lo bastante larga como para hacerte comprobar el micrófono. Cuando por fin responde, el ritmo es natural, pero se nota que antes ha pensado — porque quien te contesta es el mismo modelo con el que escribes. El problema no es el pipeline de audio. Es que este turno corre sobre el mismo cerebro: mismo modelo, mismo presupuesto de razonamiento, mismo precio. De ahí se derivan dos desperdicios, y puede que no hayas reparado en ninguno: la voz es la única superficie que necesita ser rápida, y estaba ejecutando razonamiento largo; las peticiones de voz suelen ser cortas, y se facturaban a precio de tu modelo principal. Hermes ahora ha separado esas dos cosas.
Los turnos hablados tienen su propio slot de modelo
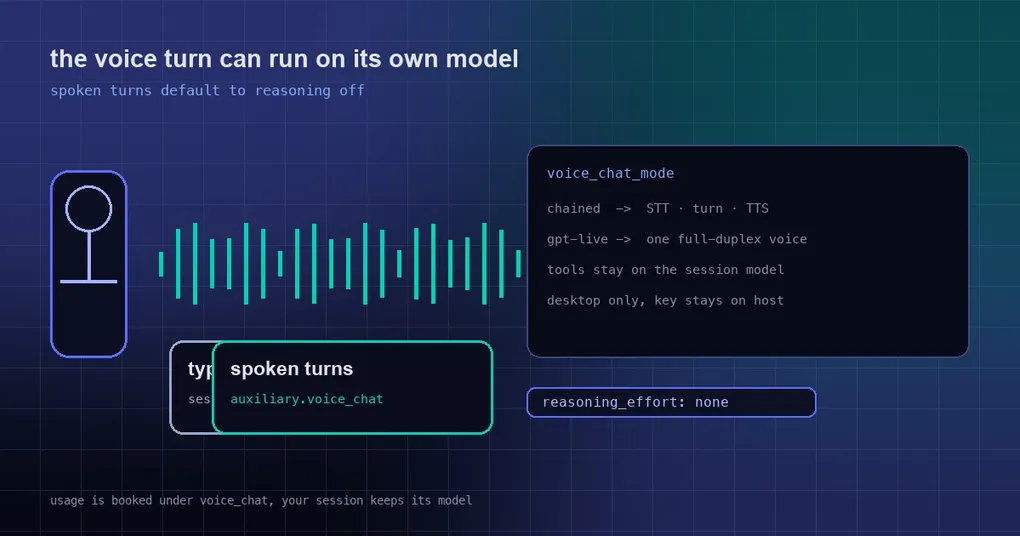
El nuevo slot es auxiliary.voice_chat, y funciona como los demás modelos auxiliares que ya conoces (vision, title_generation, compression): solo cambia el modelo que responde al turno hablado — todo lo demás se queda donde estaba. El valor por defecto es auto, que significa el modelo de la sesión actual, así que no hacer nada mantiene el comportamiento al que estás acostumbrado.
Tres formas de cambiarlo, todas escriben la misma configuración:
auxiliary:
  voice_chat:
    provider: openrouter          # "auto" = el modelo de la propia sesión (por defecto)
    model: google/gemini-3-flash-preview   # vacío junto a un provider = el modelo rápido de ese provider
reasoning_effort: none # por defecto: razonamiento desactivado en los turnos de voz (ver abajo)- Escritorio: Ajustes → Modelos → Modelos auxiliares;
- CLI:
hermes model→ Modelos auxiliares, donde la lista ahora incluyevoice_chatcomocurrently: auto / main model; - O escríbelo directamente en
config.yaml, exactamente como arriba.
Conoce el radio de impacto: todos los turnos que se hablan — el modo de voz de CLI y TUI, la conversación de voz del escritorio y las notas de voz en las plataformas de mensajería. El turno de voz conserva todo el toolset; solo cambia el modelo que responde. Tu siguiente mensaje escrito vuelve al modelo de la sesión, y lo mismo hacen las revisiones de memoria y de skills que siguen a un turno. El uso se registra bajo la tarea voice_chat, así que un turno de voz nunca cambia en silencio cuál es el modelo de tu sesión.
El razonamiento viene desactivado por defecto — y recuerda una negativa
El segundo cambio es más directo: los turnos de voz vienen con el razonamiento desactivado por defecto (reasoning_effort: none), y eso se aplica incluso cuando dejas el slot en auto y responde el propio modelo de la sesión. La razón es sencilla: el valor de hablar está en el tiempo de respuesta; pensar largo convierte una conversación en un buzón de voz.
Hay dos excepciones del mundo real, gestionadas con sensatez:
- El modelo se niega a desactivar el razonamiento (un modelo de pensamiento obligatorio, o una ruta cuyo catálogo lo marca como obligatorio) → recibe su nivel más bajo aceptado en lugar de un valor que sería rechazado;
- Una ruta rechaza la desactivación en tiempo de ejecución → el resultado se recuerda, así que el siguiente turno de voz no se estrella contra el mismo muro.
Si de verdad quieres algo de razonamiento en la voz (por ejemplo, para resumir mientras escuchas), define un nivel explícito. Ponerlo a la cadena vacía "" significa «sigue lo que use la sesión».
Un detalle más, silencioso: el modelo de voz nunca fuerza una compactación. Si la conversación ya es más grande que la ventana de contexto de ese modelo, normalmente más pequeño, ese turno corre sobre el modelo de la sesión y recibes un aviso puntual — en lugar de que desaparezca la mitad del historial sin decir nada.
Un paso más: deja que un único modelo de voz full-duplex controle el bucle
Si la propia cadena «transcribir → turno → hablar» te parece lenta, hay un segundo modo. Cambia el modo de chat de voz del escritorio a gpt-live y toda la cadena se sustituye por un único modelo de voz full-duplex: escucha mientras habla, gestiona él mismo las interrupciones, los backchannels y el ruido de fondo, y no tiene herramientas propias. En el momento en que pides trabajo real, delega en Hermes — el modelo de tu sesión, todo el toolset, la memoria y las aprobaciones — y luego te dice la respuesta en voz alta.
voice:
  voice_chat_mode: gpt-live     # chained (por defecto) | gpt-live
  gpt_live:
    voice: marin                # marin, cedar, quartz, ripple, vesper, willow, stone, gleam, meridian, …
    instructions: ""            # frases de persona extra opcionales (tono, ritmo, idioma)
Necesita una API key de OpenAI (OPENAI_API_KEY, VOICE_TOOLS_OPENAI_KEY o voice.gpt_live.api_key). Ojo con la facturación: OpenAI cobra la capa de voz a 0,05 $ por minuto de tiempo de sesión (el tiempo en reposo cuenta), mientras que el turno de Hermes se factura en tu propio provider como siempre. Si gpt-live está seleccionado pero no se resuelve ninguna key, el botón recurre al modo encadenado con un aviso en lugar de fallar en silencio.
Algunos límites conviene conocerlos de antemano: este modo no puede usar el proxy de audio gestionado por Nous (solo key directa), es solo para el escritorio (/voice de CLI/TUI se queda en el bucle encadenado), y la herramienta tts sigue usando tts.provider. La key tampoco llega nunca al cliente — el escritorio recibe un id de sesión y una respuesta SDP, y el host del gateway crea la sesión (POST /api/audio/voice-live/session).
Rincones que hacen tropezar a la gente
gpt-liveignoraauxiliary.voice_chat: en esa ruta la capa de voz ya es el modelo rápido y el modelo de la sesión hace el trabajo real, así que un modelo de voz aparte no aporta nada.- El ajuste del barge-in sigue aplicándose en el modo encadenado, y merece la pena afinarlo:
voice.barge_in(activado por defecto),voice.barge_in_threshold_multiplier(3.0 por defecto; más bajo es más sensible — prueba 1.5 con unos auriculares Bluetooth silenciosos) yvoice.barge_in_grace_seconds(0.5). Cuando se comporta mal,HERMES_VOICE_DEBUG=1envía a stderr las decisiones de VAD por bloque (suelo calibrado, RMS, disparo). - La velocidad tiene un coste: un modelo más pequeño es más propenso a responder de forma superficial. El patrón seguro es un modelo rápido para la voz y escribir la pregunta cuando necesitas profundidad — esa ruta sigue usando tu modelo original, sin diluir.
Para terminar
auxiliary.voice_chatda al turno hablado su propio modelo; el valor por defecto esauto(el modelo de la sesión).- Los turnos de voz vienen con el razonamiento desactivado por defecto; un modelo que no puede desactivarlo baja a su nivel más bajo, y una negativa en tiempo de ejecución se recuerda.
voice.voice_chat_mode: gpt-livesustituye toda la cadena por un modelo de voz full-duplex que delega el trabajo real al modelo de la sesión — solo para el escritorio, key directa de OpenAI, 0,05 $/min con el tiempo en reposo incluido.- El modelo de voz nunca fuerza una compactación; si la conversación supera su ventana, ese turno recurre al modelo de la sesión con un aviso.
Ya hemos cubierto antes las otras dos mitades de la cadena de voz: mantener caliente el modelo de voz local con streaming por frases, y recortar los silencios antes de subir más la descarga en reposo. Con el «qué modelo responde» de hoy, las tres etapas quedan documentadas.