Ein gesprochener Turn muss nicht mehr dein Tipp-Modell verwenden
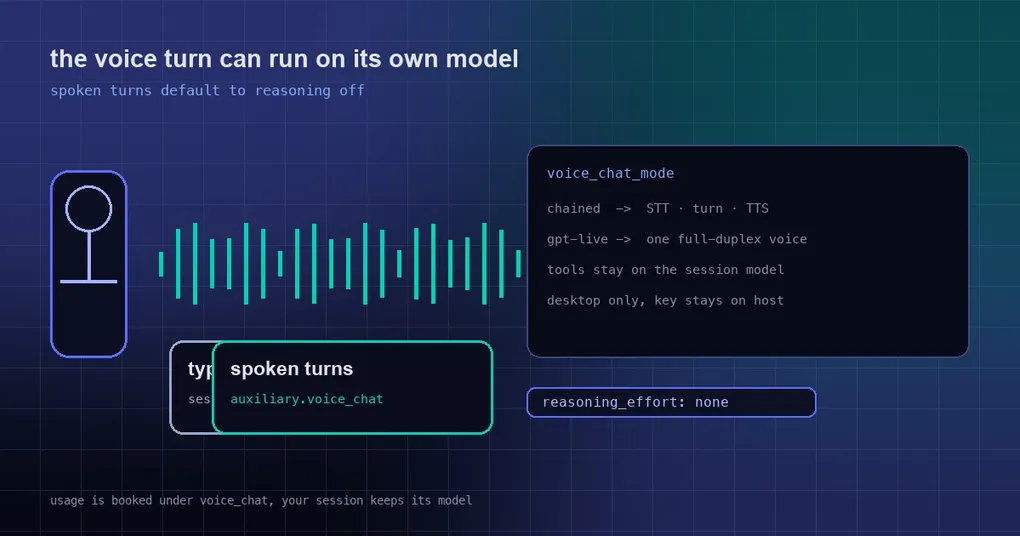
Du sprichst mit Hermes Desktop im Voice-Modus, fragst, wie spät es ist, und die Pause dazwischen ist lang genug, dass du das Mikrofon prüfst. Wenn es endlich spricht, ist die Kadenz natürlich, aber du hörst, dass es zuerst gedacht hat — denn das, was dir antwortet, ist dasselbe Modell, an das du tippst. Das Problem ist nicht die Audio-Pipeline. Es ist, dass dieser Turn auf demselben Gehirn läuft: dasselbe Modell, dasselbe Denkbudget, derselbe Preis. Daraus folgen zwei Verschwendungen, und vielleicht hast du keine davon bemerkt: Voice ist die eine Oberfläche, die schnell sein muss, und sie lief mit langem Reasoning; Voice-Fragen sind meist kurz, und sie wurden zu deinem Hauptmodell abgerechnet. Hermes hat diese beiden Dinge jetzt auseinandergezogen.
Gesprochene Turns bekommen ihren eigenen Modell-Slot
Der neue Slot ist auxiliary.voice_chat, und er funktioniert wie die anderen Aux-Modelle, die du schon kennst (vision, title_generation, compression): Er ändert nur das Modell, das den gesprochenen Turn beantwortet — alles andere bleibt, wo es war. Der Default ist auto, was das Modell der aktuellen Session bedeutet; nichts zu tun behält also das Verhalten, das du kennst.
Drei Wege, es zu ändern, alle schreiben dieselbe Config:
auxiliary:
  voice_chat:
    provider: openrouter          # "auto" = das eigene Modell der Session (Default)
    model: google/gemini-3-flash-preview   # leer mit einem Provider = das schnelle Modell dieses Providers
reasoning_effort: none # Default: Reasoning bei Voice-Turns aus (siehe unten)- Desktop: Settings → Models → Auxiliary models;
- CLI:
hermes model→ Auxiliary models, wo die Liste jetztvoice_chatalscurrently: auto / main modelführt; - Oder schreibe es direkt in
config.yaml, genau wie oben.
Kenne den Wirkungsradius: jeder Turn, der gesprochen wird — CLI- und TUI-Voice-Modus, die Voice-Konversation im Desktop und Voice-Notizen auf Messaging-Plattformen. Der Voice-Turn behält das volle Toolset; nur das Modell, das ihn beantwortet, ändert sich. Deine nächste getippte Nachricht geht zurück zum Modell der Session, und ebenso die Memory- und Skill-Reviews, die einem Turn folgen. Die Nutzung wird unter der Aufgabe voice_chat erfasst, sodass ein Voice-Turn nie still umschreibt, welches Modell deine Session ist.
Reasoning ist standardmäßig aus — und es merkt sich eine Ablehnung
Die zweite Änderung ist deutlicher: Voice-Turns sind standardmäßig ohne Reasoning (reasoning_effort: none), und das gilt auch dann, wenn du den Slot auf auto lässt und das eigene Modell der Session antwortet. Der Grund ist einfach: Der Wert des Sprechens ist die Antwortzeit; langes Denken macht aus einer Konversation eine Voicemail.
Es gibt zwei realweltliche Ausnahmen, sinnvoll behandelt:
- Das Modell weigert sich, Reasoning auszuschalten (ein Modell mit Pflicht-Denken oder eine Route, deren Katalog es als mandatory markiert) → es bekommt stattdessen sein niedrigstes akzeptiertes Level statt eines Werts, der abgelehnt würde;
- Eine Route lehnt das Deaktivieren zur Laufzeit ab → das Ergebnis wird gemerkt, damit der nächste Voice-Turn nicht in dieselbe Wand läuft.
Wenn du bei Voice doch etwas Denken willst (sagen wir, um während des Zuhörens zusammenzufassen), setze ein Level explizit. Ihn auf den leeren String "" zu setzen bedeutet „folge dem, was die Session nutzt“.
Ein weiteres leises Detail: Das Voice-Modell erzwingt nie eine Kontext-Kompaktierung. Ist die Konversation bereits größer als das Kontextfenster dieses meist kleineren Modells, läuft dieser Turn stattdessen auf dem Modell der Session, und du bekommst einen einmaligen Hinweis — statt dass die halbe History wortlos verschwindet.
Weiter gehen: Lass ein Full-Duplex-Voice-Modell die Schleife übernehmen
Wenn die Kette „transkribieren → Turn → sprechen“ selbst langsam erscheint, gibt es einen zweiten Modus. Schalte den Voice-Chat-Modus des Desktops auf gpt-live, und die ganze Kette wird durch ein Full-Duplex-Voice-Modell ersetzt: Es hört zu, während es spricht, übernimmt Unterbrechungen, Backchannels und Hintergrundgeräusche selbst und hat keine eigenen Tools. In dem Moment, in dem du echte Arbeit verlangst, delegiert es an Hermes — das Modell deiner Session, das volle Toolset, Memory und Approvals — und spricht dir die Antwort dann zurück.
voice:
  voice_chat_mode: gpt-live     # chained (default) | gpt-live
  gpt_live:
    voice: marin                # marin, cedar, quartz, ripple, vesper, willow, stone, gleam, meridian, …
    instructions: ""            # optionale zusätzliche Persona-Sätze (Ton, Tempo, Sprache)
Es braucht einen OpenAI-API-Key (OPENAI_API_KEY, VOICE_TOOLS_OPENAI_KEY oder voice.gpt_live.api_key). Achte auf die Abrechnung: Die Voice-Schicht wird von OpenAI mit $0,05 pro Minute Sitzungszeit abgerechnet (Leerlaufzeit zählt), während der Hermes-Turn wie immer über deinen eigenen Provider läuft. Wenn gpt-live ausgewählt ist, aber kein Key aufgelöst wird, fällt der Button mit einem Hinweis auf den verketteten Modus zurück, statt still zu scheitern.
Einige Grenzen sind gut, vorab zu kennen: Dieser Modus kann den von Nous verwalteten Audio-Proxy nicht nutzen (nur direkter Key), er ist nur im Desktop verfügbar (CLI/TUI /voice bleibt auf der verketteten Schleife), und das tts-Tool nutzt weiterhin tts.provider. Der Key erreicht außerdem nie den Client — der Desktop erhält eine Session-ID und eine SDP-Antwort, und der Gateway-Host erstellt die Session (POST /api/audio/voice-live/session).
Ecken, an denen Leute hängen bleiben
gpt-liveignoriertauxiliary.voice_chat: Auf diesem Pfad ist die Voice-Schicht bereits das schnelle Modell, und das Session-Modell macht die echte Arbeit, also bedeutet ein separates Voice-Modell nichts.- Barge-in-Tuning gilt weiterhin im verketteten Modus, und es lohnt sich:
voice.barge_in(standardmäßig an),voice.barge_in_threshold_multiplier(standardmäßig 3,0; niedriger ist empfindlicher — probiere 1,5 an einem leisen Bluetooth-Headset) undvoice.barge_in_grace_seconds(0,5). Wenn es sich danebenbenimmt, streamtHERMES_VOICE_DEBUG=1VAD-Entscheidungen pro Block (kalibrierter Floor, RMS, Trip) nach stderr. - Geschwindigkeit hat einen Preis: Ein kleineres Modell antwortet eher dünn. Das sichere Muster ist ein schnelles Modell für Voice und die Frage zu tippen, wenn du Tiefe brauchst — dieser Pfad nutzt weiterhin dein ursprüngliches Modell, unverdünnt.
Die Kurzfassung
auxiliary.voice_chatgibt dem gesprochenen Turn sein eigenes Modell; der Default istauto(das Session-Modell).- Voice-Turns sind standardmäßig ohne Reasoning; ein Modell, das es nicht deaktivieren kann, fällt auf sein niedrigstes Level zurück, und eine Laufzeit-Ablehnung wird gemerkt.
voice.voice_chat_mode: gpt-livetauscht die ganze Kette gegen ein Full-Duplex-Voice-Modell, das echte Arbeit an das Session-Modell delegiert — nur Desktop, direkter OpenAI-Key, $0,05/Min. inklusive Leerlaufzeit.- Das Voice-Modell erzwingt nie eine Kontext-Kompaktierung; überschreitet die Konversation sein Fenster, fällt dieser Turn mit einem Hinweis auf das Session-Modell zurück.
Wir haben die anderen beiden Hälften der Voice-Kette schon behandelt: das lokale Sprachmodell mit Satz-für-Satz-Streaming warmhalten und Stille vor dem Upload kürzen plus Idle-Unload. Mit dem heutigen „Welches Modell antwortet“ sind alle drei Stufen dokumentiert.