本地模型只"想"不说话:那六次重复请求是怎么来的,修复为什么还没进 v0.23.1
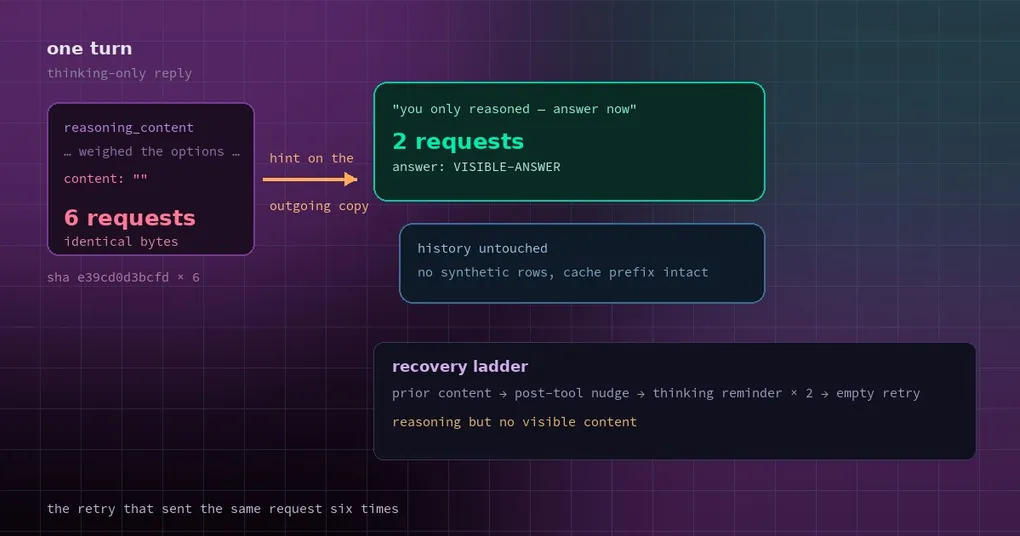
你在自己的笔记本上跑一个本地模型,硬件不算强,但够用。某个任务它想了很久,状态栏闪过“正在思考”,然后——什么都没给你。没有答案,没有报错,只有一句“模型这次没有产生回复,重试之后仍然没有”。你打开日志,看到六次请求大小完全相同,像是某个环节卡在了原地。
这不是模型笨,也不是你的机器不够快。这是恢复逻辑里的一个自相矛盾:Hermes 每次都“努力提醒模型该说话了”,但那条提醒在发出去之前被自己的一道清洗规则丢掉了。于是六次重试,六份字节级完全相同的请求,模型当然每次都做同一件事。
修复已经合进 main,但 v0.23.1 里还没有——它要等下一个正式版本。这篇讲清三件事:为什么思考模型会只“想”不说话、那条提醒为什么消失、以及修完之后你该期待什么。
一个只有推理、没有正文的回复
先解释一下这类模型的输出结构。很多本地思考模型(Qwen 系、部分 Ollama 模型、LM Studio 里带 reasoning 的模型)会把回复拆成两段:
- 推理段(
reasoning_content,或者某些实现直接塞在正文里的<think>块)——模型“想”的过程; - 正文段(
content)——给用户看的答案。
正常情况下两段都有。少数情况下,模型把预算全花在推理上,正文是空的:content: ""。你在界面上看到的就是“它想过了,但什么都没说”。
Hermes 对这种情况是有恢复阶梯的,按顺序尝试:
- 上一轮有内容的话,先用上一轮的内容兜底;
- 工具调用之后出现的空回复,先推一把让模型继续(只推一次);
- 只推理没正文的,发一条“请把答案写出来”的提醒(最多两次);
- 还是空的,进入常规的空回复重试。
问题出在第 3 步的实现上。
那条提醒为什么消失了
修复前的做法是:往对话里追加一条“助手只写了推理”的预填(prefill)行,让模型看起来是“说到一半”,然后请求它继续。
听起来合理,但同一套代码里还有另一条规则:发送前的清洗器会丢掉“只有推理、没有正文”的助手回合。它的目的是别把这类空回合带给模型,以免浪费上下文。
两条规则撞在一起,结果就是:加进去的预填行,在发出去之前被清洗掉了。发出去的请求和上一次字节级完全一样——同样的 messages、同样的长度、同样的哈希。模型面对完全一样的输入,做了完全一样的事,于是又只推理不说话。循环六次,然后放弃。
官方在报告里给的实测对比很能说明问题:
| 修复前 | 修复后 | |
|---|---|---|
| 主模型请求次数 | 6 | 2 |
| 请求体去重(messages 的 sha) | 1 种,e39cd0d3bcfd × 6 |
2 种 |
| 最终回复 | “这次没有回复,重试后仍然没有” | 正常答案 |
| 写入历史 | 多出合成的空行 | 历史不变 |
这个坑在社区里是被一名用户在 Discord 上报出来的:本地 LM Studio + 一个 Qwen 变体,状态栏能清楚看到“Thinking-only response — prefilling to continue (1/2)(2/2)”,接着三次“Empty response”,然后放弃,而六次请求的输入大小一模一样。
改法:提示只加在“发出去的那一份”上
这次的修复思路很干净,一句话概括:恢复提示只存在于出站副本,不进入历史。
具体做法:
- 提醒(“你只写了推理,现在把答案写出来”)以及工具调用后的推动语,都只追加到最后一条用户消息或工具结果的出站副本上;
- 存下来的历史、之前的缓存前缀、SQLite 里的行都不动,缓存因此不会被一次重试打穿;
- 拿到回复之后、回合收尾时、进入下一轮时,提示会被清掉;
- 工具调用后的推动语不再往实时历史里写合成的空助手/用户行;
- 如果这一轮工具调用真的落地了,思考重试预算会直接重置,不再依赖一条预填行。
顺带修了一个让排查变难的点:重试日志原来写“没有内容或推理”,可模型明明推理了——这会把人往 LM Studio 的设置上引。现在这种情况写的是 reasoning but no visible content(“有推理,但没有可见内容”),指向准确。
代码在 agent/turn_empty_response.py。这个文件就是一整条“空回复恢复阶梯”:先看上一轮有没有可用内容,再看是不是工具调用之后,再判断有没有结构化的推理字段——连 Ollama 那种把 <think> 写在正文里的情况也识别——最后才进常规重试。
这对你意味着什么
如果你在本地跑思考模型,最直接的收益是时间与电费:六次一模一样的请求变成两次,而且第二次大概率拿到答案。如果你用的是按 token 计费的服务,这就是实打实的账单差异——重复请求没人会给你打折。
第二个收益是历史干净。以前的重试会往对话里塞合成的空行,长会话里这些小垃圾会越积越多,还会影响压缩和缓存命中。现在历史只记录真实发生过的内容。
第三个收益是排查路径短了。日志不再说“没有内容或推理”这种既对又不对的话;看到 reasoning but no visible content,你就知道模型在思考、只是没往外写,该调的是输出预算或者提示,而不是去怀疑工具链。
顺手说两个相关设置:
- 想让模型更容易说出话,可以给本地模型留足输出预算,或者把系统的“思考”级别调低一档;
- 长会话里如果经常触到这类边界,可以看看我们之前写的空的尾部怎么被压缩和上下文窗口是怎么被测量的,它们解释的是同一类“上下文管理”问题。
什么时候还会遇到
老实说,这个修复让循环从“必然发生六次”变成“通常两次就结束”,但没有改变一件事:模型仍然可能只推理不写正文。修复的是“我们如何提醒它”,不是“它为什么犯这个错”。后者取决于模型本身、量化版本、输出预算和提示写法。
所以看到这类日志时,正确的反应是:
- 先看是不是只有一次提醒就恢复了——那说明修复生效,可以继续用;
- 如果每次都在同一个提示上发生,改提示或者改输出预算;
- 如果连推理都没有(日志写“没有内容或推理”),那就是另一类问题:模型或连接层真的没返回东西。
这条修复是从社区提交里 salvage 过来的(原始 PR 作者保留署名),并补了一处日志措辞。它在 2026-11-10 合并进 main,晚于 v0.23.1 的发布点(11-10 00:16Z),所以还没进任何正式版本;想现在用就跟 main。v0.23.1 本身的说明见v0.23.1 发版页,同批次的插件目录修复见这篇解读。