Des modèles locaux qui réfléchissent sans jamais parler : d'où venaient ces six requêtes identiques
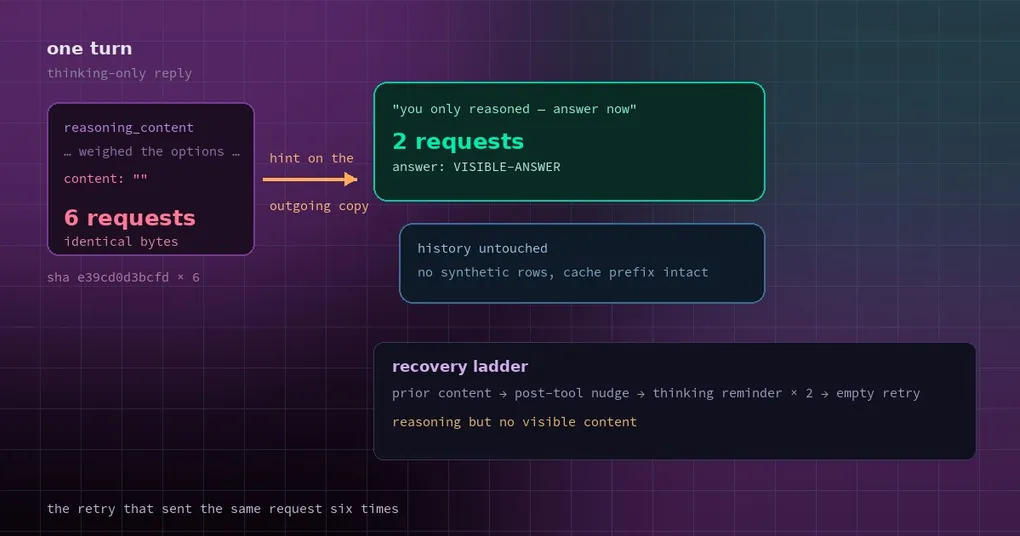
Vous faites tourner un modèle local sur un portable. Le matériel est modeste, mais suffisant. Sur une tâche, il réfléchit longtemps, la ligne de statut clignote entre ses états de raisonnement, puis — rien. Pas de réponse, pas d’erreur, juste un avis comme quoi le modèle n’a produit aucune réponse cette fois, même après les tentatives. Vous ouvrez le log et voyez six requêtes de taille identique, comme si quelque chose s’était bloqué sur place.
Le modèle n’est pas bête et votre machine n’est pas trop lente. C’est une contradiction interne au chemin de récupération : Hermes n’arrêtait pas de rappeler au modèle qu’il devait parler, mais ce rappel était supprimé par un assainisseur avant même de quitter le processus. Six tentatives, six requêtes identiques à l’octet près, six décisions identiques du modèle.
Le correctif est sur main, mais pas dans la v0.23.1 : il attend la prochaine version. Trois choses valent la peine d’être comprises : pourquoi un modèle de raisonnement produit du raisonnement sans content, pourquoi le rappel a disparu, et à quoi vous attendre maintenant.
Une réponse avec du raisonnement et sans content
Commencez par la forme de la sortie. Beaucoup de modèles de raisonnement locaux (la famille Qwen, certains modèles Ollama, tout ce qui a un canal de raisonnement dans LM Studio) découpent une réponse en deux parties :
- la partie raisonnement —
reasoning_content, ou un bloc<think>que certaines implémentations glissent directement dans le content ; - la partie content — la réponse qu’un humain lit.
Normalement, les deux existent. Parfois le modèle dépense tout son budget en raisonnement et laisse le content vide : content: "". À l’écran, cela donne « il y a pensé et n’a rien dit ».
Hermes a une échelle de récupération pour exactement ce cas, dans l’ordre :
- si le tour précédent avait un content exploitable, s’en servir comme filet ;
- après un appel d’outil, pousser le modèle une fois à continuer ;
- quand il y a du raisonnement mais pas de content, envoyer un rappel du genre « écris la réponse » — jusqu’à deux fois ;
- sinon, entrer dans les tentatives normales de réponse vide.
Le bug vivait à l’étape 3.
Pourquoi le rappel a disparu
L’ancienne approche ajoutait une ligne de prefill assistant disant en substance « tu n’as fait que raisonner », pour que le modèle se voie en pleine réflexion et poursuive.
Raisonnable en soi. Mais la même base de code a une autre règle : l’assainisseur à l’envoi écarte les tours assistant qui contiennent du raisonnement mais aucun content visible, précisément pour que ces tours vides ne gaspillent pas de contexte.
Les deux règles se sont heurtées. La ligne de prefill était supprimée avant que la requête parte, si bien que la requête sortante était identique à l’octet près à celle qui venait d’échouer : mêmes messages, même longueur, même hash. Face à la même entrée, le modèle a fait la même chose — raisonner et ne rien dire. Six fois, puis abandon.
La mesure du rapport est sans détour :
| Avant | Après | |
|---|---|---|
| Requêtes au modèle principal | 6 | 2 |
| Corps de requête distincts (sha des messages) | 1, e39cd0d3bcfd × 6 |
2 |
| Réponse finale | « aucune réponse cette fois, même après les tentatives » | une vraie réponse |
| Lignes écrites dans l’historique | des lignes vides synthétiques ajoutées | historique inchangé |
Le rapport vient d’un utilisateur sur Discord : LM Studio en local avec une variante de Qwen, des heartbeats montrant clairement « Thinking-only response — prefilling to continue (1/2)(2/2) », puis trois tentatives « Empty response » et l’avis d’absence de réponse, avec six requêtes de taille d’entrée identique.
Le correctif : l’indice vit uniquement sur la copie sortante
L’approche est propre, et une phrase la résume : les indices de récupération n’existent que sur la copie sortante, jamais dans l’historique.
Concrètement :
- le rappel (« tu n’as fait que raisonner — réponds maintenant ») et la poussée après appel d’outil sont ajoutés à la copie sortante du dernier message utilisateur ou du dernier résultat d’outil ;
- l’historique stocké, le préfixe de cache antérieur et les lignes SQLite restent intacts : une nouvelle tentative ne fait donc plus exploser le prompt cache ;
- l’indice est effacé à l’arrivée d’une réponse, à la finalisation et au tour suivant ;
- la poussée après appel d’outil n’écrit plus de lignes assistant/utilisateur vides synthétiques dans l’historique vivant ;
- si un appel d’outil a réellement abouti, le budget de tentatives de raisonnement est réinitialisé sans dépendre d’une ligne de prefill.
Un changement de plus facilite le diagnostic. L’avertissement de tentative disait « pas de content ni de raisonnement » même quand le modèle avait clairement raisonné — ce qui envoie les gens fouiller dans les réglages de LM Studio. Il dit maintenant reasoning but no visible content.
Le code est dans agent/turn_empty_response.py, soit exactement l’échelle décrite plus haut : vérifier s’il y a un content précédent, vérifier si un outil a tourné, vérifier s’il existe des champs de raisonnement structurés — y compris le cas Ollama où <think> se trouve dans le content — et seulement ensuite retomber sur les tentatives normales.
Ce que cela change pour vous
Sur un modèle local, le gain direct est en temps et en chaleur : six requêtes identiques deviennent deux, et la seconde produit généralement la réponse. Chez un fournisseur facturé à l’usage, c’est de l’argent réel — personne ne vous fait de remise pour avoir renvoyé la même requête.
Deuxième gain : un historique propre. Les anciennes tentatives poussaient des lignes vides synthétiques dans la conversation ; sur les longues sessions, elles s’accumulent et gênent la compaction comme les hits de cache. Désormais l’historique n’enregistre que ce qui s’est vraiment passé.
Troisième gain : un chemin de débogage plus court. Le log ne dit plus quelque chose de vrai et d’inutile à la fois. reasoning but no visible content vous dit que le modèle réfléchit sans écrire ; vous ajustez le budget de sortie ou le prompt au lieu de suspecter la chaîne d’outils.
Deux réglages liés valent la peine d’être connus : donnez aux modèles locaux assez de budget de sortie (ou baissez d’un cran l’effort de raisonnement) si cela se reproduit, et si les longues sessions continuent de frôler ces limites, nos articles précédents sur la façon dont la queue légère est compressée et la façon dont l’étiquette de fenêtre de contexte est choisie couvrent la même famille de problèmes de gestion du contexte.
Quand cela peut encore arriver
Pour être honnête sur la portée : le correctif transforme « toujours six » en « généralement deux », mais il ne change pas le fait de fond qu’un modèle peut encore raisonner sans écrire. Ce qui est corrigé, c’est la manière de redemander, pas la raison du blocage. Cette dernière dépend du modèle, de la quantification, du budget de sortie et du prompt.
Donc quand vous voyez ces logs :
- si un seul rappel suffit à récupérer, le correctif fonctionne — continuez ;
- si cela arrive sur le même prompt à chaque fois, changez le prompt ou le budget de sortie ;
- s’il n’y a pas non plus de raisonnement (le log dit pas de content ni de raisonnement), c’est un autre problème : le modèle ou le transport n’a rien renvoyé du tout.
Le correctif a été récupéré depuis une PR communautaire (l’auteur d’origine est conservé) avec une correction de formulation dans le log, et a été fusionné dans main le 10 novembre, après la découpe de la v0.23.1 : il n’est donc encore dans aucune release ; suivez main pour l’utiliser dès maintenant. Notes complètes sur la page de version v0.23.1, et l’autre moitié de ce patch dans le billet sur le plafond du catalogue.