Modelos locales que piensan pero nunca hablan: de dónde salieron esas seis peticiones idénticas
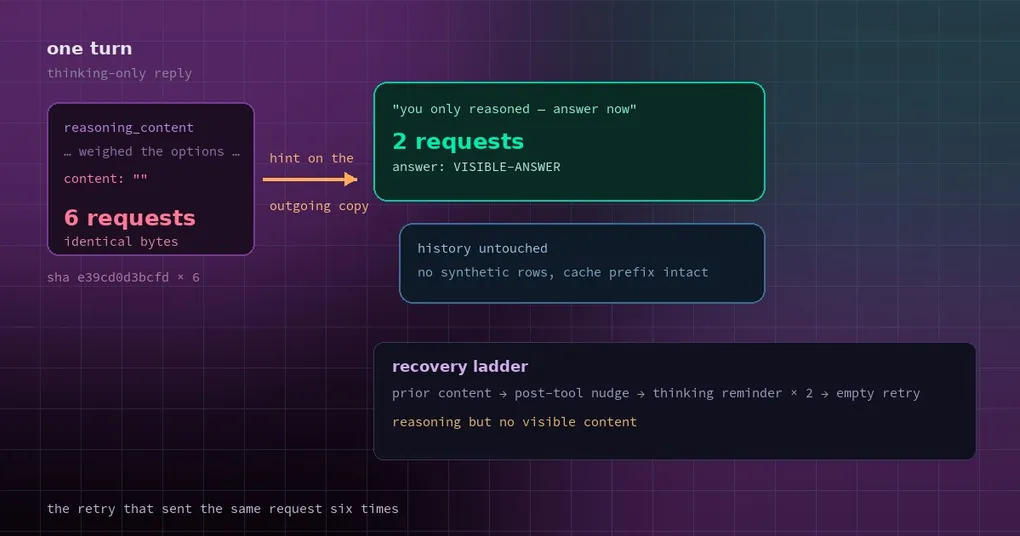
Estás moviendo un modelo local en un portátil. El hardware es modesto pero suficiente. En alguna tarea piensa durante un buen rato, la línea de estado parpadea por su estado de razonamiento y luego — nada. Ni respuesta, ni error, solo un aviso de que el modelo no produjo respuesta esta vez, ni siquiera tras los reintentos. Abres el log y ves seis peticiones de tamaño idéntico, como si algo se hubiera quedado atascado en el mismo sitio.
El modelo no es tonto y tu máquina no es demasiado lenta. Es una contradicción dentro del camino de recuperación: Hermes insistía en recordarle al modelo que hablara, pero ese recordatorio lo borraba un saneador antes de que saliera del proceso. Seis reintentos, seis peticiones idénticas byte a byte, seis decisiones idénticas del modelo.
El arreglo está en main, pero no en la v0.23.1: espera a la próxima versión. Merece la pena entender tres cosas: por qué un modelo de razonamiento produce razonamiento sin content, por qué desapareció el recordatorio y qué cabe esperar ahora.
Una respuesta con razonamiento y sin content
Empieza por la forma de la salida. Muchos modelos locales de razonamiento (la familia Qwen, algunos modelos de Ollama, cualquiera con un canal de razonamiento en LM Studio) parten la respuesta en dos mitades:
- la parte de razonamiento —
reasoning_content, o un bloque<think>que algunas implementaciones meten directamente en el content; - la parte de content — la respuesta que lee una persona.
Normalmente existen las dos. A veces el modelo se gasta todo el presupuesto razonando y deja el content vacío: content: "". En pantalla eso se lee como «lo pensó y no dijo nada».
Para justo esto Hermes tiene una escalera de recuperación, en orden:
- si el turno anterior tenía content aprovechable, usarlo como respaldo;
- después de una llamada a herramienta, empujar al modelo una vez a continuar;
- cuando hay razonamiento pero no content, enviar un recordatorio del tipo «escribe la respuesta» — hasta dos veces;
- en caso contrario, entrar en los reintentos normales de respuesta vacía.
El bug vivía en el paso 3.
Por qué desapareció el recordatorio
El enfoque antiguo añadía una fila de prefill de asistente que venía a decir «solo has razonado», para que el modelo se viera a mitad del pensamiento y continuara.
Razonable por sí solo. Pero el mismo código tiene otra regla: el saneador de envío descarta los turnos de asistente que contienen razonamiento pero ningún content visible, precisamente para que esos turnos vacíos no gasten contexto.
Las dos reglas chocaron. La fila de prefill se descartaba antes de que la petición saliera, así que la petición saliente era idéntica byte a byte a la que acababa de fallar: mismos messages, misma longitud, mismo hash. Ante la misma entrada, el modelo hizo lo mismo: razonar y no decir nada. Seis veces, y luego rendirse.
La medición del informe es contundente:
| Antes | Después | |
|---|---|---|
| Peticiones al modelo principal | 6 | 2 |
| Cuerpos de petición distintos (sha de messages) | 1, e39cd0d3bcfd × 6 |
2 |
| Respuesta final | «no hubo respuesta esta vez, ni siquiera tras los reintentos» | una respuesta real |
| Filas escritas en el historial | se añadían filas vacías sintéticas | historial sin cambios |
El informe vino de un usuario en Discord: LM Studio local con una variante de Qwen, heartbeats que mostraban con claridad «Thinking-only response — prefilling to continue (1/2)(2/2)», luego tres reintentos de «Empty response» y el aviso de que no había respuesta, con seis peticiones de idéntico tamaño de entrada.
La solución: el aviso vive solo en la copia saliente
El enfoque es limpio y una sola frase lo resume: los avisos de recuperación existen solo en la copia de salida, nunca en el historial.
En concreto:
- el recordatorio («solo has razonado — responde ahora») y el empujón posterior a la herramienta se añaden a la copia saliente del último mensaje de usuario o del último resultado de herramienta;
- el historial guardado, el prefijo de cache anterior y las filas de SQLite quedan intactos, así que un reintento ya no revienta el prompt cache;
- el aviso se limpia cuando llega una respuesta, al finalizar el turno y en el turno siguiente;
- el empujón posterior a la herramienta ya no escribe filas sintéticas vacías de asistente/usuario en el historial vivo;
- si una llamada a herramienta llegó a ejecutarse de verdad, el presupuesto de reintentos de razonamiento se reinicia sin depender de ninguna fila de prefill.
Un cambio más facilita el diagnóstico. El aviso de reintento decía «sin content ni razonamiento» incluso cuando el modelo había razonado con claridad, lo que manda a la gente a buscar en los ajustes de LM Studio. Ahora dice reasoning but no visible content.
El código está en agent/turn_empty_response.py, que es exactamente la escalera descrita arriba: comprobar si hay content previo, comprobar si se ejecutó una herramienta, comprobar si hay campos de razonamiento estructurados — incluido el caso de Ollama en el que <think> viaja dentro del content — y solo entonces caer a los reintentos normales.
Qué cambia esto para ti
En un modelo local, la ganancia directa es tiempo y calor: seis peticiones idénticas pasan a dos, y la segunda suele producir la respuesta. En un proveedor con tarifa por uso esto es dinero real: nadie te hace descuento por reenviar la misma petición.
La segunda ganancia es un historial limpio. Los reintentos antiguos metían filas vacías sintéticas en la conversación; en sesiones largas se acumulan y estorban a la compactación y a los aciertos de cache. Ahora el historial solo registra lo que pasó de verdad.
La tercera ganancia es un camino de depuración más corto. El log ya no dice algo que es verdadero e inútil a la vez. reasoning but no visible content te dice que el modelo está pensando y no escribiendo; ajustas el presupuesto de salida o el prompt en lugar de sospechar de la cadena de herramientas.
Hay dos ajustes relacionados que conviene conocer: dale a los modelos locales suficiente presupuesto de salida (o baja un punto el esfuerzo de razonamiento) si esto sigue pasando, y si las sesiones largas siguen rozando estos límites, nuestros artículos anteriores sobre cómo se comprime la cola ligera y cómo se elige la etiqueta de la ventana de contexto cubren la misma familia de problemas de gestión de contexto.
Cuándo puede pasar todavía
Siendo honestos sobre el alcance: el arreglo convierte «siempre seis» en «normalmente dos», pero no cambia el hecho de fondo de que un modelo todavía puede razonar sin escribir. Lo que se arregló es cómo le volvemos a preguntar, no por qué se atasca. Esto último depende del modelo, la cuantización, el presupuesto de salida y el prompt.
Así que cuando veas estos logs:
- si un solo recordatorio basta para recuperarse, el arreglo está funcionando: sigue adelante;
- si pasa con el mismo prompt cada vez, cambia el prompt o el presupuesto de salida;
- si tampoco hay razonamiento (el log dice que no hay content ni razonamiento), es otro problema: el modelo o el transporte no devolvieron absolutamente nada.
El arreglo se rescató de un PR de la comunidad (se mantiene la autoría original) junto con una corrección de la redacción del log, y se fusionó en main el 10 de noviembre, después del corte de la v0.23.1, así que todavía no está en ninguna release; sigue main para usarlo ya. Notas completas en la página de la versión v0.23.1, y la otra mitad de este parche en la nota sobre el límite del catálogo.