Lokale Modelle, die denken, aber nie sprechen: woher diese sechs identischen Anfragen kamen
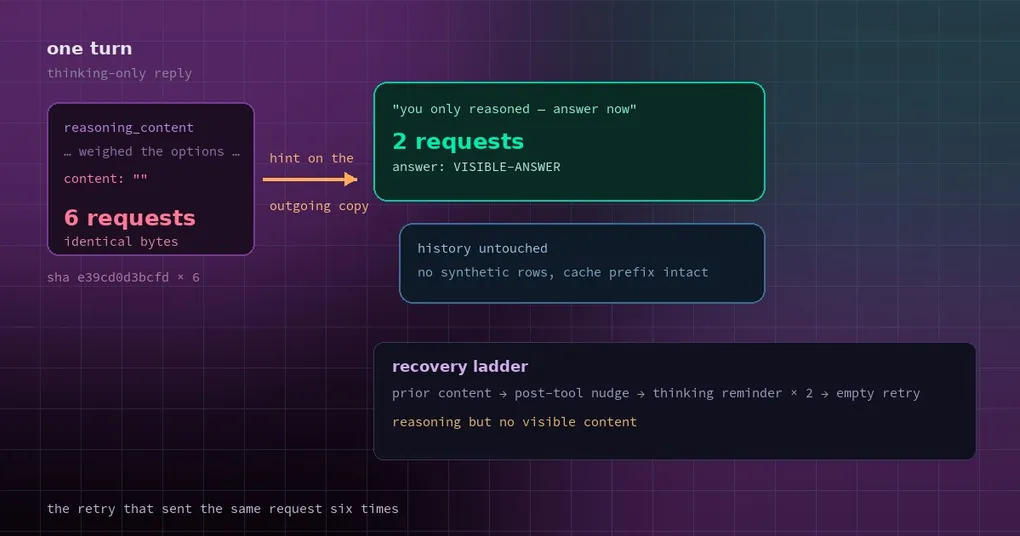
Du betreibst ein lokales Modell auf einem Laptop. Die Hardware ist bescheiden, aber brauchbar. Bei irgendeiner Aufgabe denkt es lange, die Statuszeile flackert durch seinen Reasoning-Zustand, und dann — nichts. Keine Antwort, kein Fehler, nur ein Hinweis, dass das Modell diesmal keine Antwort produziert hat, auch nach Wiederholungen. Du öffnest das Log und siehst sechs Anfragen von identischer Größe, als hätte sich etwas an Ort und Stelle festgefahren.
Das Modell ist nicht dumm, und deine Maschine ist nicht zu langsam. Das ist ein Widerspruch im Recovery-Pfad: Hermes versuchte das Modell immer wieder daran zu erinnern, dass es sprechen soll, aber diese Erinnerung wurde von einem Sanitizer gelöscht, bevor sie den Prozess verließ. Sechs Wiederholungen, sechs byte-identische Anfragen, sechs identische Entscheidungen des Modells.
Der Fix liegt auf main, aber nicht in v0.23.1 – er wartet auf das nächste Release. Drei Dinge lohnen sich zu verstehen: warum ein Thinking-Modell Reasoning ohne content produziert, warum der Hinweis verschwand und was du jetzt erwarten kannst.
Eine Antwort mit Reasoning und ohne content
Fang bei der Form der Ausgabe an. Viele lokale Reasoning-Modelle (die Qwen-Familie, manche Ollama-Modelle, alles mit einem Reasoning-Kanal in LM Studio) teilen eine Antwort in zwei Teile:
- der Reasoning-Teil —
reasoning_content, oder ein<think>-Block, den manche Implementierungen direkt in den content setzen; - der content-Teil — die Antwort, die ein Mensch liest.
Normalerweise gibt es beide. Manchmal gibt das Modell sein ganzes Budget fürs Reasoning aus und lässt den content leer: content: "". Auf dem Bildschirm sieht das aus wie „es hat darüber nachgedacht und nichts gesagt“.
Hermes hat genau dafür eine Recovery-Leiter, in dieser Reihenfolge:
- wenn der vorige Turn brauchbaren content hatte, darauf zurückfallen;
- nach einem Tool-Aufruf das Modell einmal anstoßen weiterzumachen;
- wenn Reasoning da ist, aber kein content, eine Erinnerung im Sinne von „schreib die Antwort aus“ senden — bis zu zweimal;
- andernfalls in die normalen Empty-Response-Wiederholungen gehen.
Der Bug steckte in Schritt 3.
Warum der Hinweis verschwand
Der alte Ansatz hängte eine Assistant-Prefill-Zeile an, die sinngemäß sagte „du hast nur nachgedacht“, damit das Modell sich mitten im Gedanken sieht und weitermacht.
Für sich genommen vernünftig. Aber dieselbe Codebasis hat eine zweite Regel: der Sanitizer beim Senden verwirft Assistant-Turns, die Reasoning, aber keinen sichtbaren content enthalten, genau damit diese leeren Turns keinen Kontext verschwenden.
Die beiden Regeln kollidierten. Die Prefill-Zeile wurde verworfen, bevor die Anfrage rausging, also war die ausgehende Anfrage byte-identisch mit der, die gerade fehlgeschlagen war: gleiche messages, gleiche Länge, gleicher Hash. Bei gleicher Eingabe tat das Modell dasselbe — nachdenken und nichts sagen. Sechsmal, dann aufgeben.
Die Messung im Bericht ist deutlich:
| Vorher | Nachher | |
|---|---|---|
| Anfragen ans Hauptmodell | 6 | 2 |
| Unterschiedliche Request-Bodies (sha der messages) | 1, e39cd0d3bcfd × 6 |
2 |
| Endgültige Antwort | „diesmal keine Antwort, auch nach Wiederholungen“ | eine echte Antwort |
| In den Verlauf geschriebene Zeilen | synthetische leere Zeilen ergänzt | Verlauf unverändert |
Der Bericht kam von einem Nutzer auf Discord: lokales LM Studio mit einer Qwen-Variante, Heartbeats zeigten klar „Thinking-only response — prefilling to continue (1/2)(2/2)“, dann drei „Empty response“-Wiederholungen und die Meldung, dass keine Antwort kam — bei sechs Anfragen mit identischer Eingabegröße.
Der Fix: der Hinweis lebt nur auf der ausgehenden Kopie
Der Ansatz ist sauber, und ein Satz fasst ihn zusammen: Recovery-Hinweise existieren nur auf der ausgehenden Kopie, nie im Verlauf.
Konkret:
- die Erinnerung („du hast nur nachgedacht — antworte jetzt“) und der Anstoß nach dem Tool-Aufruf werden an die ausgehende Kopie der letzten User-Nachricht oder des Tool-Ergebnisses angehängt;
- gespeicherter Verlauf, das frühere Cache-Präfix und die SQLite-Zeilen bleiben unberührt, ein Retry sprengt also nicht mehr den prompt cache;
- der Hinweis wird gelöscht, wenn eine Antwort ankommt, beim Finalisieren und beim nächsten Turn;
- der Anstoß nach dem Tool-Aufruf schreibt keine synthetischen leeren Assistant-/User-Zeilen mehr in den Live-Verlauf;
- wenn ein Tool-Aufruf tatsächlich gelandet ist, wird das Thinking-Retry-Budget zurückgesetzt, ohne von einer Prefill-Zeile abzuhängen.
Eine weitere Änderung macht die Diagnose leichter. Die Retry-Warnung sagte früher „kein content oder Reasoning“, auch wenn das Modell klar nachgedacht hatte — was Leute in die LM-Studio-Einstellungen schickt. Jetzt sagt sie reasoning but no visible content.
Der Code liegt in agent/turn_empty_response.py, also genau die oben beschriebene Leiter: prüfen, ob voriger content vorhanden ist, prüfen, ob ein Tool lief, prüfen, ob strukturierte Reasoning-Felder existieren — inklusive des Ollama-Falls, in dem <think> im content steckt — und erst dann in die normalen Retries fallen.
Was das für dich ändert
Bei einem lokalen Modell ist der direkte Gewinn Zeit und Wärme: sechs identische Anfragen werden zwei, und die zweite produziert meist die Antwort. Bei einem abgerechneten Provider ist das echtes Geld — niemand gibt dir Rabatt dafür, dieselbe Anfrage erneut zu schicken.
Der zweite Gewinn ist ein sauberer Verlauf. Die alten Retries schoben synthetische leere Zeilen in die Unterhaltung; in langen Sessions sammeln die sich an, und sie stören Kompaktierung und Cache-Treffer. Jetzt hält der Verlauf nur fest, was tatsächlich passiert ist.
Der dritte Gewinn ist ein kürzerer Debugging-Weg. Das Log sagt nicht mehr etwas zugleich Wahres und Nutzloses. reasoning but no visible content sagt dir, dass das Modell denkt und nicht schreibt; du justierst das Ausgabebudget oder den prompt, statt die Toolchain zu verdächtigen.
Zwei verwandte Einstellungen sind gut zu kennen: gib lokalen Modellen genug Ausgabebudget (oder senke den Reasoning-Aufwand um eine Stufe), wenn das weiter passiert, und wenn lange Sessions weiter an diese Kanten stoßen, decken unsere früheren Beiträge dazu, wie der schlanke Tail komprimiert wird und wie das Kontextfenster-Label gewählt wird, dieselbe Familie von Kontextmanagement-Problemen ab.
Wann es noch passieren kann
Ehrlich zum Umfang: der Fix macht aus „immer sechs“ ein „meist zwei“, aber er ändert nicht die zugrunde liegende Tatsache, dass ein Modell weiterhin nachdenken kann, ohne zu schreiben. Behoben ist, wie wir erneut fragen, nicht warum es hängt. Letzteres hängt vom Modell ab, von der Quantisierung, vom Ausgabebudget und vom prompt.
Wenn du also diese Logs siehst:
- wenn eine Erinnerung zur Erholung reicht, funktioniert der Fix — weitermachen;
- wenn es bei demselben prompt jedes Mal passiert, ändere den prompt oder das Ausgabebudget;
- wenn es auch kein Reasoning gibt (das Log sagt kein content und kein Reasoning), ist das ein anderes Problem: Modell oder Transport haben gar nichts zurückgegeben.
Der Fix wurde aus einem Community-PR gerettet (ursprüngliche Autorschaft bleibt) samt einer Korrektur der Log-Formulierung und wurde am 10. November in main gemergt, nach dem Schnitt von v0.23.1 – er ist also noch in keinem Release; folge main, um ihn jetzt zu nutzen. Vollständige Notizen auf der v0.23.1-Release-Seite, und die andere Hälfte dieses Patches in dem Beitrag zum Katalog-Limit.