Modelos locais que pensam mas nunca falam: de onde vieram aquelas seis requisições idênticas
Você está rodando um modelo local no notebook. O hardware é modesto, mas dá conta. Em alguma tarefa ele pensa por um bom tempo, a linha de status pisca pelos estados de raciocínio e então — nada. Sem resposta, sem erro, só um aviso de que o modelo não produziu resposta desta vez, nem depois das tentativas. Você abre o log e vê seis requisições de tamanho idêntico, como se algo tivesse travado no mesmo lugar.
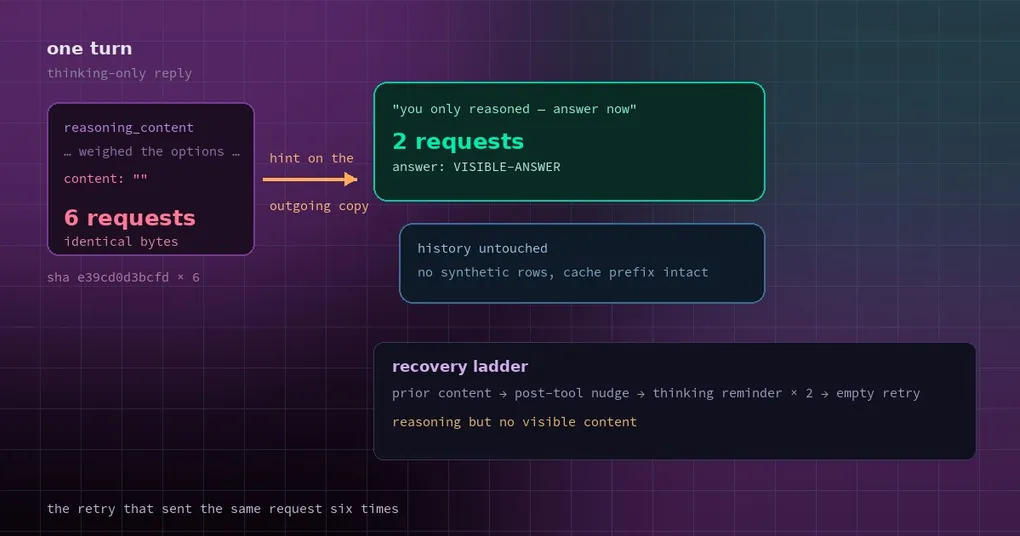
O modelo não é burro e a sua máquina não é lenta demais. É uma contradição dentro do caminho de recuperação: o Hermes ficava tentando lembrar o modelo de falar, mas esse lembrete era apagado por um sanitizador antes de sair do processo. Seis tentativas, seis requisições idênticas byte a byte, seis decisões idênticas do modelo.
A correção está na main, mas não na v0.23.1: ela espera a próxima release. Vale entender três coisas: por que um modelo de raciocínio produz raciocínio sem content, por que o lembrete sumiu e o que esperar agora.
Uma resposta com raciocínio e sem content
Comece pelo formato da saída. Muitos modelos de raciocínio locais (a família Qwen, alguns modelos do Ollama, qualquer coisa com canal de raciocínio no LM Studio) dividem a resposta em duas partes:
- a parte de raciocínio —
reasoning_content, ou um bloco<think>que algumas implementações colocam direto no content; - a parte de content — a resposta que uma pessoa lê.
Normalmente as duas existem. Às vezes o modelo gasta todo o orçamento raciocinando e deixa o content vazio: content: "". Na tela isso parece “pensou no assunto e não disse nada”.
O Hermes tem uma escada de recuperação exatamente para isso, nesta ordem:
- se o turno anterior tinha content aproveitável, usar ele como reserva;
- depois de uma chamada de ferramenta, dar um empurrão no modelo uma vez para continuar;
- quando há raciocínio mas não há content, enviar um lembrete do tipo “escreva a resposta” — até duas vezes;
- caso contrário, entrar nas tentativas normais de resposta vazia.
O bug estava no passo 3.
Por que o lembrete sumiu
A abordagem antiga acrescentava uma linha de prefill de assistant dizendo, em resumo, “você só raciocinou”, para o modelo se enxergar no meio do pensamento e continuar.
Razoável por si só. Mas a mesma base de código tem outra regra: o sanitizador de envio descarta turnos de assistant que contêm raciocínio mas nenhum content visível, justamente para que esses turnos vazios não desperdicem contexto.
As duas regras colidiram. A linha de prefill era descartada antes de a requisição sair, então a requisição enviada era idêntica byte a byte à que acabara de falhar: mesmos messages, mesmo tamanho, mesmo hash. Diante da mesma entrada, o modelo fez a mesma coisa: raciocinou e não disse nada. Seis vezes, e então desistiu.
A medição do relatório é direta:
| Antes | Depois | |
|---|---|---|
| Requisições ao modelo principal | 6 | 2 |
| Corpos de requisição distintos (sha dos messages) | 1, e39cd0d3bcfd × 6 |
2 |
| Resposta final | “sem resposta desta vez, nem depois das tentativas” | uma resposta de verdade |
| Linhas gravadas no histórico | linhas vazias sintéticas acrescentadas | histórico inalterado |
O relatório veio de um usuário no Discord: LM Studio local com uma variante do Qwen, heartbeats mostrando claramente “Thinking-only response — prefilling to continue (1/2)(2/2)”, depois três tentativas de “Empty response” e o aviso de que não houve resposta, com seis requisições de tamanho de entrada idêntico.
A correção: o aviso vive só na cópia de saída
A abordagem é limpa, e uma frase resume: avisos de recuperação existem apenas na cópia enviada, nunca no histórico.
Na prática:
- o lembrete (“você só raciocinou — responda agora”) e o empurrão pós-ferramenta são acrescentados à cópia enviada da última mensagem de usuário ou do último resultado de ferramenta;
- o histórico gravado, o prefixo de cache anterior e as linhas do SQLite ficam intactos, então uma nova tentativa não estoura mais o prompt cache;
- o aviso é limpo quando chega uma resposta, no fechamento do turno e no turno seguinte;
- o empurrão pós-ferramenta não grava mais linhas vazias sintéticas de assistant/usuário no histórico vivo;
- se uma chamada de ferramenta realmente aconteceu, o orçamento de tentativas de raciocínio é reiniciado sem depender de uma linha de prefill.
Uma mudança a mais facilita o diagnóstico. O aviso de nova tentativa dizia “sem content nem raciocínio” mesmo quando o modelo tinha raciocinado com clareza — o que manda as pessoas caçar nas configurações do LM Studio. Agora ele diz reasoning but no visible content.
O código está em agent/turn_empty_response.py, que é exatamente a escada descrita acima: verificar se há content anterior, verificar se uma ferramenta rodou, verificar se existem campos de raciocínio estruturados — incluindo o caso do Ollama em que <think> fica dentro do content — e só então cair nas tentativas normais.
O que isso muda para você
Num modelo local, o ganho direto é tempo e calor: seis requisições idênticas viram duas, e a segunda normalmente entrega a resposta. Num provider cobrado por uso, isso é dinheiro de verdade — ninguém dá desconto por reenviar a mesma requisição.
O segundo ganho é um histórico limpo. As tentativas antigas empurravam linhas vazias sintéticas para a conversa; em sessões longas elas se acumulam e atrapalham a compactação e os acertos de cache. Agora o histórico registra só o que de fato aconteceu.
O terceiro ganho é um caminho de depuração mais curto. O log não diz mais algo verdadeiro e inútil ao mesmo tempo. reasoning but no visible content avisa que o modelo está pensando e não escrevendo; você ajusta o orçamento de saída ou o prompt em vez de desconfiar da cadeia de ferramentas.
Dois ajustes relacionados valem a pena conhecer: dê aos modelos locais orçamento de saída suficiente (ou baixe um nível o esforço de raciocínio) se isso continuar acontecendo, e se sessões longas seguirem esbarrando nesses limites, nossos textos anteriores sobre como a cauda enxuta é comprimida e como o rótulo da janela de contexto é escolhido cobrem a mesma família de problemas de gestão de contexto.
Quando ainda pode acontecer
Sendo honesto sobre o alcance: a correção transforma “sempre seis” em “normalmente duas”, mas não muda o fato de base de que um modelo ainda pode raciocinar sem escrever. O que foi corrigido é como pedimos de novo, não por que ele trava. Isso depende do modelo, da quantização, do orçamento de saída e do prompt.
Então, quando você vir esses logs:
- se um único lembrete basta para recuperar, a correção está funcionando — siga em frente;
- se acontece com o mesmo prompt toda vez, mude o prompt ou o orçamento de saída;
- se também não há raciocínio (o log diz que não há content nem raciocínio), é outro problema: o modelo ou o transporte não devolveram nada.
A correção foi resgatada de um PR da comunidade (a autoria original é preservada), com um acerto na redação do log, e entrou na main em 10 de novembro, depois do corte da v0.23.1, então ainda não está em nenhuma release; acompanhe a main para usar agora. Notas completas na página da versão v0.23.1, e a outra metade deste patch em o texto sobre o teto do catálogo.