Cette fenêtre de contexte de 128K n'est peut-être qu'une supposition — Hermes le dit désormais
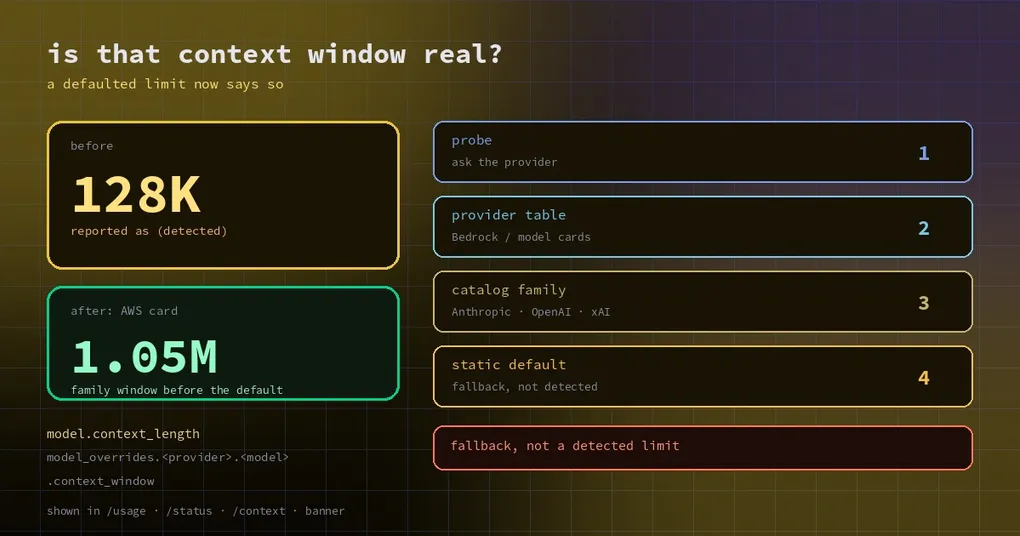
Vous essayez un nouveau modèle sur Bedrock, et Hermes affiche ctx 128K dans la barre de statut. Vous vous basez dessus : une question transversale dans un dépôt de trente mille tokens. À mi-réponse, il commence à compresser l’historique. Vous vérifiez ensuite la fiche du modèle chez le fournisseur : la fenêtre fait 1 050 000 tokens — huit fois ce qu’on vous avait annoncé.
Pire, l’étiquette à côté de ce chiffre disait « détecté ». Cela ressemblait à un fait. C’était une valeur par défaut.
Un seul chiffre décide de trois choses
Une fenêtre de contexte n’est pas décorative. Elle décide du moment où l’historique est compressé, de la quantité de matière qui tient dans un prompt, et du comportement de la récupération après débordement. Sous-estimez-la et la compression se déclenche trop tôt : les tâches longues perdent la mémoire en plein vol. Surestimez-la et le fournisseur rejette la requête sans appel.
Donc savoir si ce chiffre a été détecté ou deviné n’est pas académique. Cela explique deux symptômes complètement différents.
D’où vient le chiffre
Le résolveur essaie les sources dans l’ordre et s’arrête au premier succès :
- Sonder le fournisseur et prendre la valeur exacte.
- La table statique du fournisseur — sur Bedrock, la table des modèles.
- La fenêtre du catalogue pour la même famille — ce que le catalogue de modèles de Hermes dit de cette famille.
- Une valeur statique par défaut — 128K sur Bedrock, 256K sur la route générique.
L’étape 3 est ce que ce changement ajoute. Avant, un modèle Bedrock absent de la table statique tombait directement de l’étape 2 au défaut de 128K de l’étape 4, même quand le catalogue connaissait déjà la fenêtre de la famille.
Cette étape ne s’applique qu’aux modèles Anthropic, OpenAI et xAI : identifiants bruts, identifiants préfixés par une géo ou par global, et identifiants à l’intérieur d’un ARN de foundation-model ou d’inference-profile. La section suivante explique pourquoi cela s’arrête là.
Ce que « fallback » affirme réellement
Le marqueur n’avance qu’une seule chose : aucune source locale n’a rapporté ce chiffre ; c’est la valeur de repli.
Vous le verrez sur la ligne de session du gateway (formulée « fallback, not a detected limit »), dans /usage, dans la barre de statut large, dans la bannière d’accueil et dans le résumé de changement de /model ; des correctifs de suivi ont étendu la même étiquette à /status et /context. Dans la barre de statut, il apparaît comme un suffixe court.
Ne le confondez pas avec l’autre suffixe : pinned signifie que vous avez fixé la valeur vous-même, fallback signifie que le système a pris un défaut. Ni l’un ni l’autre ne signifie que le fournisseur l’a dit.
Le marqueur ne fait que des lectures locales, échoue en mode ouvert et ne sonde jamais : il ne peut donc pas ralentir la barre de statut. Il enregistre par profile home, modèle et URL de base — ce qui fut l’un des correctifs de suivi : la première implémentation utilisait un mémo de 60 secondes dont la clé excluait le profile home, si bien que le verdict d’un profile pouvait étiqueter la fenêtre d’un autre.
Un cas réel : neuf jours de GPT-6.1 Terra en 128K
Le jour du lancement de Terra (26 octobre), le catalogue de modèles a appris sa fenêtre : 1 050 000. La table Bedrock n’a pas changé, et le résolveur Bedrock ne consulte jamais le catalogue. Résultat : v0.22.6, v0.22.7 et main résolvaient tous Terra sur Bedrock à 128K — et la compression démarre à 75 % de la fenêtre, soit 96K.
Après le correctif, un modèle Bedrock d’Anthropic, OpenAI ou xAI que la table statique ne liste pas encore prend la fenêtre de sa famille dans le catalogue avant que le défaut de 128K s’applique. Terra récupère 1 050 000, et GPT-5.4 aussi. L’identifiant Terra brut a également gagné un routage : sa fiche du modèle liste Mantle comme seul endpoint pour cette forme.
Pourquoi seulement ces trois fournisseurs ? Parce que leurs lignes de catalogue correspondent de près à leurs fiches Bedrock : sur 34 fiches, 27 sont égales, 6 sont en dessous et 1 au-dessus. La seule ligne au-dessus est GPT-6.1 Sol (1 050 000 dans le catalogue contre une fiche à 1M), et elle a sa propre ligne de table, qui l’emporte.
Les autres fournisseurs ne peuvent pas être empruntés de cette façon. Leurs lignes de catalogue sont des fenêtres en accès direct chez le fournisseur, qui peuvent dépasser ce que Bedrock sert : Llama 3 8B a une fiche à 8K alors que la ligne llama annonce 131 072 ; Qwen3 32B a une fiche à 32K alors que la ligne qwen annonce 131 072. Emprunter ces valeurs échangerait une compression précoce contre une requête que le fournisseur rejette.
Pourquoi le défaut ne passe pas simplement au million
La suggestion revient : les nouveaux modèles sont énormes, alors montons le plancher à 1M. La réponse est dans une centaine de fiches de modèles texte Bedrock : 32 sont ≥1M, mais 36 sont ≤128K et 8 se situent en dessous (Llama 3 8B/70B à 8K ; Mistral 7B, Mixtral, Small et Large 2402 à 32K ; Qwen3 32B à 32K ; Palmyra Vision à 4K).
Un plancher à 1M enverrait à ces modèles des requêtes 8 à 250 fois trop grosses. La réponse de Bedrock à une charge surdimensionnée n’aide pas : un InternalServerException opaque, ou « Input is too long for requested model. ». La récupération après débordement n’adopte qu’une limite que l’erreur cite réellement ; sans chiffre dans le message, il n’y a rien à corriger — le tour se compresse et échoue de nouveau à chaque requête.
Le défaut reste donc à 128K et c’est la fenêtre de famille qui prend en charge les nouveaux modèles : ceux qui atteignent vraiment le défaut sont les nouvelles sorties frontier, et celles-ci arrivent d’abord dans le catalogue.
Voici l’ensemble des fiches contrôlé avant et après :
| égal à la fiche | sous la fiche | au-dessus de la fiche | |
|---|---|---|---|
| avant | 55 | 37 | 8 |
| après | 77 | 15 | 8 |
Les 8 lignes « au-dessus » sont toutes des fiches sous 128K qui atteignent le défaut ; ce changement les laisse tranquilles.
Le fixer vous-même
Il n’y a pas de nouvelle clé de config — les overrides sont les mêmes qu’avant. Fixez-en une globalement :
model:
  context_length: 200000
Ou surchargez par fournisseur et par modèle :
model_overrides:
  bedrock:
    us.openai.gpt-6.1-terra:
      context_window: 1050000
La forme générique est identique : sous model_overrides, le fournisseur d’abord, puis le modèle, puis context_window.
Une valeur fixée prime sur un fallback et s’affiche comme pinned plutôt que fallback. Si vous changez de modèle ou de route dans le gateway, le pin configuré est abandonné en premier, pour que le chiffre d’une ancienne fenêtre ne se retrouve jamais à côté du nom d’un nouveau modèle.
Comment savoir si votre chiffre est fiable
Une vérification en quatre étapes :
- Cherchez
fallbackaprès le chiffre dans/usage,/statusou/context. - S’il est là, consultez la fiche du modèle ou la doc du fournisseur pour la vraie fenêtre.
- Fixez-la avec
model_overridesune fois que vous la connaissez. - Confirmez la direction par les symptômes : une compression bien plus tôt que prévu signifie que le chiffre est trop petit ; des requêtes rejetées qui mentionnent la longueur d’entrée signifient qu’il est trop grand.
C’est arrivé sur main le 4 novembre, après le point de release v0.22.7, donc ce n’est pas encore dans une release à l’heure où ces lignes sont écrites — la prochaine version l’embarque.
Pour creuser d’un cran, l’article sur l’usage du contexte et les ancres traite de la conservation des bonnes informations à travers la compression, le guide de compression lean-tail explique comment rendre l’historique moins coûteux à garder, et l’article sur les défauts de fenêtre de contexte Codex montre le même mécanisme depuis un autre point d’entrée.