你看到的 128K 上下文窗口,可能只是猜的:Hermes 现在会把话说清楚
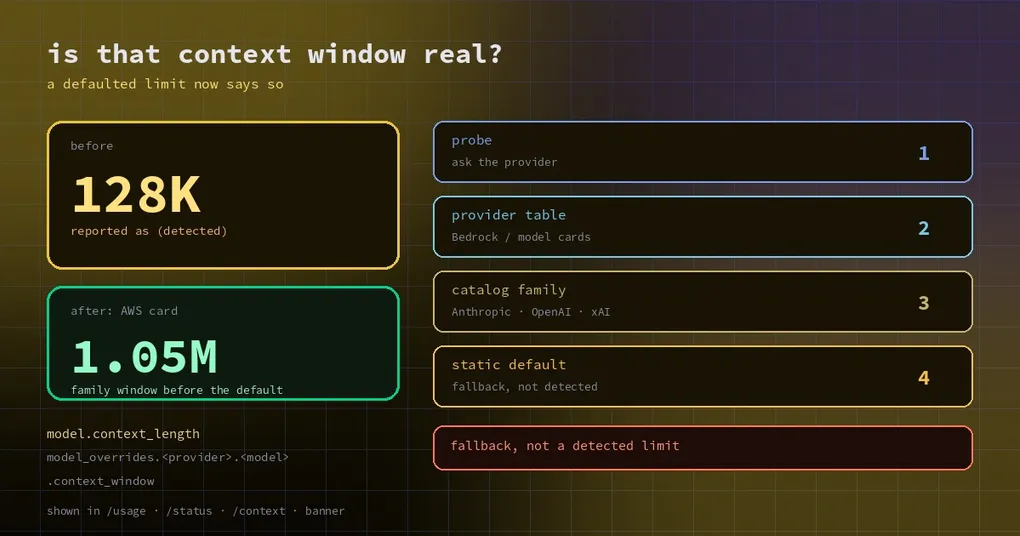
你在 Bedrock 上试一个新模型,Hermes 的状态栏写着 ctx 128K。你照着这个数字行事:往一个三万 token 的仓库里问一个跨文件的问题,结果它回答到一半就开始压缩历史。回头翻 AWS 的模型卡才发现,这个模型的窗口是 1,050,000 token —— 差了八倍。
更麻烦的是当时那句话写的是“检测到的”。看起来是事实,其实只是一个默认值。
一个数字决定三件事
上下文窗口不只是一个展示用的数字。它决定:什么时候开始压缩历史、一次能塞多少文件进提示词、以及溢出之后怎么恢复。窗口被低估,压缩就来得太早,长任务中途失忆;窗口被高估,请求会被服务商直接拒掉。
所以“这个数字是探测到的,还是猜的”不是学术问题。它能解释两种完全不同的症状。
这个数字是从哪来的
解析器按顺序试几个来源,命中就停:
- 探测:真的问一次服务商,拿到确切值。
- 服务商静态表:比如 Bedrock 维护的那张模型表。
- 目录里同家族的窗口:同一个模型家族在 Hermes 模型目录里的窗口值。
- 静态默认值:Bedrock 是 128K,通用路由是 256K。
第 3 步是这次新补上的一层。在此之前,Bedrock 上一个还没进静态表的新模型会直接从第 2 步掉到第 4 步的 128K,哪怕模型目录里明明写着同家族的窗口。
而且这一层只对 Anthropic、OpenAI、xAI 三家的模型生效——无论模型 ID 是裸的、带 geo 或 global 前缀的,还是包在 foundation-model 或 inference-profile ARN 里的。原因在下一节。
“fallback” 这两个字是什么意思
新标注只表达一件事:这个数字不是任何本地来源报告给你的,它是兜底值。
会出现这个词的地方包括网关的会话行(措辞是“fallback, not a detected limit”,即兜底、不是探测到的上限)、/usage、宽版状态栏、欢迎横幅、/model 切换摘要,后续修复又补上了 /status 和 /context。状态栏里它显示为一个短后缀。
它和另一个后缀要区分开:pinned 是你自己用配置钉住的值,fallback 是系统兜底的值。两个都不等于“服务商亲口说的”。
标注本身只做本地读取,失败时放行,从不发起探测,所以不会拖慢状态栏;它按“profile 家目录 + 模型 + base_url”记录,多 profile 并行时不会串味。这条是后续修复的重点之一:最初的实现用了一个 60 秒缓存,键里没带 profile 家目录,结果一个 profile 的判断会给另一个 profile 的窗口贴上标签。
一个真实案例:GPT-6.1 Terra 被当成 128K 的九天
Terra 发布当天(10 月 26 日),模型目录里加了它的窗口:1,050,000。但 Bedrock 的静态表没动,而 Bedrock 的解析器根本不查模型目录。于是 v0.22.6、v0.22.7 和 main 都把 Terra 在 Bedrock 上解析成 128K —— 压缩阈值取窗口的 75%,也就是 96K 就开始压。
修复后,Bedrock 上属于 Anthropic、OpenAI、xAI 的模型如果在静态表里查不到,会先取同家族的目录窗口,再落到 128K 默认值。Terra 现在拿回 1,050,000,GPT-5.4 同样。裸 ID 的 Terra 也补上了路由:它的模型卡只列了 Mantle 这个端点。
为什么只对这三家开放这一层?因为它们的目录行和 Bedrock 卡片基本对得上:34 张卡里 27 张相等、6 张低于、1 张高于。唯一偏高的那张是 GPT-6.1 Sol(目录 1,050,000,卡片 1M),而它自己在静态表里有行,表行优先。
其他厂商不能这么借。它们的目录窗口是“厂商直连”的窗口,可能大于 Bedrock 实际提供的:Llama 3 8B 卡片写 8K,而 llama 目录行是 131,072;Qwen3 32B 卡片写 32K,而 qwen 目录行是 131,072。借过来就等于把一个“过早压缩”的问题,换成一个“请求太大被拒”的问题。
为什么默认值不干脆调到一百万
有人提过这个方向:既然新模型动辄上百万,索性把兜底抬到 1M。答案在一百张 Bedrock 文本模型卡里:32 张 ≥1M,但 36 张 ≤128K,还有 8 张更低(Llama 3 8B/70B 是 8K,Mistral 7B、Mixtral、Small、Large 2402 是 32K,Qwen3 32B 是 32K,Palmyra Vision 是 4K)。
1M 的兜底会让这些模型收到大 8 到 250 倍的请求。而 Bedrock 对超大 payload 的回应很不友好:一个不带数字的 InternalServerException,或者一句“Input is too long for requested model.”。溢出恢复只会采纳错误里明确报出的窗口数字,报不出来就无从修正 —— 结果是每一轮都压缩、每一轮都失败。
所以默认值留在 128K,改用“家族窗口兜底”来救新模型:真正会踩到默认值的,基本都是刚发布的前沿模型,而它们会先进模型目录。
修复前后对着卡片核了一遍的结果:
| 与卡片相等 | 低于卡片 | 高于卡片 | |
|---|---|---|---|
| 修复前 | 55 | 37 | 8 |
| 修复后 | 77 | 15 | 8 |
那 8 个“高于卡片”的全是卡片本身低于 128K、于是命中默认值的模型,这次没有动它们。
你自己怎么改
没有新增配置键,还是老办法,先钉单个模型:
model:
  context_length: 200000
或者按 provider 和模型精确覆盖:
model_overrides:
  bedrock:
    us.openai.gpt-6.1-terra:
      context_window: 1050000
通用 provider 同理:model_overrides 下面先 provider、再模型,最后是 context_window。
钉住的值优先于兜底值,界面上会显示 pinned 而不是 fallback。如果你在网关里切了模型或路由,配置的钉子会先被摘掉,避免旧窗口的数字配新模型的名字。
怎么判断你现在这个数字靠不靠谱
一个四步的检查顺序:
- 在
/usage、/status、/context里看这个数字后面有没有fallback。 - 有的话,去模型卡或服务商文档查真实窗口。
- 查到了就用
model_overrides钉住。 - 对照症状确认方向:压缩比预期早很多,说明数字偏小;请求被拒且错误里提到输入过长,说明数字偏大。
这批改动 11 月 4 日合并进 main,晚于 v0.22.7 的发布点,写这篇时还没进正式版本。等下一版更新即可。
想再往下挖一层,站内的上下文用量与锚点那篇讲压缩之后如何保住关键信息,压缩瘦尾指南讲怎么让历史留得更值钱;如果你跑的是 Codex 一类的模型,上下文窗口默认值那篇是同一套机制的另一个入口。